0%

2024 开源操作系统训练营第一阶段总结-刘梓陆

本来想在这里放一个图片的,但是看群里好像图片不太好处理,那就不放了

不过在这里贴一个图片仓库链接:ServiceLogos,作者画得太好看,导致我当天看到就去印贴纸了……

写在前面

我从稍微理解了我的专业之后就一直都很崇拜 Linus,这位堪称传奇的软件工程师在 1991 年 8 月 25 日——他 21 岁时就在网络上发布了 Linux 内核的源代码。现在是 2024 年 4 月 23 日,我也是 21 岁,追逐吗,梦想吗,我也想像他一样写出这样神奇的代码,33 年后的今天,我也要开始了,Linus。

欢迎交流;-)

在写这篇博客时,本人东北大学大三在读,前两年东学西学,Rust 就是之一,说实话,在本学期开始时,我实在找不到什么东西来做,准备先买一本《趣读 Linux 源码》来看,感谢我学弟翊嘉,是他给我推荐了这个操作系统训练营,这样直接上手操作系统的效果比看书要好太多了,真的十分感谢!

我对 Rust 的理解还是比较少,future、unsafe 的内容更是知之甚少,所以大佬求带!看到我这篇总结报告之中有什么不足也请指出!

Rust,很好玩

这一阶段的练习基本上带领我加强了一遍 Rust 的语法,因为我接触 Rust 已经有小半年了,所以对我来说并不算很困难(如果要我 0 基础开始的话可能就会有点受不了了)。话虽如此, rustlings 确实给了我很多细节上的考验,我通过了它们,查缺补漏,学到了很多新东西(这里就当错题集一题一题记录了 XD):

2024_4_24, PS:因为这一个阶段基本上都是一些对 Rust 语法概念上的训练,所以我会着重讲一下对 Rust 一些重要语法概念的理解,本来写了挺多的,但是后面全部都删掉了,因为突然发现我好像也就是鹦鹉学舌,纯纯就是一些对官方文档还有论坛讨论的翻译,所以我会在讲到一个我觉得值得注意的点的时候把链接贴出来,然后提一下这个链接讲了什么,同学们自己去看会好的多

2024_4_25, PS:感觉讲的有点乱了,实际上 Rust 之中的移动、生命周期、所有权的概念真的是耦合在一起的,在讲到一个部分的时候免不了要带一点其它两个部分。

1. ♿ 移动 ♿ 和借用, options3.rs 之中犯的错误

说实话,移动和所有权这个语意在其他语言里面确实存在,但是一般作为规范存在,没有在 Rust 里面管的这么严,在 options3.rs 之中我就犯了这么一个错误:

我在 main 函数之中这样写道:

1
2
3
4
5
6
7
let y: Option<Point> = Some(Point { x: 100, y: 200 });

match y {
Some(p) => println!("Co-ordinates are {},{} ", p.x, p.y),
_ => panic!("no match!"),
}
y;

这样写会报错(value used here after partial move),因为在最后返回 y 之前 Some(p)就已经把外面 y 的所有权移动到 p 上了,此时 y 指向的是一个无效的内存空间。所以现在的解决方案就是把外面 y 借用到 Some(p)之中,一个关键字 ref 可以帮助我们做到这一点。这个关键字其实用法还是挺多的,一般用于模式匹配:

下面是一段在《Rust 编程指南》之中的阐述(在第 10 章 Pattern 小节 Refrence Patterns 部分之中,如果你看的是英文版的 PDF 的话,在 P372 可以找到对这个问题的详细描述):

Rust 的模式匹配支持处理引用的两个特性:Ref 模式借用匹配值的一部分,&模式匹配引用

我个人感觉可以这样理解:Rust 之中的模式匹配就像是在匹配一个正则表达式,&被理解位一个字面值字符,如果写&的话,就会把&引用的那个值“解离”出来,因为匹配了前面的一个&,自然就是匹配后面的这个“值”了。

呃,我又要引用《Rust 编程指南》之中的原话了(毕竟真的这本书很专业)

In an expression, & creates a reference.I a pattern, & matches a refrence

在一个表达式之中,&创造一个引用,在模式之中,&匹配一个引用

当时我也是被震撼,确实有一种对称的美对吧?其实在 rustlings 对应的有关模式匹配训练之中你就可以发现这一点:你可以使用()来创建一个元组,可以使用{}来创建一个结构体,当然就可以使用对应包含()和{}的模式匹配来把其中对应的字段解析出来,_这是一个互逆的过程_,我觉得这一点需要好好注意一下,基本上就是模式匹配直观意义上的精髓所在了。

但是 ref更像是一个正则表达式之中的元字符,用于描述匹配规则:我只想要借用匹配的值,而不是移动它们,如果想要借出可变引用的话就要使用ref mut。所以这里这样改改,加一个ref就成功了:

1
2
3
4
match y {
Some(ref p) => println!("Co-ordinates are {},{} ", p.x, p.y),
_ => panic!("no match!"),
}

当然,如果匹配的数据实现了Copetrait 的话,你怎么样搞都行,但是在处理有所有权的对象的时候就必须小心处理了,这 Rust 真给我好好上了一课。

1.1 讲点更复杂的怎么样?

在下一部分我想要讲讲我对生命周期和所有权的理解,所以在这里我想先就着这个例子好好借题发挥,先铺垫一下。

实际上options3.rs还能出得更加复杂一点,这种情况就要把ref和&同时用上才能解决。在options3.rs之中,该结构体之中的两个成员都是实现了Copytrait 的,那么如果有具有所有权的成员的话,应该如何处理呢?

就像是下面这种情况(实际上你可以在《Rust 程序设计》的 P374 找到它):

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
struct Engine {
version: String,
}

struct Car {
engine: Engine,
}

fn main() {
let borrowed_car: Option<&Car> = Some(&Car {
engine: Engine {
version: String::from("混合动力"),
},
});

match borrowed_car {
Some(&Car { engine }) => {
println!("I got the engine!");
}
None => {
println!("noting here");
}
}
}

如果你像上面这样写的话就好像是把一辆借来的车里头的引擎偷出来了。Rust 会降下它的神罚,引导我们做出正确的选择:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
error[E0507]: cannot move out of `borrowed_car.engine` as enum variant `Some` which is behind a shared reference
--> src/main.rs:16:11
|
16 | match borrowed_car {
| ^^^^^^^^^^^^
17 | Some(&Car { engine }) => {
| ------
| |
| data moved here
| move occurs because `engine` has type `Engine`, which does not implement the `Copy` trait
|
help: consider borrowing the pattern binding
|
17 | Some(&Car { ref engine }) => {
| +++

这里忍不住想要夸一下,Rust 的错误输出真的是太好了!

所以既然车是借的,引擎也应该是借的对不对?这里使用 ref 来把引擎借出来就没事了。

1.2 Temporary lifetime,什么时候会销毁?

实际上假如你修正了上面这个ref的问题仍然会报错,😭 了:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
error[E0716]: temporary value dropped while borrowed
--> src/main.rs:10:44
|
10 | let borrowed_car: Option<&Car> = Some(&Car {
| ____________________________________________^
11 | | engine: Engine {
12 | | version: String::from("混合动力"),
13 | | },
14 | | });
| | ^ - temporary value is freed at the end of this statement
| |_____|
| creates a temporary value which is freed while still in use
15 |
16 | match borrowed_car {
| ------------ borrow later used here
|
help: consider using a `let` binding to create a longer lived value
|
10 ~ let binding = Car {
11 + engine: Engine {
12 ~ version: String::from("混合动力"),
13 + },
14 + };
15 ~ let borrowed_car: Option<&Car> = Some(&binding);
|

这里涉及到一个比较微观的问题:Rust 在背后为我们做了的事。实际上很多时候我们创建的变量的生命周期就只是一个局限于语句(statement)的 temporary lifetime,Rust 为我们做了 lifetime extention 之后才能在 block 之中使用。

在论述这个问题之前,先列一下参考文献吧:

  • 1《Temporary lifetimes》
    • 强烈建议先看这一篇,这是 Rust 开发小组的一次会议纪要,讲了现在 Rust 之中 Temporary lifetimes 的一些情况,在 Rust2024 之中要改进哪一部分,讲的比较通俗,例子也好很多
  • 2《Place Expressions and value Expressions》
    • 这篇 RustRefrence 文档之中讲到了 Rust 之中表达式的分类(类似于 C++之中的左值和右值)
  • 3《Temporary scopes》
    • 这篇文档之中谈到了我之前没有听说过的作用域 Temporary scope,我的理解就是立即值(右值)的一个小作用域
  • 4《Temporary lifetime extension》
    • 这篇文档之中讲到了 Temporary 作用域的提升,也就是为什么说一个 Temporary scopes 在进行赋值等操作之后可以将本来很小的作用域延展到和被赋予值的变量作用域相同的情况

上面这些概念之间的关系就是: The temporary scope of an expression is the scope that is used for the temporary variable that holds the result of that expression when used in a place context。(摘自文献 3)

注意这里的三个关键词:temporary scope、temporary variable 和 place context

处于位置上下文(place context)的表达式就是位置表达式,它代表了一个内存位置(Paths)。这些表达式是局部变量、静态变量、解引用(*expr)表达式、数组索引表达式(expr[expr])、字段引用(expr.f)和括号内的位置表达式(parenthesized place expressions)

突然感觉这里举一个例子会比较好:

1
let t = &foo();

实际上是:

1
2
let tmp;
let t = { tmp = foo(); &tmp };

也就是说,&foo()是一个表达式,现在它处于一个位置上下文之中(&需要一个位置),所以现在需要一个 temporary variable(简称 temporary)来存储这个foo()表达式的结果,也就是上面的tmp,这个tmp的生命周期就是 temporary scope。

而且在这里还做了一个 lifetime-extension:如果没有 let 的话,实际上 temporary 在语句的末尾(遇到;)就会被销毁:

1
&foo();

实际上是

1
2
3
4
{
let tmp;
tmp = &foo();
}

这个立即失效的局部变量显然不符合用户的意图。因此,我们延长 temporary 的生命周期,使其在最内层块的末尾被删除(the end of the innermost block)。

实际上就是把原来局限于语句的生命周期提升了一个一个层次,提升到块了。

怎么样,是不是原来好像很理所当然的一段代码都变得不那么简单了?更多有关这部分概念的解释请参考文献 1,我在这里就不赘述了。


回到在本小节一开始提出的问题,为啥会报错?其实看报错信息就知道了,按照我们上面的思路来思考:

首先,里面这个表达式处于一个位置上下文(place context)之中,因为&期待一个位置,所以得有一个 temporary 来保存这个位置啊:

1
2
3
4
5
6
7
8
9
{
let tmp;
tmp = Car {
engine: Engine {
version: String::from("混合动力"),
},
};
&tmp
}

但是很不幸的是,这个 temporary 首先作用于 Some,而不是 let,所以不会进行 lifetime-extension,在遇到;之后,temporary 就被 drop 掉了。

出现了,悬垂引用!Rust 就 panic 了。(本节完)

2. 🌿 生命周期和所有权 🌿 - 光的波粒二象性?

“光的波粒二象性”这个比喻是油管的一个博主 ledoo 提出来的。

我觉得讲的真的很不错,所以在这里想提一提。

大概就是说,我们讲到生命周期(lifetime)就是总是从代码层面去分析对不对?去看是不是你变量的第一次声明和最后一次使用跨越了一个 block,但是实际上 Rust 做这个生命周期是为了检查内存的有效性的,你还可以从变量指向内存的位置和保证内存的有效性这两个角度来理解生命周期。(Thinking about lifetime as regions of memory, what can they——the reference point to?)

这就好像是光的波粒二象性一样,有的时候从这个角度去看比较好理解,有的时候从另外一个角度去看则更佳。 我个人觉得用这种角度去理解生命周期标注是最好的。

就拿 lifetimes1.rs 为例吧:

实际上他视频里面就有讲这个很经典的生命周期标注问题

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
fn longest(x: &str, y: &str) -> &str {
if x.len() > y.len() {
x
} else {
y
}
}

fn main() {
let string1 = String::from("abcd");
let string2 = "xyz";

let result = longest(string1.as_str(), string2);
println!("The longest string is '{}'", result);
}

这道题的正确答案应该是这样:

1
2
3
4
5
6
7
fn longest<'a>(x: &'a str, y: &'a str) -> &'a str {
if x.len() > y.len() {
x
} else {
y
}
}

加上生命周期标注,生命标注在我初学 Rust 的时候把我虐的死去活来的,你比如说这里的'a,为什么大家都是标'a?是不是意味着所有传入的 reference 的生命周期都要是相同的?什么?返回值的生命周期也是'a?三个都要相同?啊?这限制也太严格了把?

当然,如果你读过像是 Rust 圣经的文档话,文档里面就会告诉你:实际上呢,这里的意思是以生命周期最小的那个 Reference 为准,不过呢……总感觉怪怪的。

如果你使用指向有效内存的角度来进行分析的话,我感觉就会比较好一点:

x 指向一块内存 memory_x,y 也指向一块内存 memory_y,这两块内存当然可以是不一样的,返回值也指向一块内存,那么在这里'a的作用就是说,我要统一这两块内存,返回值指向memory_x“和”memory_y。这里“和”打双引号,因为现实不可能同时指向两部分嘛。

所以 Rust 怎么检查这个返回值是否有效?答案是在这个返回值最后一次使用之前这两块内存memory_x和memory_y都要有效。

如果使用生命周期约束的话,差不多也是这个意思,比如说'a: 'b比较官方的说法就是'a的生命周期的范围必须包含或等于'b的生命周期的范围。

假如我们使用“内存说”的话,就刚刚好反过来,'b指向的内存包含了'a指向的内存,所以'b有效的时候'a也一定要有效,所以你可以这样读这个限界:'a in 'b。

嗯,大概就是这样。(本节完)

写在最后

首先,感谢你看到这里!

本来还想写一些 unsafe 还有 cargo 的内容的,但是没有时间了!!!!!唉,期中了,我还有 ddl 要赶呢,在这篇博客之中写的生命周期、所有权、移动的概念(话说好像都在讲生命周期)我认为就是 Rust 的核心了,所以对于第一部分的 Rust 编程学习,内容分量应该也刚刚好吧?(小小的虚荣一下,把我在第一部分之中讲的那个车和引擎的问题出成题感觉也 ٩(•̤̀ᵕ•̤́๑)ᵒᵏᵎᵎᵎᵎ?)

所以我准备移动一下,在第二阶段的报告里面把 unsafe、cargo 连着操作系统讲一下,如果你觉得从我的这篇报告学到了什么东西的话,那就太好了!

2024 年 04 月 25 日 21:14:31
初始rcore

第一次知道rcore来源于一篇知乎的帖子,当时沉迷于操作系统的学习,希望能写出一个自己的操作系统。但当时网络上更多的是对xv6的赞赏,rcore的仅仅是一句简单的提及。受限于当时初学计算机,只知语言C,不识Rust,不希望投入太多精力到语言的学习,因此并未细探rcore究竟。(当然,三分钟热度的我最后也没写完一个操作系统,希望这次能够完善地学完!)

直到去年了解到这个开源操作系统训练营,加上自学了rust的基础语法,对其很有兴趣。可惜秋冬季已经结营,加上网站上模糊的教学视频实在难以学习,便又戛然而止。直至今年四月初至,又闻开营之事(别问,问就是大数据推送),喜从心中来,急急忙忙地就上了船。

第一阶段总结

第一阶段主要是熟悉rust语法,前三十道题进展迅速,仅涉及简单语法;中间几十道题中,所有权和生命周期单列出来较为简单,但是复杂场景中的所有权问题令人头疼;最后几道算法题,除去算法本身的难度,rust对于所有权和借用的限制才是最大的难点,以至于最后纯粹是与编译器斗智斗勇,几乎快忘了实现逻辑和复杂度。

除此之外,有多道题目在完成过程中总是不解其意,仅仅是让其通过检测。知道提交通过之后,看到群友们的讨论才恍然大悟,但又懒于修改,还是默默学习的新的内容去吧。

个人介绍

本人就读于新加坡南洋理工大学,参加这个夏令营的目的是为了弥补本科时候的遗憾。在本科期间,听说了AI多么高大上,挣钱多么多,于是把目标放在了AI方向,任何的课程和科研都是围绕着AI方向。但是后面大四发现实在是卷论文卷不动了,而且其实干的很多事情都是调参,找一组好的参数发论文,这并不是我想要的生活,也不是想干的方向。于是我开始想试试开发,因为传统开发上面我毫无经验和优势,于是便去学习小众的区块链开发,发现了Rust这门宝藏语言。顺利的学习这门语言,好好读书背八股找到了大厂的工作(今年入职),但是其实操作系统等底层的知识,在本科上课的时候都是糊弄过去的,所以一直有这个遗憾。借着这个夏令营的机会,我的目标是一阶段巩固一下Rust细节知识,为后面转向区块链开发做铺垫(参加过Solana链相关的黑客松),第二个是真正的非纸上谈兵地去用喜欢的Rust语言做一下操作系统相关的开发,希望可以坚持到最后。

一阶段学习感悟——对Rust的一些感想

Rust 是一种安全的系统编程语言,它为程序员提供了实现安全的途径,而无需担心所有的实现细节。所以这里的动机是,基本上C++是不安全的。这也是 Rust 出现的原因。
这里的安全性指的是,如果你用Rust编写了一个程序,并且它满足了某些条件,那么当你将该程序编译成汇编程序时,就可以保证汇编程序不会出错。编译器和类型系统保证了这一点。与此同时,它还实现了控制,因为它支持编程中所需的所有底层功能,例如操作系统的构建,目前Linux和Windows中的系统内核中很多部分都用Rust进行了重构。尤其是C和C++在编写并发程序的时候,无法自动检测到内存的不安全性,而Rust的所有权和生命周期抓住了并发的本质,其本质上关于安全的共享资源。
下面讨论一下系统编程里面的内存模型。我认为一个编程语言,尤其是系统编程语言,或者说比较低级别的编程语言中间最重要的实际上有两件事儿,一个就是它的内存模型,或者说你的变量在内存中是如何交互的和如何表示的。另一个就是多线程的事情,就是多个线程如何操作这些内存。
首先在系统编程领域唯三的编程语言,就是C,C++和Rust。因为Rust它实际上是有很多比较新的理念,可以视为它从C++中间去抽取了很多比较精华的部分,并且它又长出来自己独有的一些东西。
因为C++里面的特性非常多,而且有很多很复杂很融坠,很多还是由于历史原因造成的。因为 C++非常强调兼容性,所以他以前的一些设计的问题,它是没有办法在未来改变的,它只能把它保留或者是把它遮蔽起来。就像你有堆垃圾,你没有办法倒到外面,你只能拿被子先盖起来,然后在这个垃圾上面去建立一些新的东西,所以很多人都觉得C++不如C语言使用起来那样舒服。那么从Rust角度来讲的话,它就没有这个历史负担,它出现的比较晚,所以他从不管从C还是从C++,还是从 Python等等其他的语言中去抽取了很多好的东西集成起来。从整体上来看的话,共性化的部分肯定是各个语言都比较重要的部分,个性化的部分的话,Rust的部分的好处多于坏,它的坏处主要是它的带来的额外的编程和编译的复杂性。

给第一周做一个总结

  • 参加这个lab的起初目的有两个:一是有可能会有实习机会,但是现在看到这么多大佬估计也挺难了哈,二是想考研408,加深自己对于操作系统的理解。另外可以丰富自己的项目知识的积累,过去一个星期了,发现自己的这个选择真是无比的正确,在学校待的两年发现什么实操都不会,学到了很多工具的使用(非常感激群里的大佬们的帮助),并且在学习的过程中也对rust产生了浓厚的兴趣,非常想去学习。
  • 第一周在学习rust的语法,主要是跟着B站的一个up主(软件工艺师)在学习,讲解的非常的好,而且没有废话,很细节,结合rust中文圣经补充一些知识。
  • 不过没学多久就准备蓝桥杯了,刚好学到生命周期那个部分,在第一周做rustlings写到48题,刷到现在感到收获很大,深刻体会到要学会一门语言是要多加练习的。
  • 接触到rust的语言之后,我对它产生了浓厚的兴趣,虽然这门语言很难,但是也很有趣,思想也很先进,不同于初学python时不用敲代码就可以掌握,学习rust经常一个语法要写好几遍才堪堪掌握。
  • 比较开心的是,学完了trait和生命周期,这两个点大家都说难,但是我认为比较好理解,看来我果然还是很有天赋的吧哈哈哈哈哈哈哈哈!!!
  • 好吧,这也没什么要记录的了,群里很多大佬在第一二天就已经将rustlings写完,而我连github还没整明白,在第二周补补知识,把rustlings写完(话说这个博客提交又要研究一个晚上了wuwuwu)。
  • 参考的rust语言圣经:https://course.rs/basic/compound-type/string-slice.html
  • 讲解的超棒的B站视频:【Rust编程语言入门教程(Rust语言/Rust权威指南配套)【已完结】-哔哩哔哩】 https://b23.tv/AaXsgZd

第二周

  • 这一周一开始把rust剩下的智能指针,多线程,闭包等全部学完了,但是直到开始写剩下的rustlings时,才发现实际写起来困难重重,经过反复的查阅官方文档以及GPT的帮助之下,才弄懂了接下来的题。
  • 但是到了algorithm的十道题,每啃一道都会花费不少的时间,需要反复检查所有权和trait的使用,
  • 建议还是反复多练习才能更好的掌握,这次新增的这十道算法题也确实帮助我更好的打好了基础。
  • 最后,非常感谢能有机会参加这次活动,希望在第二阶段可以有更多收获,同时也为社区回馈更多。

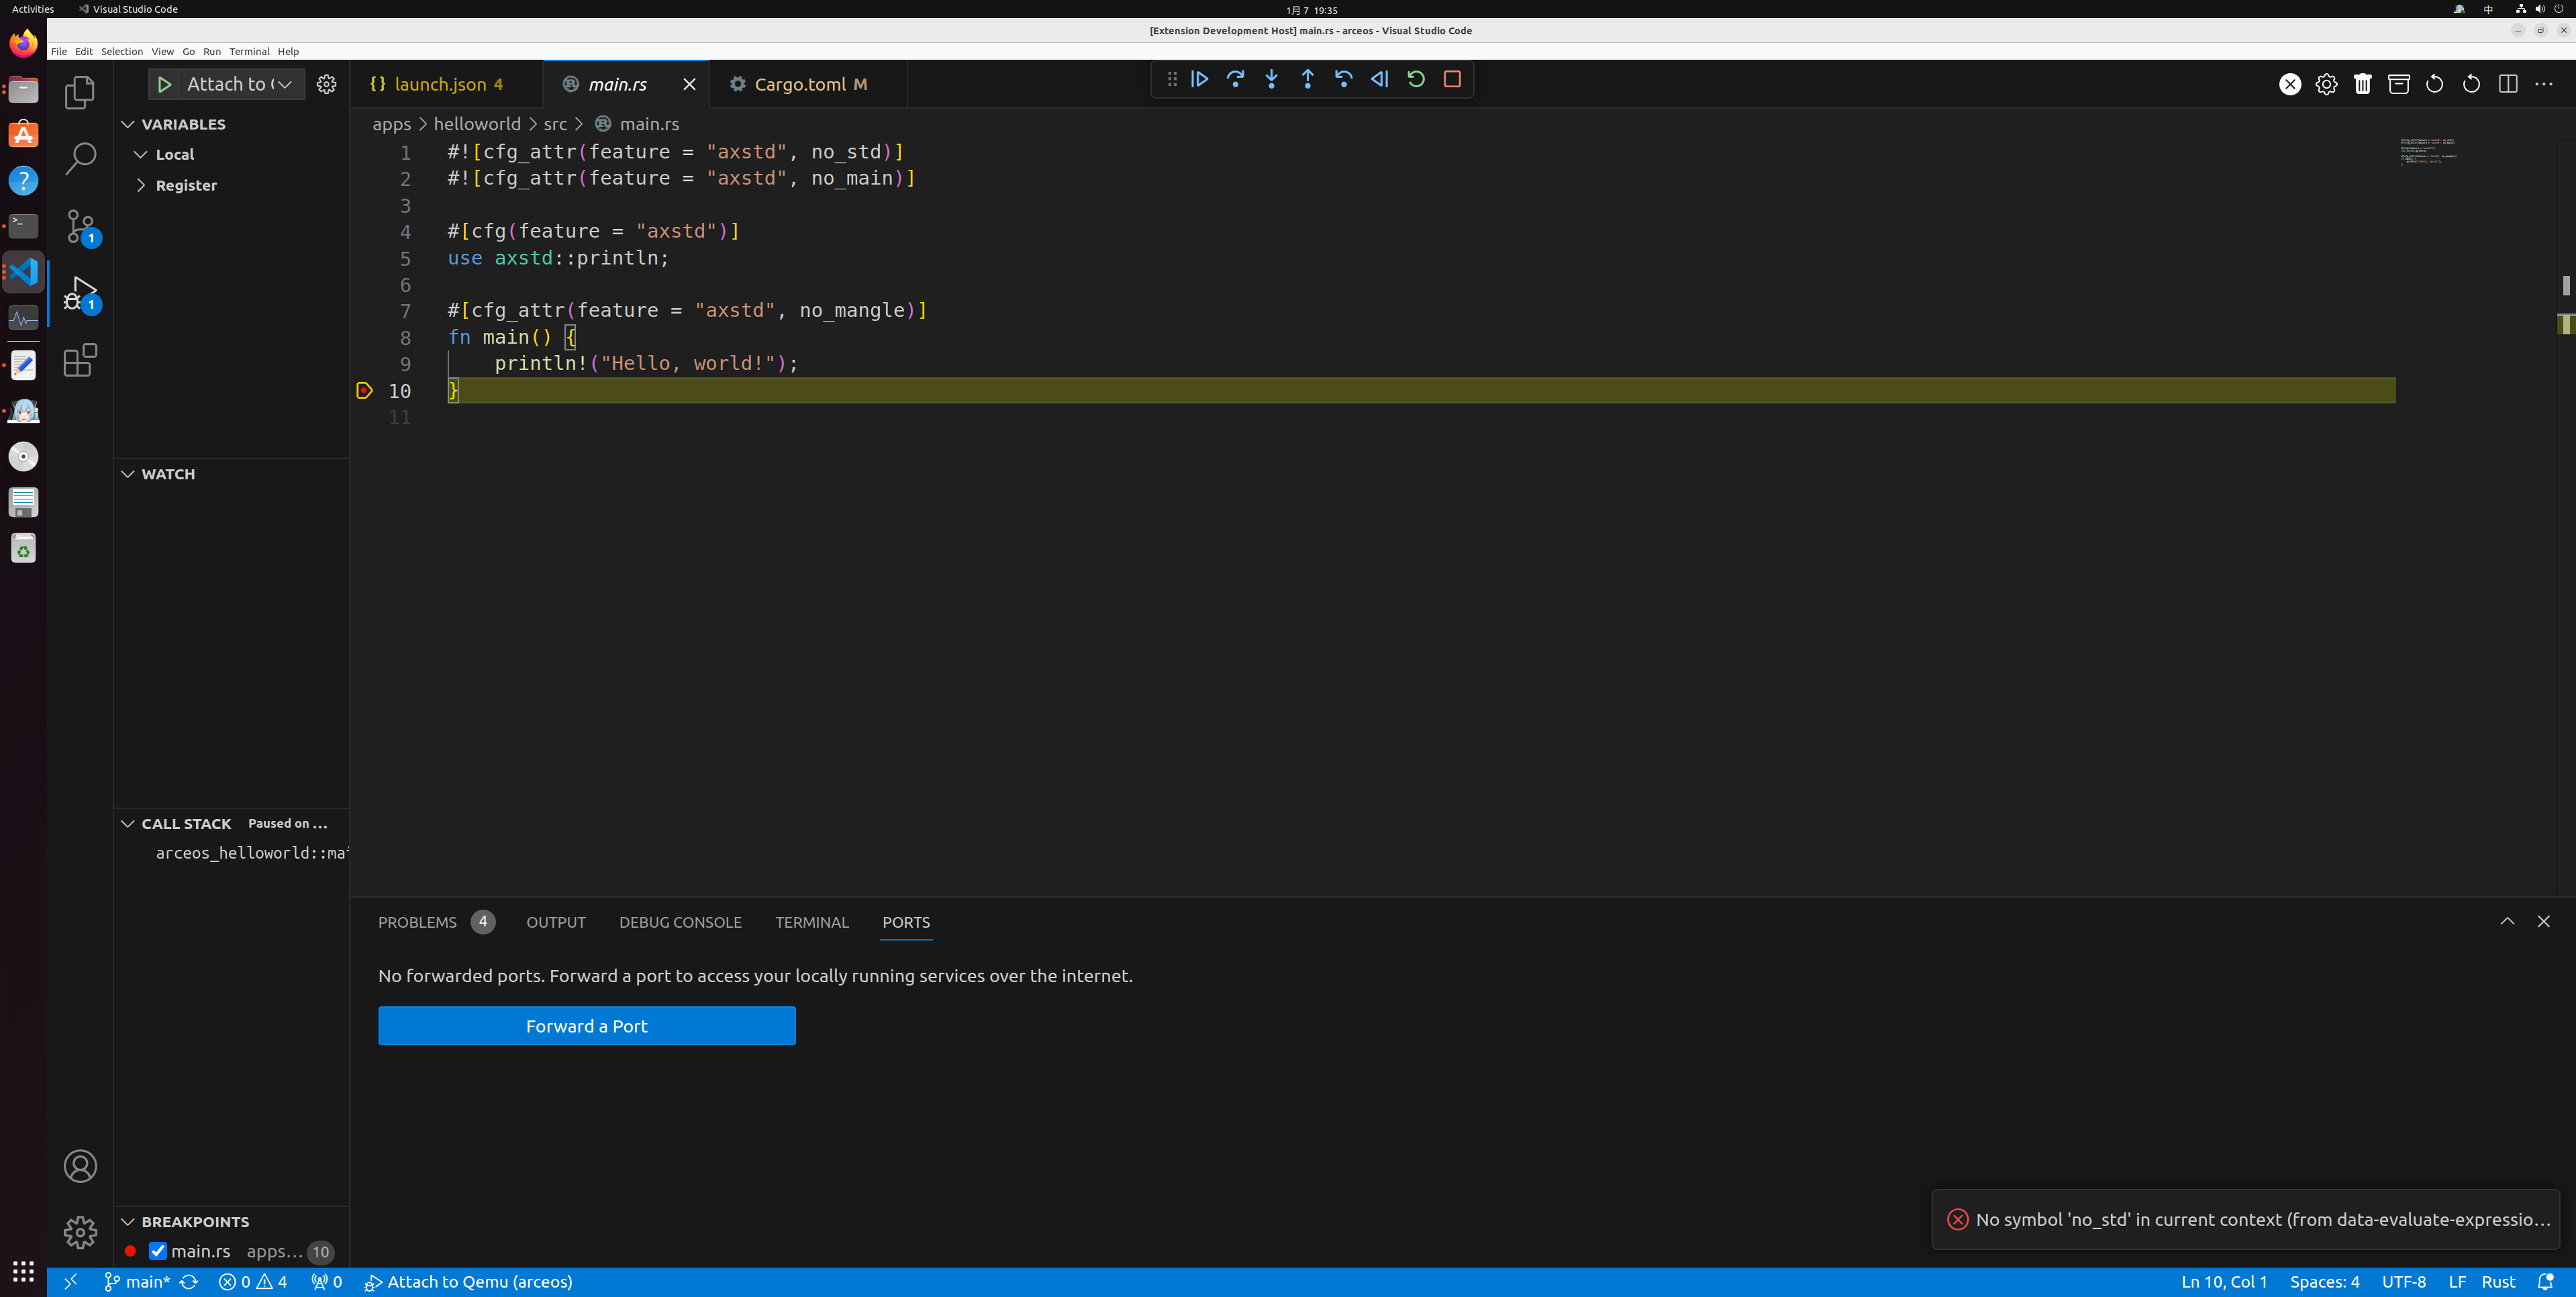
code-debug是一个支持跨特权级调试的VSCode插件。在这篇文章中,我将介绍利用这个调试插件在VSCode上对ArceOS进行源代码级调试的过程。

首先我们需要下载 gdb-multiarch :

1
sudo apt install gdb-multiarch

接着我们运行一下 ArceOS,从而生成 bin 和 elf 文件. 这里以RISC-V上的单核arceos-helloworld为例:

1
make A=apps/helloworld/ ARCH=riscv64 LOG=info SMP=1 run

在 ArceOS 的输出中,我们发现了 QEMU的启动参数:

1
qemu-system-riscv64 -m 128M -smp 1 -machine virt -bios default -kernel apps/helloworld//helloworld_riscv64-qemu-virt.bin -nographic

我们将这些启动参数转移到配置文件 launch.json 中:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
   //launch.json
{
"version": "0.2.0",
"configurations": [
{
"type": "gdb",
"request": "launch",
"name": "Attach to Qemu",
"executable": "${userHome}/arceos/apps/helloworld/helloworld_riscv64-qemu-virt.elf",
"target": ":1234",
"remote": true,
"cwd": "${workspaceRoot}",
"valuesFormatting": "parseText",
"gdbpath": "gdb-multiarch",
"showDevDebugOutput":true,
"internalConsoleOptions": "openOnSessionStart",
"printCalls": true,
"stopAtConnect": true,
"qemuPath": "qemu-system-riscv64",
"qemuArgs": [
"-M",
"128m",
"-smp",
"1",
"-machine",
"virt",
"-bios",
"default",
"-kernel",
"apps/helloworld/helloworld_riscv64-qemu-virt.bin",
"-nographic",
"-s",
"-S"
],

"KERNEL_IN_BREAKPOINTS_LINE":65, // src/trap/mod.rs中内核入口行号。可能要修改
"KERNEL_OUT_BREAKPOINTS_LINE":124, // src/trap/mod.rs中内核出口行号。可能要修改
"GO_TO_KERNEL_LINE":30, // src/trap/mod.rs中,用于从用户态返回内核的断点行号。在rCore-Tutorial-v3中,这是set_user_trap_entry函数中的stvec::write(TRAMPOLINE as usize, TrapMode::Direct);语句。
},
]
}

我们在qemuArgs中添加了 -s -S 参数,这样qemu在启动的时候会打开gdb调试功能并且停在第一条指令处,方便我们设置断点.

此外,应当注意executable参数指向包含符号表的elf文件,而不是去除符号表后的bin文件。

由于ArceOS是unikernel,没有用到用户态,因此以下这三个参数不需要填写:

1
2
3
"KERNEL_IN_BREAKPOINTS_LINE":65, // src/trap/mod.rs中内核入口行号。可能要修改
"KERNEL_OUT_BREAKPOINTS_LINE":124, // src/trap/mod.rs中内核出口行号。可能要修改
"GO_TO_KERNEL_LINE":30, // src/trap/mod.rs中,用于从用户态返回内核的断点行号。在rCore-Tutorial-v3中,这是set_user_trap_entry函数中的stvec::write(TRAMPOLINE as usize, TrapMode::Direct);语句。

最后我们再次按f5开始调试ArceOS. 我们发现Qemu虚拟机启动,ArceOS停在了第一条指令

1
oslab@oslab:~/arceos$  qemu-system-riscv64 -M 128m -smp 1 -machine virt -bios default -kernel apps/helloworld/helloworld_riscv64-qemu-virt.bin -nographic -s -S

接下来我们设置断点。比如我们在Hello, World输出语句打一个断点,然后按”▶️”.我们会发现断点触发了:

以上,通过一些简单的设置,我们就得以用code-debug调试器插件调试一个新OS.

Unikernel 学习心得

近期学习了一些关于Unikernel的知识,以下是一些心得体会:

  • Unikernel是基于组件化的思想设计的,由各种模块构成组件,再由各种组件构成最终的操作系统。
  • 而对于各种模块是如何被选择的,则是采用feature机制,指定最终所需要的模块

ArceOS实验

  • 这周进行了ArceOS的三个实验,在练习一中学习了用println!进行彩色打印。练习二主要学会了对ArceOS进行扩展开发,在axstd中加入了Hashmap,在axhal模块中加入rng生成器,初步了解了ArceOS的调用结构。
  • 练习三修改了axalloc模块中allocator的算法,改为early算法,同时用lock()和unimplemented!()禁用其他算法

学习流程

第一天的接触就是修改CI/CD的错误,我的认知里面是写构建的yml文件,实际上是需要解决starry跑在x86的问题,第一天就大概看了starry的设计文档了解了它和arceos的承接关系和相关的模块图,于是在和杨金博同学沟通后对编译选项和copy.S的代码进行了x86的改造之后发现pci等还有问题,于是问题交到金博哥手里,这时候进行了unikernel的学习,石磊老师ppt讲解和训练营的录课大概看过之后对unikernel有了大概的认识,之后就边处理strace那边的数据边学习和做lab。

进展

目前在做第三周的实验的lab1,将c程序的镜像打包到文件系统实现了,目前对hello的报错进行修改,目前的思考是hello的命令行参数处理有问题,需要内核提供支持,目前定位到的代码如下

1
2
3
4
5
6
7
8
9
10
11
if let Some(app_inode) = open_file(path.as_str(), OpenFlags::WRONLY) {
let all_data = app_inode.read_all();
let process = current_process();
let argc = args_vec.len();
process.exec(all_data.as_slice(), args_vec);
// return argc because cx.x[10] will be covered with it later
println!("exec argc is {}", argc as isize);
argc as isize
} else {
-1
}

执行后可在shell中看到初始为0执行hello程序后为1但是此时的参数处理是输出了argc为0的错误输出,目前在继续看代码准备把后续都尽快跑通。

#Unikernel 总结报告

经过若干天关于unikernel的学习,对于单一特权级的操作系统有了全新认识完成了练习1-5,练习分别为:支持彩色打印、支持HashMap、修改内存分配算法、增加一个axdtb的模块组件、修改fifo算法通过ex5测试应用

练习心得

练习了修改代码、不断检错纠错能力和熟悉了unikernel启动流程、单一特权级、单一应用、单一地址空间的操作系统的工作流程、练习一完成了axstd::println的修改、练习二;通过阅读标准库HashMap加以修改、连续三实现earlyallocator的内存分配方法、修改协作式调度为抢占式调度运行ex5程序、

##实验心得

实验一和二,将程序数据按照一定格式保存到app.bin文件中修改汇编指令,加载外部应用,实现app loader的外部应用加载器;实验三为公国ABI调用ArceOS功能,两个医用一个是nop、一个是wfi;实验四、实现sys_hello和sys_putchar、sys_terminate功能调用,通过std::process::exit退出ArceOS;实验五为改造应用hello_app,建立独立页表,把系统调用包装成函数,通过初始化和切换函数实现程序

本次主要采用是通过类似于在GNU/LD链接器的方式来完成整个任务。主要的参照依据是csapp中有关链接的相关说明。
目前的实际完成进度在于完成了符号的解析。但是后面的重定包括段重定位以及符号的重定位,目前还没有完成。

目前操作上来说,对于后续任务影响最大的内容在于之前任务的不正确完成,包括但不限于之前任务中埋藏的坑,比如说文件不能正确识别,将 1B 认定成为 一个16进制数而导致对于加载的文件中的align的错误判断,甚至还将用于解释rust内部结构体的自动align用于解释这里所出现的人为导致的align。

由于其他因素的影响,我在前半段时间其实没有过多的参与到其中来,近几天才加入到课题中。在参加课题之前其实对于libc,musl,甚至是elf文件没有什么过多的了解。简单的了解了下整个过程,本来看了下还想先直接用ld将对应的库链接好之后再放到arceos上读取(这是郝淼同学的实现思路),但是想到在 ld 将各种对象文件链接起来之后,实际上最后在使用的时候还是需要调用链接器 [–dynamic-linker可以指定对应链接器的地址] (当时实际上没想到可以直接实现链接器最后被调用的功能)。后面就按照实现一个链接器的想法继续实验。

目前主要使用 elf crates 实现了如下效果:

  1. 能够对于脚本中的符号进行重定位
    目前对于重定位的操作实现尚未完成,根据要求,每一步实现实际上都需要遍历多次,更别提最原始的实现中由于对象文件的顺序引起的问题可能也需要往复遍历,正在尝试优化算法以及修改elf crates使之有着更好的体验。

未来工作可能没有特别大的必要开展,原因如下,在相同情况下,就算最终能够实现了一个能够在arceos上运行的链接器也是没有必要的。

  1. 现有的基于GNU/LD的链接器可以比较好的行使其职能,重复实现一个实际上没有必要实现的链接器会丢失原先所实现的优化,同时因为测试相对于前者而言更少,反而可能会导致更多错误,然而在这种实现的链接器面前,除非同时支持大量的编译工具,否则意义实际上不太大,只能算是个展示玩具。

/// BLUE PRINT
///
/// 1. LOAD APPLICATION
/// 2. SYMBOL RESOLUTION: make sure all symbol has been meet.
/// 3. RELOCATION:
/// [1] RELOCATION SECTION:
/// merges all sections of the same type into a new aggregate section of the same typecombine
/// BC we only need SHT_PROGBITS thus not care about others (copy).
/// [2] RELOCATE SYMBOL REFERENCES IN SECTIONS:
/// Modify references to each symbol in code and data sections so that they point to the correct run-time address

下面的伪代码实际完成了符号加载工作,重定向部分的代码还没有开始实际测试,就算未来有按照这个方法实现的必要,类似郝淼同学重新实现 elf crates 甚至在原先基础上进行修改的行为是必要的,现有的调用过程太长,使用起来不太舒服。

直接通过 shdr.e_type 实现对于符号的定位,根据CSAPP的说明,使用多个集合对于符号进行处理,实现符号匹配效果

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
match ehdr.e_type {
ET_REL => { //
foreach symtabs {
if sym.is_undefined() {
// 加入 U 未定义符号组
} else {|
// 加入 D 已解析符号组
}
}
// 加入总管辖 elf 文件组 TODO 目前只实现了添加,并没有实现基于往复判断的剪枝
},
ET_DYN => {
foreach symbol in U {
if contains undefined symbols {
// 从 U 未定义符号组删除本符号
// 加入 D 已解析符号组
// 加入总管辖 elf 文件组 TODO 目前只实现了添加,并没有实现基于往复判断的剪枝
}
}
}

}

2023开源操作系统训练营第三阶段项目一总结报告

练习1,2:

该练习实现了一个 app 名为 loader 的外部应用加载器,然后实现了两个外部应用,熟悉了编译生成和封装二进制文件的流程.

该练习的重点在于头结构的构造与实现,我将应用的头结构大致分为三部分,第一部分为应用数量,第二部分为各应用长度,第三部分为应用数据.

大致实现如下

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
type BinNumType = u32;
const BIN_NUM_TYPE_BYTES: usize = 4;
type BinSizeType = u32;
const BIN_SIZE_TYPE_BYTES: usize = 4;
let apps_num = unsafe {
(*(PLASH_START as *const BinNumType)).to_be()
};
let mut size_offset = PLASH_START + BIN_NUM_TYPE_BYTES;
let mut start_offset = size_offset + BIN_SIZE_TYPE_BYTES * apps_num as usize;
for i in 0 .. apps_num {
let load_size = unsafe {
(*(size_offset as *const BinSizeType)).to_be() as usize
};
let load_code = unsafe {
core::slice::from_raw_parts(start_offset as *const u8, load_size)
};
println!("load code {:?}; address [{:?}]", load_code, load_code.as_ptr());
let run_code = unsafe {
core::slice::from_raw_parts_mut(RUN_START as *mut u8, load_size)
};
run_code.copy_from_slice(load_code);
println!("run code {:?}; address [{:?}] size [{}]", run_code, run_code.as_ptr(), load_size);
size_offset += BIN_SIZE_TYPE_BYTES;
start_offset += load_size;
}

下面是构造image文件的大致代码

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
#!/bin/bash
# 获取当前目录下所有的 .bin 文件
apps=(hello_app.bin putd_app.bin)
# 计算应用数量
num_apps=${#apps[@]}
# 创建临时文件用于存储应用大小
size_file="temp_sizes.bin"
> "$size_file"
# 创建一个新的文件用于存储合并后的应用内容
content_file="temp_content.bin"
> "$content_file"
# 写入应用数量(4 字节)
printf "%08x" $num_apps | xxd -r -p > "$size_file"
# 循环遍历每个应用并写入其大小到临时文件
for app in "${apps[@]}"; do
# 获取并写入当前应用大小(4 字节)
app_size=$(stat -c%s "$app")
printf "%08x" $app_size | xxd -r -p >> "$size_file"
# 追加应用内容到另一个临时文件
cat "$app" >> "$content_file"
done
combined_file="combined.bin"
# 合并大小信息和应用内容
cat "$size_file" "$content_file" > "$combined_file"
output_file="apps.bin"
dd if=/dev/zero of="$output_file" bs=1M count=32
dd if="$combined_file" of="$output_file" conv=notrunc
mkdir -p ../arceos/payload
mv "$output_file" ../arceos/payload/apps.bin
# 清理临时文件
rm "$size_file" "$content_file" "$combined_file"
echo "合并完成,输出文件:$output_file"

练习3

本实验较为简单,在原来的基础上修改外部应用的汇编指令以及然后在遍历程序时将其执行即可.

练习4

本实验也比较简单,仿照前面的系统调用写一个即可,关机方法:std::process::exit.

练习5

因为多次系统调用a7寄存器的值会被修改,导致报错,所以我们需要将其存入变量中防止abi_table被修改,而且还要声明clobber_abi(“C”)保持Rust代码与内联汇编之间的一致性.然后在我写的过程中,出现了冒用 in(reg) 和 out(reg) 的错误,导致传入的 ABI 接口的地址导致调用函数的时候接口地址丢失,在第二次调用的访问未映射的地址导致错误发生.

练习6

在练习5的基础上,初始化地址空间以后,对于每一个外部应用调用 RUN_START 前切换地址空间即可.但此时应用并无法正确返回,是因为外部引用主动阻塞导致的,外部应用不能进行阻塞,我们需要修改 _start 函数的返回值为 ();