AI4OSE 期间,我们与 Agent 协作学习各项知识,并且 Agent 出题 讲解 以及 苏格拉底式 的急速学习法。所以最后也有 Agent 自动插入笔记的问题和自己的回答,如果答案不充分,则我的作答还会有 Agent 协调补充的内容。相关提示词:如果我有疏漏,给我补充,且讲解充分后继续向我提问查缺补漏,最后一同沉淀到我们的笔记中!
0%
2025秋冬季OS训练营实习总结报告-PassingThroughStarDust
StarryOS SD/MMC 驱动 3 个月开发技术总结
摘要
本报告记录了我在泉城实验室为期3个月的实习期间,围绕 StarryOS SD 卡驱动展开的主要开发与优化工作。实习期间,我深入分析了原有的 simple-sdmmc 驱动,针对其在功能、性能和兼容性方面的不足,进行了系统性的优化和扩展,最终形成了功能更完善、兼容性更强的 simple-sdmmc-extended 版本。该版本补全和优化了硬件初始化流程与时钟与电源管理,还引入了 DMA(直接内存访问)支持,显著提升了大容量数据传输的效率和系统资源利用率。在驱动开发的同时,我还设计并实现了一个自动化测试框架,用于系统性地验证 SD/MMC 驱动在不同平台和多种极端场景下的功能正确性、性能表现以及平台兼容性。测试框架涵盖了基本功能、性能基准、并发一致性、平台专用等多类测试,能够自动统计吞吐量、IOPS、错误数等关键指标,并输出详细日志,极大提升了驱动开发和回归验证的效率。
1. 项目背景
在 StarryOS 项目早期,为实现对 SD/MMC 存储设备的基本支持,设计并实现了 simple-sdmmc 驱动。该驱动采用了轮询(Polling)方式进行控制器状态检测和数据传输:
- 驱动通过不断轮询硬件寄存器,判断命令是否完成、FIFO 是否可读写、数据传输是否结束等,无需依赖中断。
- 轮询方式实现简单,便于在无操作系统或早期启动阶段使用,适合嵌入式、裸机等资源受限场景。
- 该设计保证了驱动的确定性和可控性,但在高性能或多任务环境下,CPU 占用较高,后续版本逐步引入了 DMA、并发等优化。
2. simple-sdmmc 的优化
2.2 关键优化点
2.2.1 硬件初始化流程完善
具体的工作包括了:
- 时钟管理:
- 明确分步关闭/配置/开启时钟,确保卡片处于稳定状态
- 多次发送
ResetClock命令,保证控制器与卡片同步
- 电源管理:
- 显式设置
PWREN,确保卡片上电
- 显式设置
- 延时与稳定性:
- 延长初始化等待周期,确保卡片在低频下充分稳定
硬件初始化的优化如下:
1 | 优化前: |
2.2.2 DMA 支持与寄存器抽象
具体的工作包括了:
- 新增描述符链数据结构
IdmacDescriptor为 CPU 与 IDMAC 间的数据交换作支持。 - 新增
dma_enabled字段,初始化 IDMAC 控制器。 - 优化寄存器访问抽象,提升代码可维护性与可移植性。
2.2.3 命令与数据传输流程增强
- 将原有 send_cmd 仅用于控制类/非数据命令,数据传输相关命令全部优化为
send_cmd_idmac,实现命令与数据路径分离。 send_cmd_idmac针对 DMA/IDMAC 场景,自动完成物理地址转换、描述符配置、DMA 启动、状态与错误检查等,极大提升了大块数据传输的效率与健壮性。- 两者均增加了详细的超时与状态检查、错误日志,便于定位问题。
- 兼容部分命令(如
GoIdleState)超时非致命的实际情况。
命令与数据传输流程优化前后对比:
1 | 优化前: |
2.3 典型问题与解决方案
2.3.1 U-Boot 遗留状态导致初始化失败
- 现象:U-Boot 预设时钟/宽度,驱动未重置,导致卡片未能正常初始化
- 解决:驱动启动时强制重配时钟、电源、数据宽度,确保硬件状态一致
2.3.2 GoIdleState 超时
- 现象:部分卡片在 CMD0 (GoIdleState) 阶段超时,但后续流程可继续
- 解决:将 CMD0 超时视为可接受,后续命令继续执行
2.3.3 DMA/CPU 模式性能对比
- 通过测试框架对比 DMA 与 CPU 直传模式,量化性能提升
2.4 优化效果
- 驱动在 VisionFive2 等平台下可稳定初始化并识别大容量 SD 卡
- 性能测试显示 DMA 模式下吞吐量显著提升
- 代码结构更清晰,便于后续维护与扩展
3. 测试框架设计与实现
3.1 测试框架描述
整个测试框架存储在 sdmmc-tests 项目中,通过分模块自动化验证 SD/MMC 驱动的各项能力,涵盖基本读写、边界与异常、性能基准、并发一致性、以及平台专用(如 VisionFive2)等多类测试。每类测试包含单块/多块读写、边界块访问、错误注入、顺序与随机性能、DMA/CPU对比、缓存一致性、多线程压力、时钟切换、中断延迟和大容量寻址等典型场景。测试框架会自动统计吞吐量、IOPS、错误数等指标,并输出详细日志,便于定位驱动在不同平台和极端条件下的功能与性能问题。所有测试均可一键批量运行,极大提升了驱动开发和回归验证的效率与可靠性。
3.2 测试分类与功能说明
当前 sdmmc-tests 测试框架将测试分为以下几大类,每类覆盖不同的驱动能力:
基本功能与正确性测试(basic/)
- 单块/多块读写:验证驱动对单个和多个数据块的读写正确性。
- 边界条件:测试首块、末块、分区边界等特殊地址的访问,确保无越界和数据一致性。
- 异常与错误处理:如非法块号、错误缓冲区长度、超时等,验证驱动能否正确检测和报告错误。
性能基准测试(benchmark/)
- 顺序吞吐量:测量大块连续读写的最大带宽。
- 随机访问性能:评估随机读写的 IOPS 和延迟。
- DMA/CPU 模式对比:对比 DMA 直传与 CPU 轮询两种模式下的性能差异,量化 DMA 优势。
并发与一致性测试(concurrency/)
- 缓存一致性:验证 DMA 传输下 CPU 缓存与物理内存的数据一致性,确保写后读、读后写无异常。
- 并发压力:模拟多线程/多任务下的交错读写,检验驱动在高并发场景下的稳定性和正确性。
平台专用测试(visionfive2/)
- SDIO 时钟切换:动态切换多种时钟频率,验证驱动对不同速率的适配能力。
- 中断延迟:测量中断响应时间,评估驱动实时性。
- LBA48 支持:测试大容量卡 (>2TB) 的 48 位寻址能力。
每类测试均配有详细日志和统计信息,便于定位问题和量化性能。
3.3 测试框架设计要点
- 统一的
TestResult/TestError类型,便于错误归类与统计 TestStats支持吞吐量、IOPS 等性能指标自动统计- 详细日志输出,便于定位问题
- 支持特性开关(如
vf2)灵活适配不同硬件
3.4 运行方式
- 可集成于 StarryOS 镜像,在真实硬件或 QEMU 上运行
- 支持独立 cargo 运行,便于 API 层测试
相关仓库
2026春夏季开源操作系统训练营总结
操作系统训练营复盘
序言
我参加过不止一次操作系统训练营,但只有这次真正进入了专业阶段。回头看,这段学习给我最大的提升不是“又多懂了一些概念”,而是理解方式变了:操作系统不再是各种模块的拼装,而更像是对 CPU、内存、设备等物理资源的重新组织与分配——向上管理应用,向下管理资源。
这次训练营的跨度也很大:从 OS 理论与 Rust 基础,到搭建纯粹的 no_std 环境;再到特权级切换、调度、页表;最后在专业阶段落到并发控制、VFS、系统调用等更复杂的系统能力上。
导学阶段
导学阶段我主要跟着课程录像把操作系统体系重新过了一遍,并结合训练营官方指导与 OSTEP 做补充。这个阶段我最重要的收获是:很多章节并不是在讲“技巧”,而是在解释 OS 如何把有限的物理资源做成一种“多路复用的错觉”,让每个进程都觉得自己独占资源。理解到这一层之后,再看内核架构为什么这么演进,会更顺。
第一次在 no_std/裸机环境里做实验时,一些在标准库里理所当然的操作突然变得“不显然”。我印象很深的是终端彩色输出:我原本习惯用 {:?} 快速打印结构体/变量状态,但当我尝试直接写字节序列输出 ANSI 颜色控制码时,屏幕却是一堆乱码。
后来定位到原因:Debug 格式化会把 ANSI 转义字符 \x1b 强制转义成字面量文本(真实字符 \、x、1、b),控制码语义被破坏,终端自然无法解析颜色指令。解决方式很朴素:不要用 {:?},改用 {}(Display),保证原始 0x1B 字节无损进入串口发送寄存器。
基础阶段
基础阶段的任务密度明显上来了:总共需要实现 6 个模块、23 个测试,涉及 no_std 基础设施、并发、特权级切换与调度、页表等多个节点。我这里挑几个对我影响最大的点写一下。
1)no_std 基础设施:内存原语、ecall、堆分配
在没有标准库的情况下,一些基础能力需要自己补齐。我用汇编与内联 Rust 代码手动实现了 memcpy 与 memset,并封装了 ecall 系统调用接口。
动态内存分配方面,我实现了基于 CAS 无锁算法与侵入式链表的 Free-List 分配器,为内核态提供稳定的堆内存支持。
2)特权级切换与调度:上下文切换变得“可触摸”
在特权级切换与进程调度模块里,我更深刻地理解了上下文切换的本质:我利用 RISC‑V 的裸函数属性,手动保存与恢复 32 个通用寄存器以及核心 CSR。在此基础上,我不仅实现了传统线程上下文切换,还进一步实现了运行在用户态的“绿色线程”,用协作式调度与状态机探索轻量级协程的性能边界。
3)和同期同学对照后的一个结论:底层问题放大效应很强
我会把自己的 Debug 记录和同期同学的PR对照着看,感受很明显:应用层的“坏习惯”到了 OS 底层会被成倍放大。比如只顾设计模式而忽略数据流正确性、缺少错误路径测试、试图用大量 unsafe 绕过 Rust 检查器等——在 OS 里往往会直接演变成系统级灾难。
我印象比较深的几类问题与我的处理方式大致是这样:
- 内存分配与回收 :早期简单 Bump 分配器缺乏回收机制,遇到
Vec扩容或动态字符串处理很容易 OOM。针对早期内核初始化,我做过一种折中:设计“双端内存分配”,前端分配小块字节、后端分配整页,并引入一个基于引用计数的全局追踪器;当活动对象计数归零时,直接把字节分配指针重置回基址(b_pos = start)。 - 并发与生命周期 :我踩过一个很隐蔽的“临时值生命周期”坑:链式调用
current().task_ext().aspace.lock()会让current()生成的临时任务引用在语句结束时被 Drop,但lock()得到的 Guard 仍试图借用它,导致编译错误。最终我回到所有权本质:用显式变量绑定let curr = current();延长引用存活期,理清锁与借用对象的层次关系。 - 中断与特权级相关陷阱 :在异常处理里,若不推进
sepc,可能会反复回到同一条触发异常的指令。我的处理里会在必要时手动sepc += 4跳过当前 32 位指令。在simple_hv虚拟机管理程序中,我还遇到过一个规范相关的细节:从 VS 态访问某些 M 级 CSR(如mhartid)触发的并非预期的VirtualInstruction(异常码 22),而是IllegalInstruction(异常码 2)。最后我重写了非法指令处理器:软件解码指令、模拟返回伪造的 CSR 值,并精细管理sepc的演进流。 - no_std 生态缺失 :为了支持更复杂的数据结构,我把
hashbrown引入到自己的axstd模块中,重建哈希集合支持。过程中还触发过nightly-2024-09-03的编译器 ICE:常量泛型参数SIZE与 Trait 关联常量PAGE_SIZE底层符号解析冲突。我通过重命名泛型变量(如改为PAGESZ)从侧面规避了前端缺陷。
SV39 分页 与 TLB“幽灵状态”
如果要选一个最能体现“软硬件协同”且最折磨人的点,我会选虚拟内存分页系统及其与 TLB 的交互。
RISC‑V 的 SV39 使用三级 Radix Tree:虚拟地址拆成 VPN2/VPN1/VPN0+ 12 位页内偏移,MMU 会遍历三级页表完成映射。静态结构很好理解,但真正难的是运行时的硬件状态同步。
我在处理动态内存映射时,逻辑上已经“看起来完美”:分配物理页帧、更新 PTE、设置 V/R/W/X 权限位,然后 sret 返回继续执行。按常理应该成功,但 CPU 会再次抛出同样的缺页异常。
后来我意识到这是典型的 TLB staleness :页表在内存里更新了,但 CPU 内部的 TLB 仍缓存着旧的“该地址无效”记录。解决必须落到指令层:修改页表后,显式向处理器发出同步屏障。在我的逻辑里,只要重写了 hgatp 或更新了关键页表条目,就需要紧接着执行 hfence.gvma,强制刷新相关地址空间的 TLB 项。
专业阶段
专业阶段的变化很明显:复杂度与状态空间开始爆炸。文件系统架构、复杂并发控制、IPC 等问题,逼着我从“写功能”转向“做工程治理与架构取舍”。
在 rCore-Tutorial 的 Chapter 6,我围绕 easy-fs 的文件系统实现做了较多工作,并对其分层有了更清晰的认识:
- 块设备抽象层(
easy-fs/efs.rs) :磁盘布局、inode 位置计算、位图分配与回收等底层逻辑 - VFS 层(
easy-fs/vfs.rs) :目录树遍历、链接、inode 生命周期管理等核心抽象 - 系统调用边界(
os/src/fs/) :将内核对象包装成用户态可用的文件抽象(如文件描述符)
我主要补全了 sys_fstat、sys_linkat、sys_unlinkat。以 linkat 为例,其控制流非常“手术式”:路径遍历 → 校验目标实体/链接名→ 锁定源 inode,对 nlink 原子 +1 并写回磁盘 → 在目标目录追加新的 DirEntry 并强刷缓存。
unlinkat 的反向流程同样复杂,尤其是“删除目录项不产生空间碎片”的问题。我采用的策略是:找到待删除目录项后,将其与目录中最后一个有效目录项交换,然后缩减目录文件 size,保证磁盘空间紧凑;随后递减目标 inode 引用计数,只有当 nlink 降至 0 且系统内无文件描述符占用时,才触发底层数据簇回收。
另外我也处理了一些边界:例如 Stdin/Stdout 属于流式字符设备,缺乏普通磁盘文件的块状元数据;为了避免生成“虚假的 Stat”,我的实现会直接拦截这类请求并 panic!,拒绝伪造元数据。
反思
经历导学、基础、专业三个阶段之后,我最明显的变化是:对“底层原理”的认知从抽象概念变成了可推导的具体原理,我会去思考寄存器怎么变、异常为什么回到同一条指令、TLB 为什么缓存旧结论、并发原语为何在不同调度模型下表现截然不同。
我对 AI 辅助编码的用法
随着AI的迅猛发展,在本次训练营中我也结合AI辅助OS编码,但是我也发现了OS 底层容错率太低,使得我对 AI 的用法也变得更审慎:它可以当手术刀处理局部实现与重复劳动,但不该在宏观架构上自由发挥。我的做法是把它严格约束在可控范围内:
- 全局上下文对齐 :先规定技术边界与可改文件/不可碰结构(唯一事实来源)
- 原子化拆解 :把大需求拆成 3–5 个闭环步骤,每一步都是 MVP,爆炸半径小
- 确定性验证标准 :每一步必须给出明确可验证的测试/日志/行为变化,通过后再做下一步
这套策略在专业阶段帮我避免了“AI 幻觉导致底层数据结构被悄悄破坏”的风险,也提高了推进效率,这也是我在本次训练营中领悟出来的使用技巧。从代码的写作转到审查代码,把控架构,也许我感觉这是能否在Vibe Coding的冲击中站稳脚跟的关键,以操作系统的设计为例,后者更考验对整个复杂系统的掌握,这就驱使着我们要加速脚步增加对知识的汲取。AI Coding 的效率不取决于模型的能力,而是取决于所使用的架构是否支持多工作树低冲突合并;AI 的能力边界也不取决于模型的能力,而是取决于工程过程可被 token 化的范围边界在哪里。
实习总结报告:rknpu技术报告
RKNPU驱动3个月开发技术总结
摘要
本报告记录我在泉城实验室三个月实习期间针对Rockchip RK3588芯片,为其中的NPU构建一套可运行于StarryOS和其它OS上的驱动,覆盖从寄存器映射、DMA缓冲管理、任务描述符组装到多核调度与中断回收的完整链路。核心工作包括三项:三核并行执行路径的设计与实现,使同一批任务可按 lane 分发到不同 NPU core;统一排队调度器,支持多线程共享 NPU 并通过 per-submit waiter 保持阻塞式 ioctl 语义;以及基于 SVD/svd2rust 生成的 rknpu-regs 寄存器访问库,以类型化接口替代裸地址编程。在此基础上,通过四个 benchmark 场景验证了三核算力收益,所有场景均实现正加速
一、项目内容与用途
这个项目的对象是 RK3588 NPU 驱动及其在 StarryOS 上的系统集成。它的作用:让上层推理程序、benchmark 或后续 runtime 能稳定地把任务提交给 NPU 执行,而不是只能依赖 Linux 或闭源用户态库环境。
当前驱动已经覆盖了几条基础链路:
- 寄存器/MMIO 访问:能够映射 RK3588 RKNPU 三个 core 的寄存器窗口,并通过寄存器接口完成 PC、CNA、DPU 等硬件模块的配置。
- GEM/DMA 缓冲管理:支持用户态创建、映射、同步和销毁 NPU 可访问的 DMA buffer。
- 任务描述符组织:支持
RknpuTask、regcmd、输入/权重/输出 buffer 的组合,并把这些描述符作为 submit 的基本执行单元。 - ioctl 服务:支持
Submit、MemCreate、MemMap、MemDestroy、MemSync、Action等 RKNPU 专用入口。 - 中断与 completion 回收:IRQ handler 负责读取硬件完成状态,调度器再根据 core 绑定关系把 completion 还原到具体任务。
- 多核调度:在一个 submit 中按 lane 把任务切到不同 core,同时支持多个 submit 进入队列等待。
二、本轮二次开发重点
2.1 支持 RK3588 三核 NPU 执行
RK3588 的 RKNPU 不是单个执行核心,而是三个可以并行工作的 NPU core。早期单核路径只证明了“任务能跑”,但没有把硬件并行能力发挥出来。本轮二次开发首先把提交路径改成能够识别 core_mask 和 subcore_task,让同一批任务可以被拆成多个 lane 分发到不同 core。
当前的三核执行模型可以概括为:
- 用户态仍然通过一个
RknpuSubmit提交任务批次。 subcore_task[]描述每个 lane 的任务范围;如果用户态没有显式填写 lane,队列层会把任务归一化到默认 lane。core_mask决定这次 submit 允许使用哪些物理 core,例如0x1表示只用 core0,0x7表示三个 core 都可用。- 调度器为每个空闲 core 挑选一个可派发 lane,然后调用底层 driver 对该 core 编程。
- core 完成后,IRQ 路径发布 raw completion,调度器再回收并推进对应 lane 的 cursor。
这部分工作的重点不是简单把同一条命令发三遍,而是要保证每个 core 跑的是正确的 task slice,同一条 lane 不会被重复派发,completion 也能回到正确的 submit 和 task index。只有这些状态对齐,多核数据才有意义。
2.2 任务调度器与多线程共享 NPU
第二个是任务调度器。NPU 是共享硬件资源,不能让多个线程各自直接碰寄存器,否则很容易出现 core 状态、任务进度和 completion 归属混乱。当前实现保留外部的 blocking submit 语义,但内部引入了调度队列和 worker 线程:
- 调用线程进入
Submitioctl 后,不直接独占 NPU 跑完整批任务,而是把 submit 放进 scheduler。 - 每个 submit 有自己的 waiter。调用线程只等待“自己的 submit 是否完成”。
- 全局 worker 负责真正的 dispatch 和 harvest。它被 kick 唤醒后,先回收已完成 core,再给空闲 core 下发新任务。
- scheduler 维护 ready、running、complete 这些状态。ready 表示还没开始跑的 submit,running 表示已有 lane 在跑或还有 lane 可继续派发,complete 表示终态结果等待 ioctl 路径取回。
- 如果 running submit 还有可派发 lane,会优先继续推进 running,而不是马上切到一个全新的 ready submit。这样可以减少同一 submit 内部的等待空洞。
service 层的 blocking submit 通过 per-submit waiter 阻塞:调用线程在 wait_for_submit() 上等待,直到 worker 将该 submit 移入 complete 并调用 waiter.complete() 唤醒它,再通过 take_terminal_submit() 取回终态结果。多个用户线程同时提交 NPU 任务时,线程可以各自阻塞在自己的 waiter 上,NPU 由全局 worker 串行管理硬件状态并并行利用多个 core。换句话说,NPU 对外看起来仍是阻塞式设备,对内已经具备”多线程共享、队列化提交、三核流式执行”的基础形态。
这版调度器的价值就在这里:它没有把用户态 ABI 改复杂,但把内核侧的执行模型从”谁提交谁跑”推进到了”统一排队、统一分发、统一回收”。
2.3 引入 rknpu-regs 寄存器库
寄存器访问层也做了工程化整理,引入了基于 SVD / svd2rust 生成的 drivers/rknpu-regs。驱动开发里手写寄存器偏移和位域非常容易出错,尤其是 NPU 这种寄存器块多、字段分散、不同 core 地址重复的硬件。
rknpu-regs:
- 用类型化寄存器接口替代裸地址和 magic number。
- 减少手工抄写偏移、位宽、mask 时的错误。
- 让寄存器访问代码更接近硬件文档,后续查错更方便。
- 把”访问寄存器”和”调度策略”拆开,避免调度器里混入大量底层地址细节。
三、benchmark 测试内容
3.1 测量范围与方法
本次性能数据来自 log.txt 中运行的 ./core_scaling_benchmark,对应测试程序是 core_scaling_benchmark.c。
测量窗口:仅覆盖 blocking DRM_IOCTL_RKNPU_SUBMIT 的完整往返时间,即 submit ioctl 从进入到返回。operand packing 和 regcmd generation 单独打印,不计入对比窗口。因此下面的数据反映的是 driver submit、scheduler dispatch/harvest、硬件执行和 completion 回收的综合耗时
指标定义:
speedup = T_1core / T_3core(同一批任务 1-core 与 3-core 的平均 submit 时间之比)parallel efficiency = speedup / 3(理想三核加速为 3x,efficiency 衡量实际利用率)GFLOP/s = 2 × GMAC/s(1 MAC = 1 乘 + 1 加 = 2 FLOP)jitter span = (T_max - T_min) / T_avg(衡量单次 submit 时间的波动幅度)
正确性校验:第一轮 measured round 会对输出抽样与 CPU reference 比较,并检查每个 task 的 int_status == 0x300。这是抽样校验,不是全量验证。
3.2 测试环境
- 硬件平台:RK3588 SoC(三核 NPU)
- 操作系统:StarryOS比赛版本
- Benchmark 程序:
core_scaling_benchmark(4 场景 × 2 operand 模式) - 测量轮次:每场景 warmup 2 轮 + measured 5-12 轮(场景相关)
- 频率/电源控制:未控制(默认 governor)
- 热稳态控制:未控制
- IRQ 亲和性:未设置
3.3 测试场景
每个场景一般又分两种 operand 模式:
shared-operands:所有任务复用同一份 input/weight,只有 output slice 私有。这更偏向测试调度和计算本身,DMA footprint 较小。unique-operands:每个 task 有自己的 input/weight/output slice。这更接近多任务独立数据的情况,内存占用和准备成本更高。
测试程序里固定了四个场景。它们不是随便取的矩阵形状,而是分别压不同瓶颈:
| 场景 | 矩阵形状 | shared tasks | unique tasks | warmup | measured | 主要验证点 |
|---|---|---|---|---|---|---|
tiny_dispatch |
M=4 K=32 N=16 |
96 | 96 | 2 | 12 | 小矩阵,submit/scheduler 固定开销占比最高,用来观察多核调度在短任务下是否会被开销吞掉。 |
mid_balanced |
M=64 K=512 N=512 |
48 | 12 | 2 | 8 | 中等矩阵,调度开销和计算吞吐都会影响结果,用来判断调度器是否进入稳定可用区间。 |
throughput_heavy |
M=128 K=1024 N=1024 |
24 | 4 | 2 | 5 | 大矩阵,目标是把瓶颈推向 NPU 计算吞吐;unique 任务数较少,是为了控制 DMA footprint。 |
llama_decode_like |
M=1 K=4096 N=4096 |
48 | 0 | 2 | 8 | 低 M、高 K、高 N,接近 LLM decode 阶段线性层投影形状,更关注长任务延迟和尾部波动。 |
tiny_dispatch 主要看调度器的“底噪”。如果这个场景三核退化,说明每次 dispatch、IRQ 回收、worker yield、waiter 唤醒的成本已经压过了硬件并行收益。它使用 96 个 task,任务数足够多,可以持续给三个 core 喂任务,但单 task 计算量非常小。
mid_balanced 是更接近日常 benchmark 的中间档。shared 模式有 48 个 task,unique 模式只有 12 个 task,因为 unique 模式每个 task 都有独立 input/weight/output,内存占用增长更快。这个场景用来观察调度器在“既有计算量、又有一定任务数量”的情况下是否稳定。
throughput_heavy 则故意把矩阵放大。shared 模式有 24 个 task,unique 模式只有 4 个 task。这里不是为了追求任务数,而是为了让每个 task 本身足够重,看三核并行能否把 GFLOP/s 拉上去。unique 任务数少也会暴露另一个问题:当任务批次太短时,三核并行窗口会变窄。
llama_decode_like 只跑 shared 模式,unique tasks 在测试程序里设为 0,所以日志里会跳过 unique。它模拟的是 decode 阶段常见的投影类 workload:M 很低,但 K 和 N 很大。这个场景不一定追求最高吞吐,更关心一次 submit 的阻塞时间能不能被多核明显压下来。
输入和权重不是随机数,而是由 deterministic_input_value() 和 deterministic_weight_value() 生成的整数模式;输出会抽样和 CPU reference 比较。每个 task 的 int_status 也会检查,期望值是 0x300。任务分发时,distribute_tasks_to_cores() 会按 core 数把 task range 平均切到 subcore_task[],1 core 时只填 core0,3 cores 时填 core0/core1/core2 并设置对应 core_mask。因此这个 benchmark 测到的不是单纯的 C 程序循环,而是完整覆盖了 submit ABI、调度器 lane 切分、三核 dispatch、IRQ completion 和 copy-back 这些路径。
四、benchmark 结果与性能分析
4.1 总体结论
所有有效场景里,三核都比单核快,没有出现最终退化。最好的场景是 llama_decode_like/shared-operands,从 344.354 ms 降到 137.000 ms,speedup 达到 2.514x,parallel efficiency 为 83.78%。这说明调度器已经能把 RK3588 三个 NPU core 的并行能力用起来。
三核都有正收益,但大多数场景的 parallel efficiency 仍在 57% 到 68% 左右
4.2 结果汇总
| 场景 | 模式 | 任务数 | 1-core avg submit | 3-core avg submit | speedup | parallel efficiency |
|---|---|---|---|---|---|---|
tiny_dispatch |
shared | 96 | 2.533 ms |
1.423 ms |
1.780x |
59.32% |
tiny_dispatch |
unique | 96 | 3.478 ms |
1.739 ms |
2.000x |
66.67% |
mid_balanced |
shared | 48 | 32.496 ms |
18.746 ms |
1.733x |
57.78% |
mid_balanced |
unique | 12 | 10.459 ms |
6.065 ms |
1.724x |
57.48% |
throughput_heavy |
shared | 24 | 42.656 ms |
20.864 ms |
2.044x |
68.15% |
throughput_heavy |
unique | 4 | 6.781 ms |
3.939 ms |
1.721x |
57.38% |
llama_decode_like |
shared | 48 | 344.354 ms |
137.000 ms |
2.514x |
83.78% |
4.3 tiny_dispatch:小任务也有明显收益
tiny_dispatch 的矩阵规模很小,单 task 的计算量低。当前结果里,shared 模式从 2.533 ms 降到 1.423 ms,unique 模式从 3.478 ms 降到 1.739 ms。这说明当前调度器的固定开销没有大到完全吞掉三核收益,小任务也能加速。
但是这个场景的性能不能过度解读。shared 模式 parallel efficiency 是 59.32%,unique 模式是 66.67%,距离理想三核加速2x以上仍有明显差距。小任务下,每次 dispatch 和 completion 的成本占比很高,真正花在矩阵计算上的时间太短。后续如果要优化小任务,需要减少每 task 的下发/回收成本,或者把更多小 task 合并成更粗粒度的 batch。
4.4 mid_balanced:中等任务证明调度器进入显著加速区间
mid_balanced 是这次比较有代表性的场景。shared 模式中,1 core 平均 submit 为 32.496 ms,3 core 为 18.746 ms,speedup 为 1.733x。unique 模式中,1 core 为 10.459 ms,3 core 为 6.065 ms,speedup 为 1.724x。
这个结果说明,调度器在中等任务规模下已经进入稳定可用区间。两种 operand 模式都接近 1.7x,没有只在某一种特殊数据复用方式下才有效。它也说明当前瓶颈不只是数据准备,因为 benchmark 的 measured window 没把 operand packing 算进去;submit 阶段本身确实因为多核并行缩短了。
4.5 throughput_heavy:吞吐型任务收益更明显
throughput_heavy 的 shared 模式从 42.656 ms 降到 20.864 ms,speedup 达到 2.044x,parallel efficiency 为 68.15%。同时 GFLOP/s 从 151.033 提升到 308.786,基本也是 2.044x 的增益。这个场景最能说明三核调度的直接价值:任务足够重之后,固定调度开销被摊薄,硬件并行执行开始成为主导因素。
unique 模式任务数只有 4 个,这是为了控制 DMA footprint。它仍然从 6.781 ms 降到 3.939 ms,speedup 为 1.721x。任务数少会限制三核利用率,因为 worker 能同时派发的 lane 数量和后续补发机会都变少。这个结果没有 shared 模式好,但仍然是稳定正收益。
4.6 llama_decode_like:长任务场景收益最好,但 jitter 较大
llama_decode_like 是本次最强的结果。它的 shared 模式从 344.354 ms 降到 137.000 ms,speedup 达到 2.514x,parallel efficiency 为 83.78%,GFLOP/s 从 4.677 提升到 11.756。这说明在低 M、高 K、高 N 的投影类 workload 下,当前三核调度能显著降低 submit 阻塞时间。
但这个场景也反应出在3-core 的 min/max 为 126.027 / 139.504 ms时,jitter span 达到 9.84%,明显高于 1-core 的 0.03%。也就是说,平均值很好,但三核路径下仍有一定波动。可能原因包括 worker harvest 时机、core completion 到达顺序、yield 后重新调度的时间差,以及更长任务下不同 core 之间的尾部等待。
4.7 这轮结果说明
- 三核支持已经有效。所有有效 benchmark 场景都显示 3-core submit 时间低于 1-core。
- 调度器设计已在真实 benchmark 中转化为性能收益。ready/running 队列推进、core binding 和 completion 回收这套机制能够有效利用三核并行。需要注意的是,当前 benchmark 验证的是单次 blocking submit 内的多核扩展收益,而非多线程并发提交的竞争场景——后者是调度器设计支持的能力,但尚未专项测试。
- 软件开销仍然存在。大多数场景没有接近理想
3x,说明 dispatch、harvest、同步和调度唤醒成本仍然需要优化。
五、功能模块分层与实现思想
当前实现可以按从上到下的链路理解。
最上层是用户态 benchmark 或 runtime。它负责准备输入、权重、输出、regcmd 和 task array,然后通过 ioctl 提交任务。benchmark 还负责构造不同矩阵规模和不同 operand 共享模式,用来观察调度器在不同负载下的行为。
再往下是 ioctl / service 边界层。它负责把用户态传进来的 RknpuSubmit、RknpuTask[] 和内存管理请求拷入内核,转换成驱动内部可以处理的数据。这里不应该保存太多调度状态,否则 ioctl 层会变成第二个 scheduler。
scheduler 层负责 submit 生命周期。它维护 ready、running、complete 三个 bucket,管理每个 submit 的 waiter,也负责唤醒全局 worker。waiter 和 kick 的职责要分清:waiter 是 per-submit 的,回答”这个 submit 完成了吗”;kick 是全局 worker 信号,回答”现在有没有新活需要 worker 醒来处理”。这两个东西混在一起,调度器会很难读,也很容易漏唤醒。
driver / dispatch / IRQ 层负责硬件事实。driver 给某个 core 编程,IRQ handler 读取和清除硬件中断,completion 只表示”某个 core 有原始完成状态”。至于这个 completion 属于哪个 submit、哪个 lane、哪个 task index,应由 scheduler 根据 core_binding 还原,而不是让 driver 反向保存一堆队列语义。
最底层是寄存器访问层,也就是 rknpu-regs。它提供类型化 register API。调度器不应该知道太多寄存器细节,寄存器层也不应该知道队列策略。这个分层让后续工作可以分开推进:寄存器访问继续补全,调度策略继续优化,ioctl ABI 保持稳定。
六、当前限制与问题分析
- 三核收益仍然低于理想值。除了
llama_decode_like达到83.78%efficiency,多数场景仍在57%到68%左右。说明当前并行并不是完全线性扩展,软件路径还有明显成本。 - 小任务场景仍然敏感。
tiny_dispatch虽然这次有正收益,但它的绝对 submit 时间只有毫秒级,任何一次额外调度、yield、IRQ 回收或锁竞争都会改变结果。后续如果要跑大量小算子,必须继续压低固定开销。 - 3-core 路径存在尾延迟波动。
llama_decode_like的平均 speedup 很好,但 3-core jitter span 到了9.84%。这提示我们不能只盯 avg submit,还要看 min/max 和尾延迟。
七、调度器的执行时序
本节描述调度器的内部机制和执行流程,内容基于 drivers/rknpu/src/service/scheduler.rs 和 drivers/rknpu/src/task/taskqueen.rs 的实现。
7.1 核心数据结构
NpuSchedulerState(调度器全局状态,受单一 mutex 保护):
tasks: BTreeMap<RknpuQueueTaskId, RknpuQueueTask>— 所有活跃 submit 的唯一所有者ready: BTreeMap<i32, VecDeque<RknpuQueueTaskId>>— 按优先级分桶,尚未开始执行的 submitrunning: BTreeMap<i32, VecDeque<RknpuQueueTaskId>>— 按优先级分桶,已有 lane 在执行或还有 lane 可派发的 submitcomplete: BTreeMap<RknpuQueueTaskId, RknpuQueueTask>— 已终态,等待 ioctl 路径取回core_binding: BTreeMap<usize, CoreRunBinding>— 物理 core →{task_id, lane_slot, task_index}的归属映射waiters: BTreeMap<RknpuQueueTaskId, Arc<W>>— per-submit 的阻塞等待器
RknpuQueueTask(单个 submit 的运行时状态):
lane_isrun: [bool; 5]— 每条 lane 是否有任务在飞subcore_cursors: [u32; 5]— 每条 lane 已完成的 task 数量last_error: Option<RknpuError>— 错误状态
submit 的生命周期状态(ready/running/complete)不是单独维护的枚举,而是由 lane_isrun、subcore_cursors、last_error 的组合派生,并通过 reclassify_task() 决定 submit 应归入哪个 bucket。
7.2 调度策略
running-before-ready:dispatch_idle_cores() 为每个空闲 core 选择候选时,优先从 running bucket 中找可继续派发的 submit(prepare_dispatch_from_running),只有当没有 running submit 可用时,才从 ready 提升新 submit(promote_ready_and_prepare_dispatch)。这减少了同一 submit 内部的等待空洞,但对等待中的 ready submit 不是严格公平的。
内存同步边界:
comfirm_write_all():在一次dispatch_idle_cores()调用中,对某个 submit 首次派发前调用,确保 DMA 写入对硬件可见prepare_read_all():在 terminal submit 唤醒 waiter 前调用,确保硬件写回对 CPU 可见
7.3 图一:Submit 生命周期
注意:函数签名可能随着更新而改变实际函数签名以代码仓库中为准,此处只做流程解读
下图展示单个 submit 从 ioctl 入队到 copy-back 返回的完整路径,以及多个并发 submit 线程如何通过独立 waiter 共享同一个 worker。

7.4 图二:Worker 主循环与多核派发
注意:函数签名可能随着更新而改变实际函数签名以代码仓库中为准,此处只做流程解读
下图展示 worker 线程的主循环结构,以及 harvest 和 dispatch 如何交替推进多个 submit 的执行。

相关仓库
驱动主仓库
StarryOS与驱动的桥接层
效果视频,使用请看readme
PPT
开发日志
自动测试系统 与 starry-vdso 完善
本次实习工作总结
摘要
本次实习围绕 x86 自动化测试体系构建、starry-vdso 完善、以及基于自定义 vDSO 接口的 fast path 设计与实现 三条主线展开。完成了从 PXE 自动化部署验证、CI 集成、多组织资源锁适配,到多架构 vDSO/getcpu 支持、vvar 映射优化、自定义 fast path 加载与调用、eBPF→vDSO 数据通路打通等一系列工作。整体实现了 vDSO 基础设施、以及低延迟 fast path 机制上的重要增强,为后续可插拔调度器、动态 eBPF 策略与用户态零系统调用访问奠定了基础。
x86 自动化测试支持
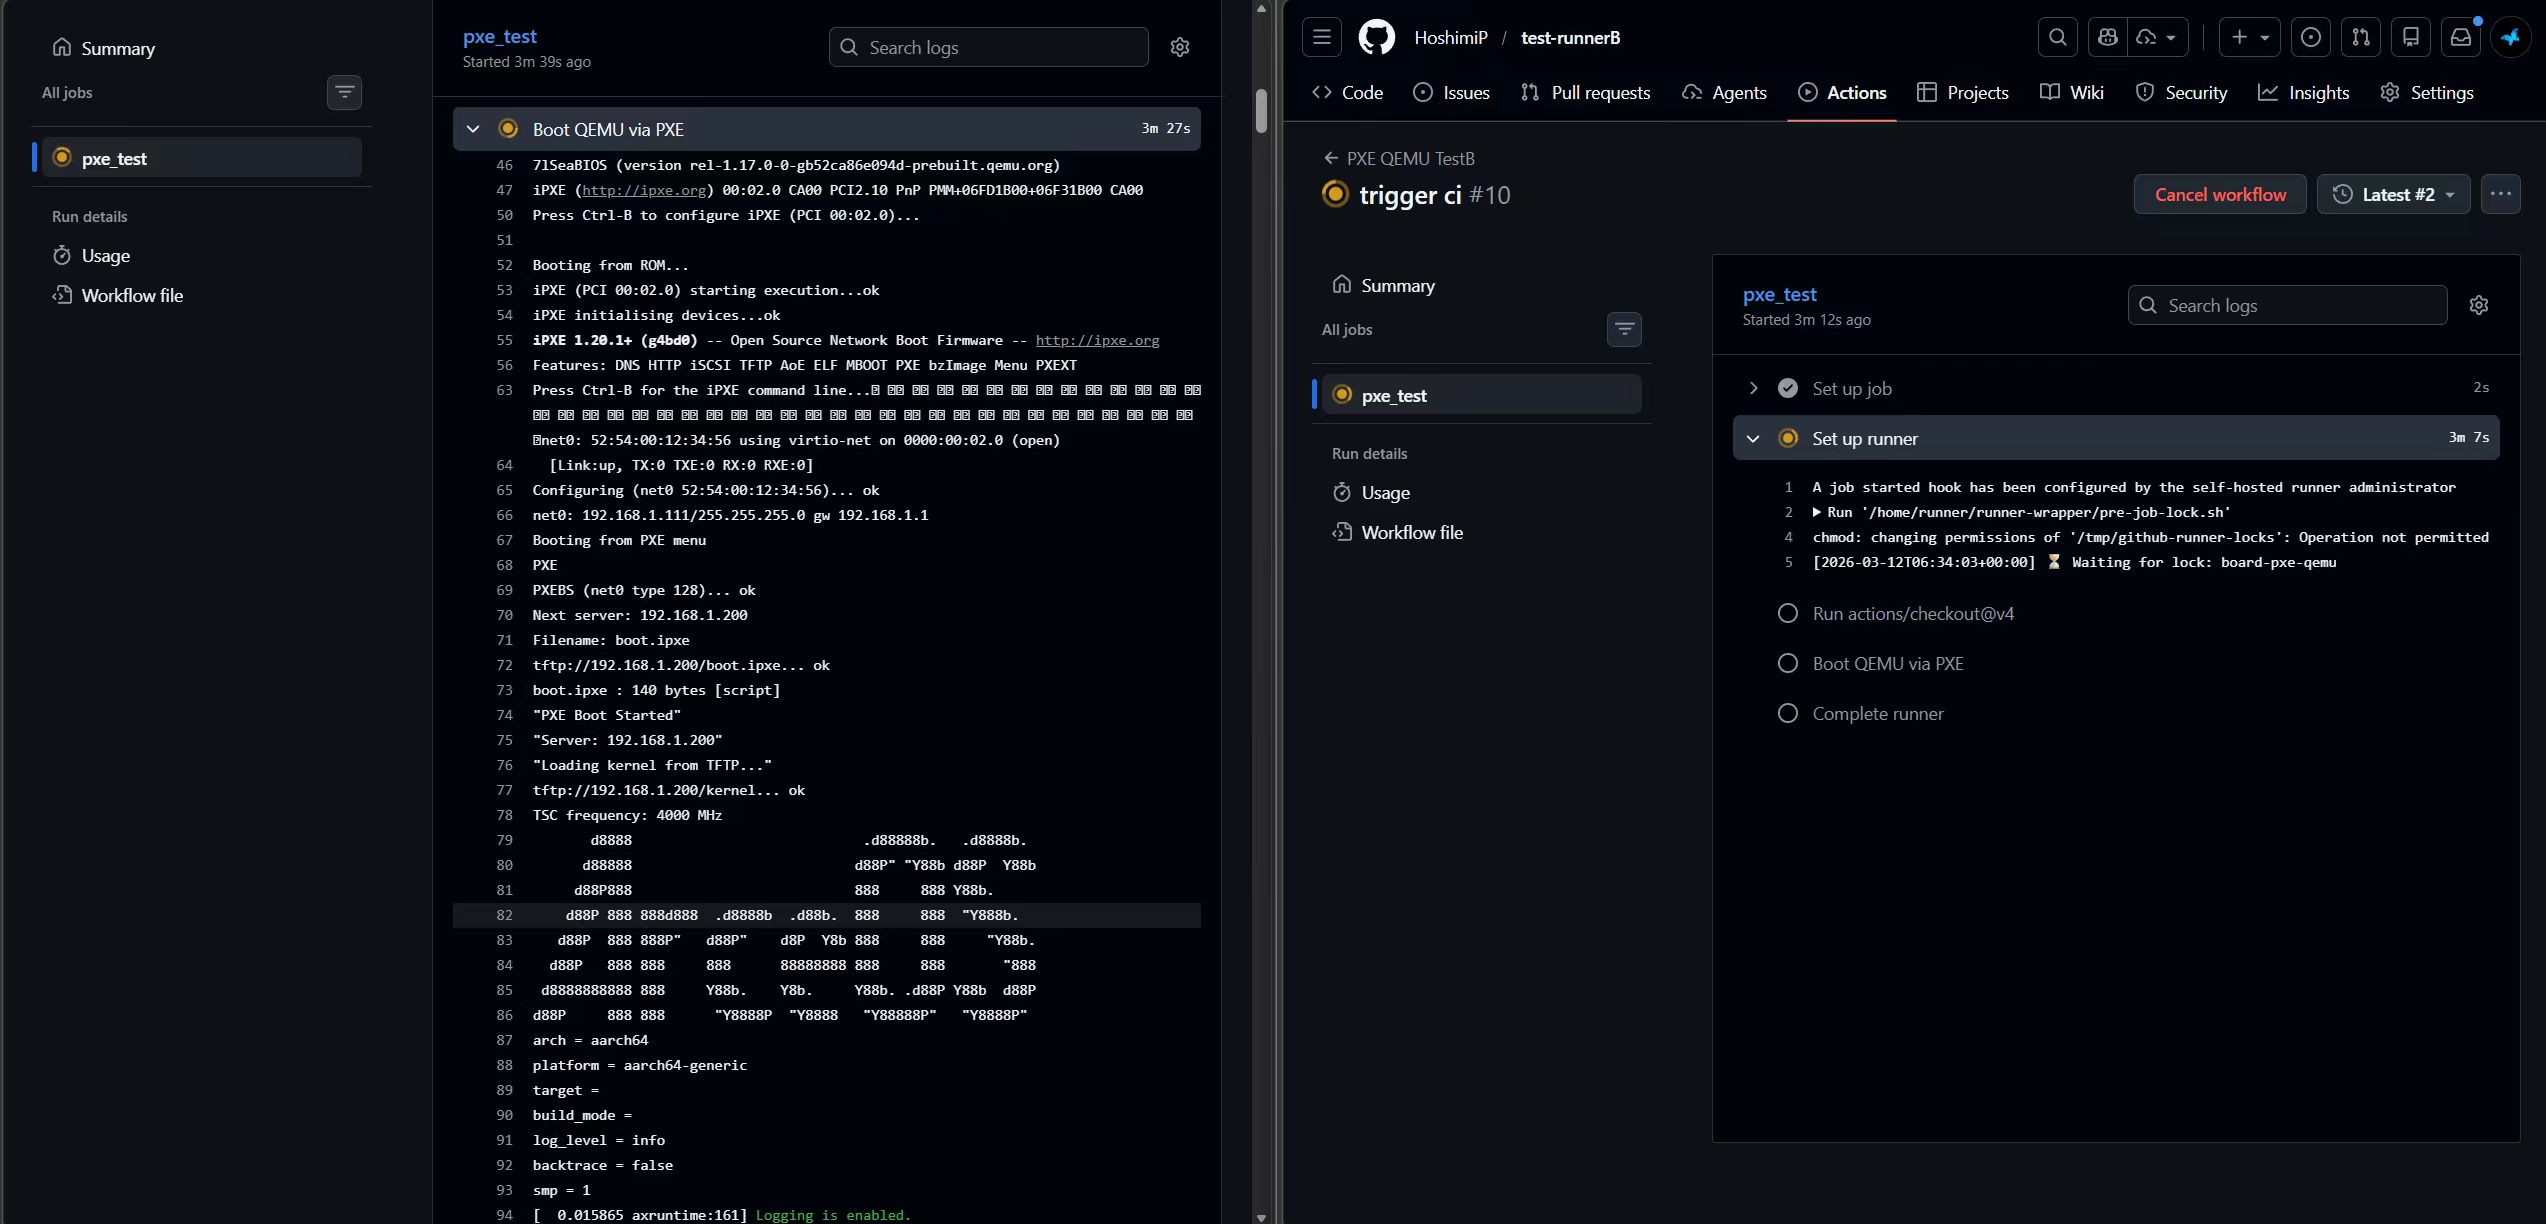
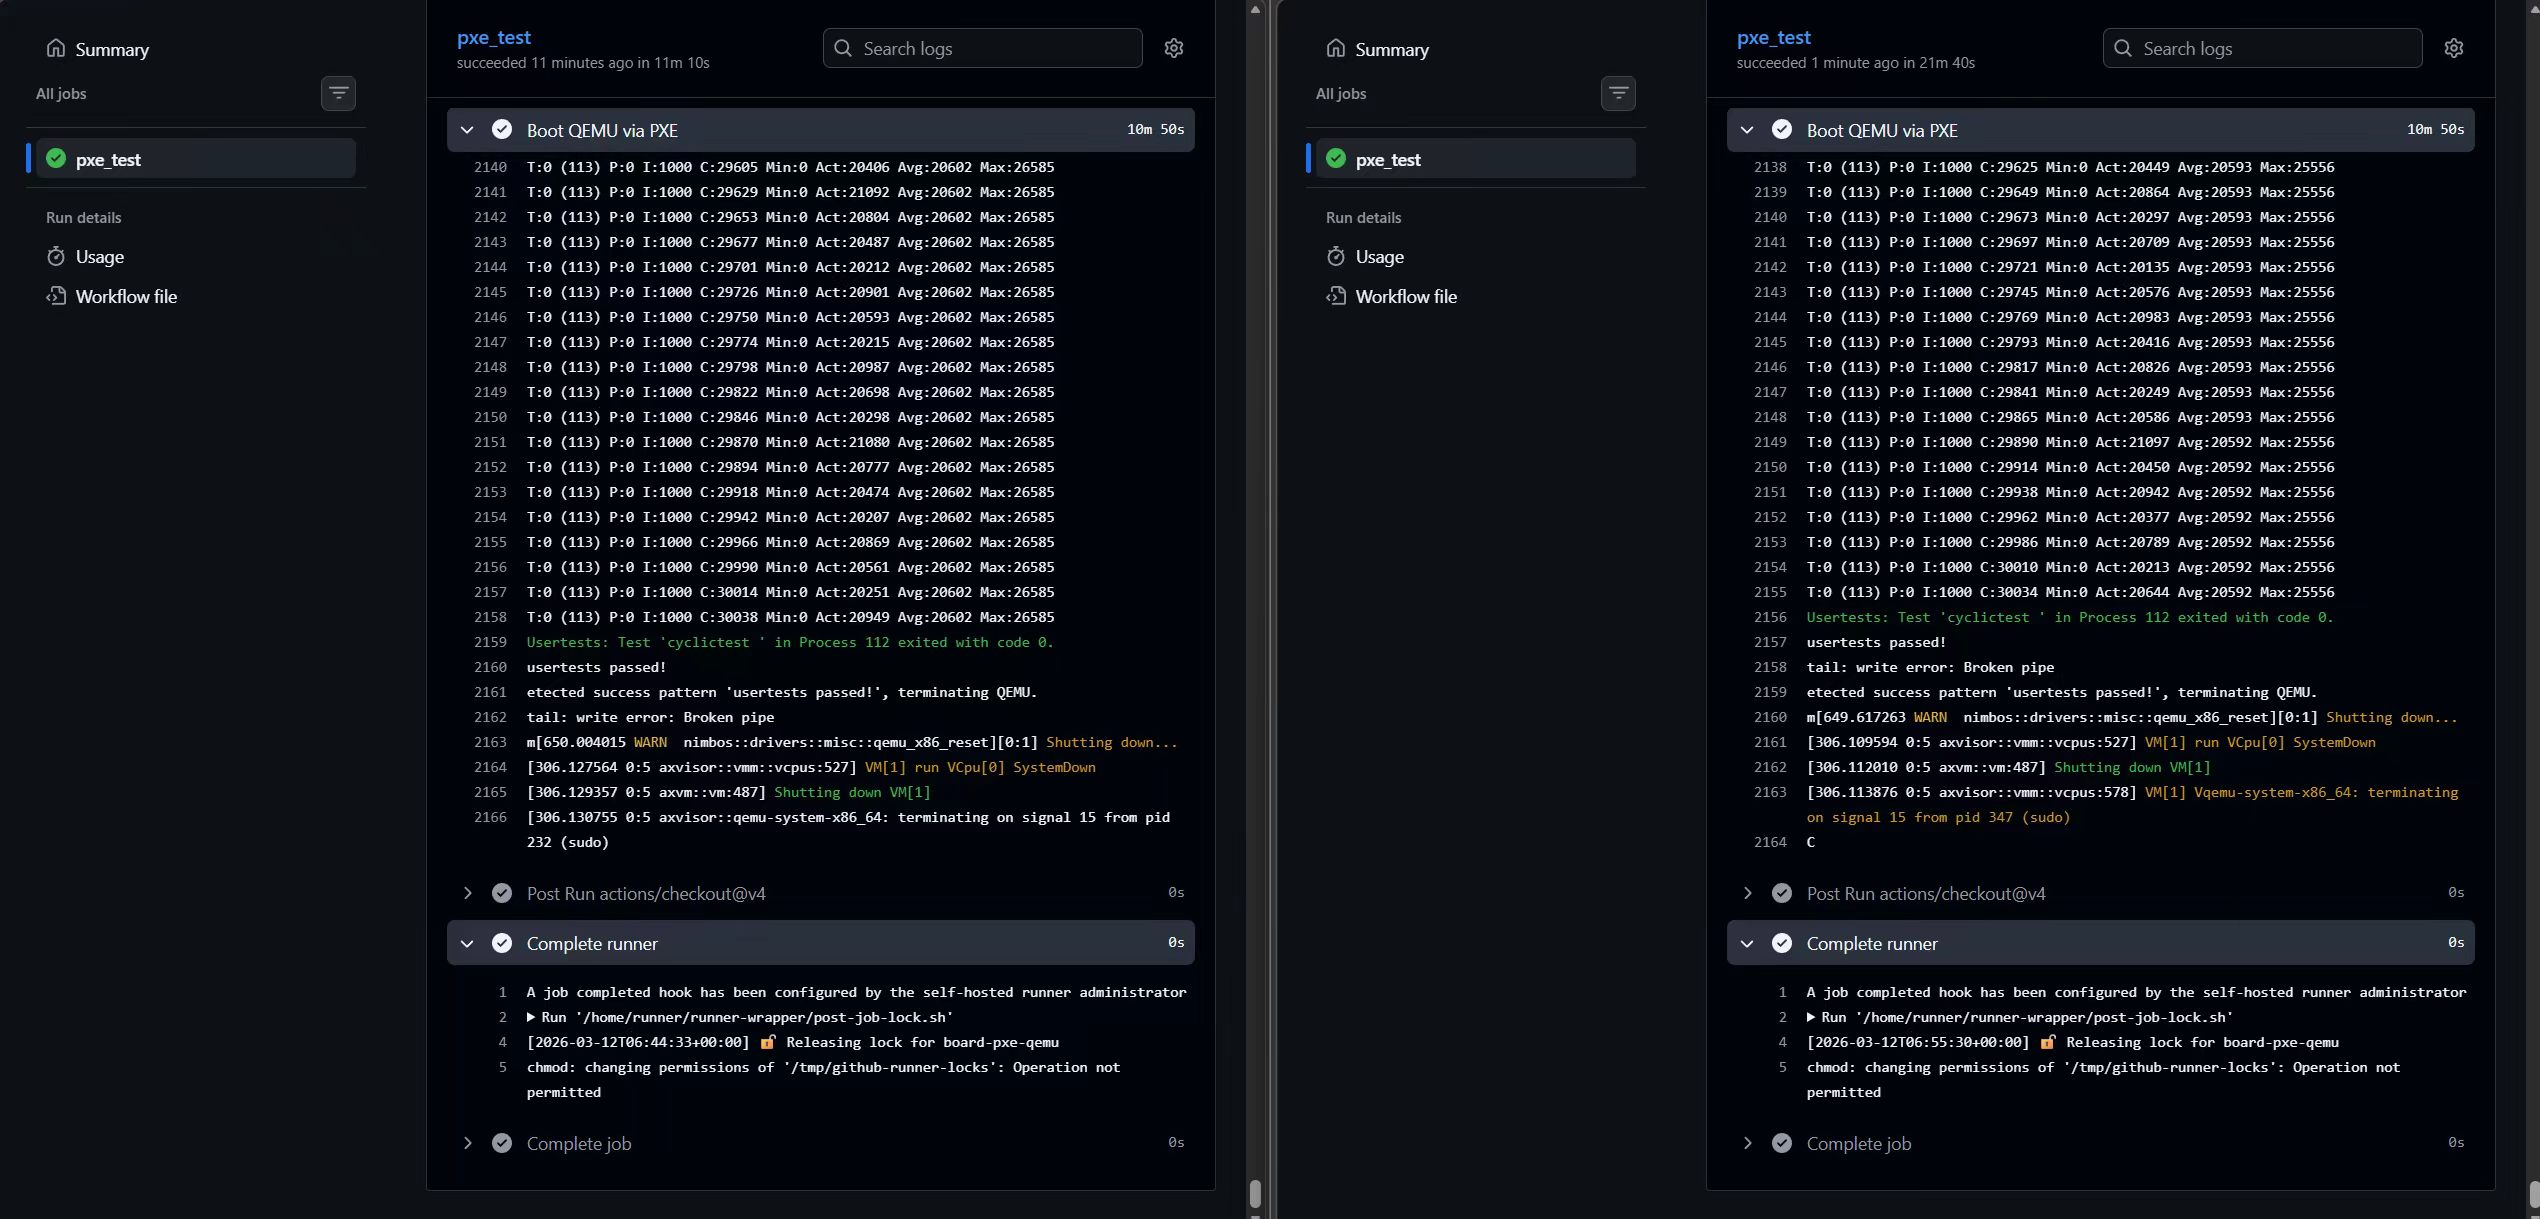
验证了 x86 平台使用 pxe 进行自动测试部署的流程,并编写验证报告
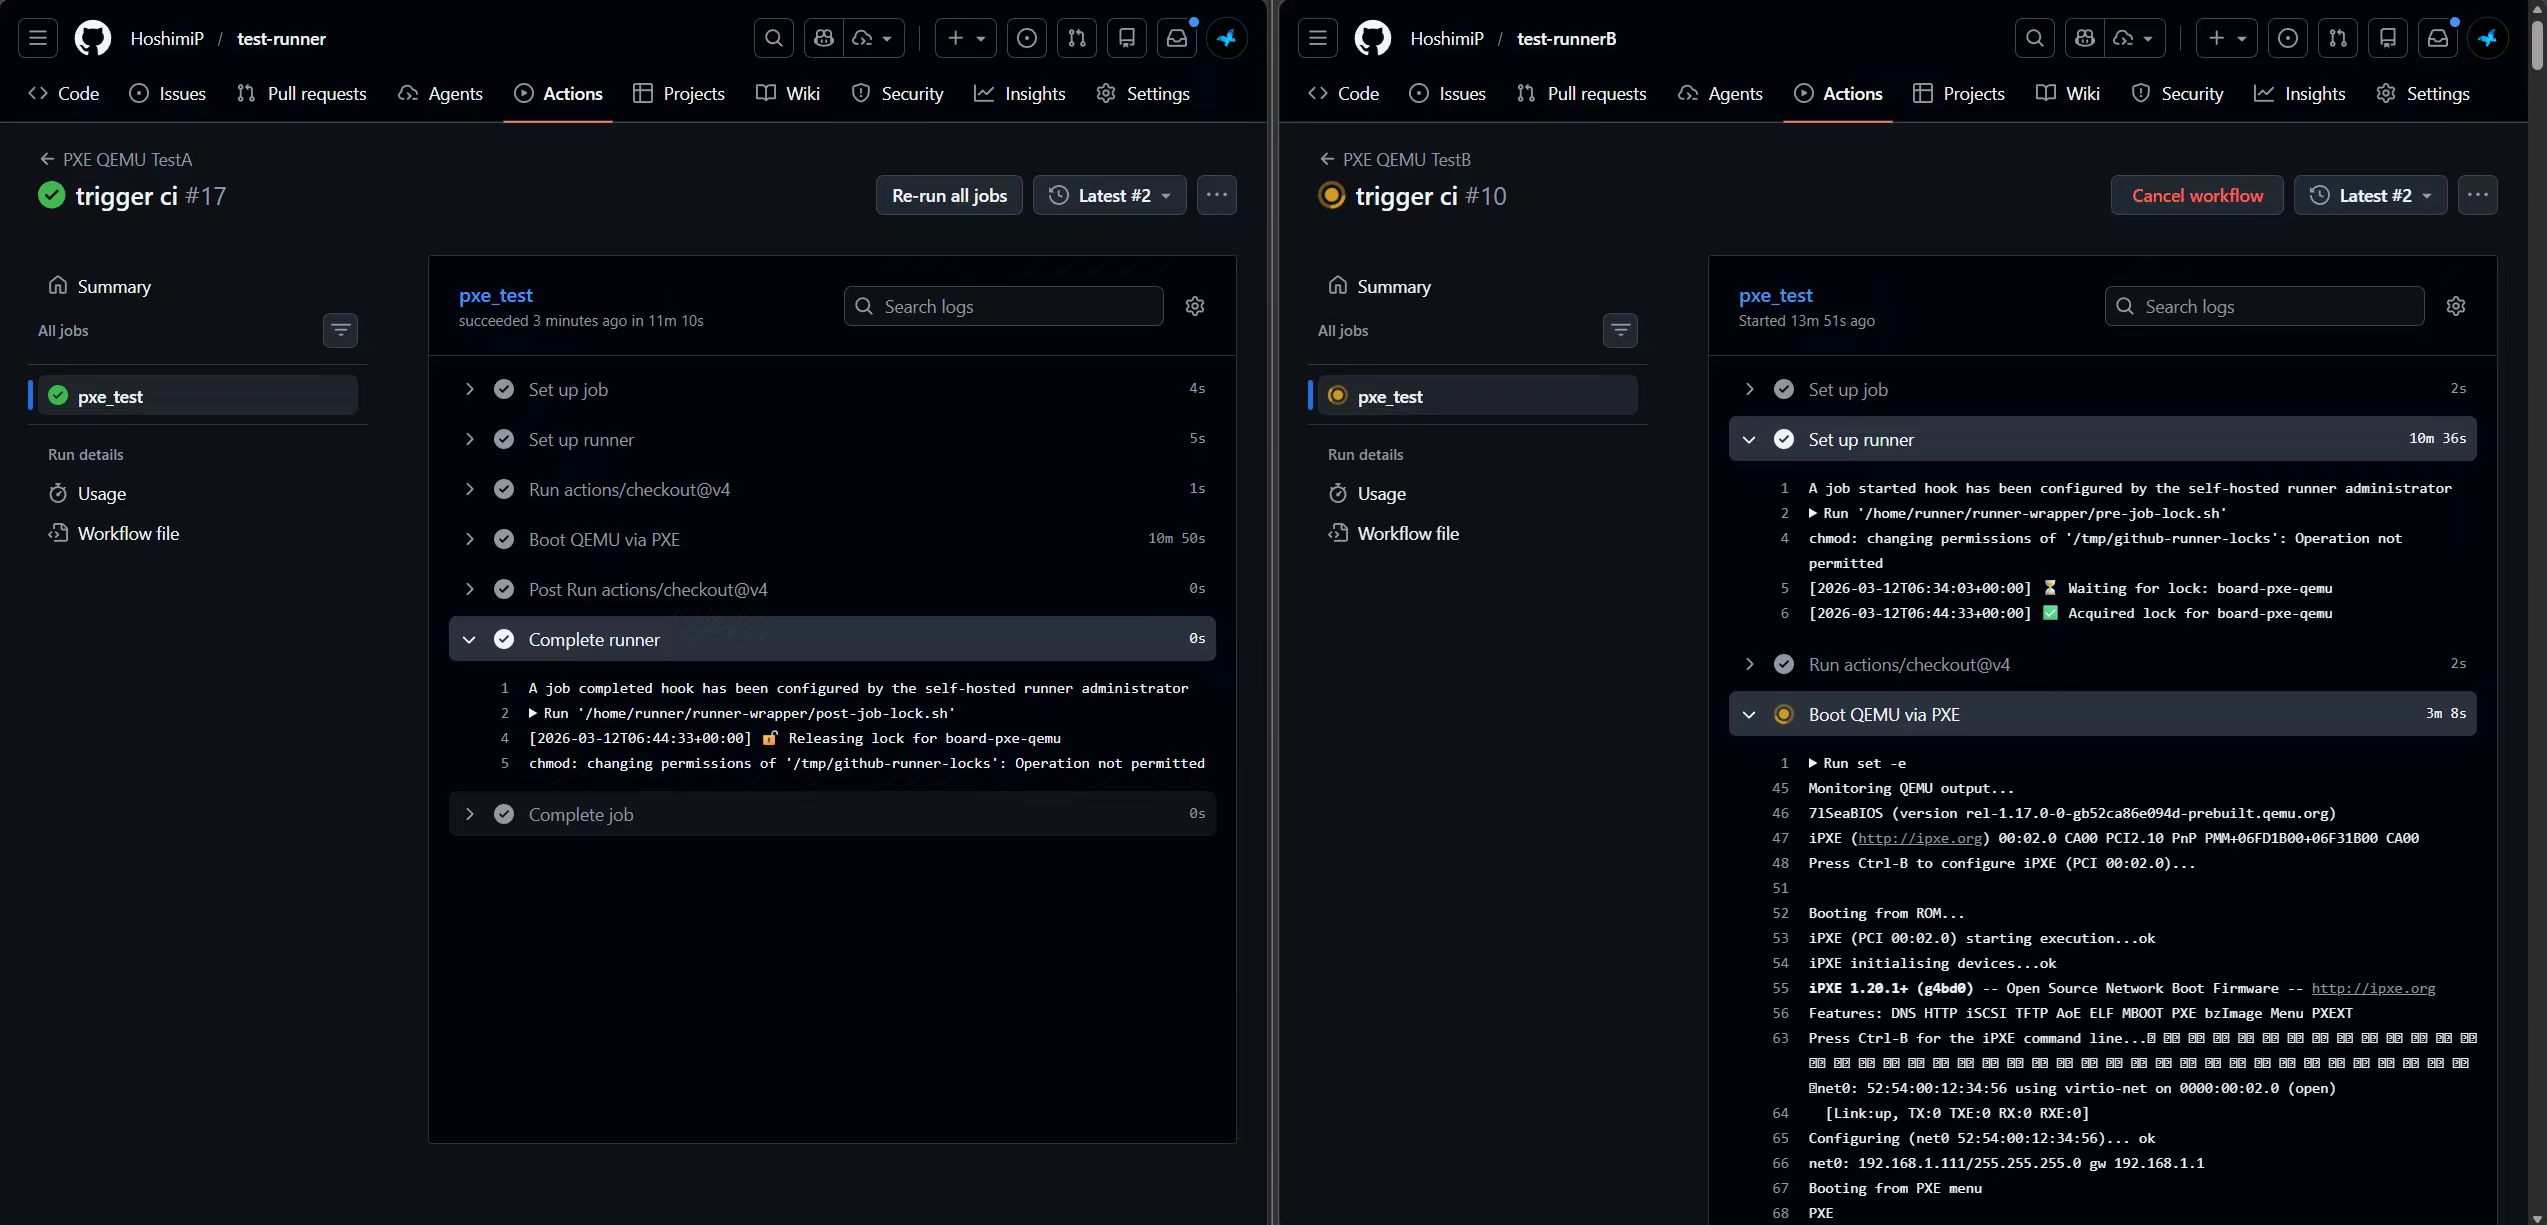
拆分 pxe 部署脚本,并与已有 github-runners 结合,使其能够在 CI 中自动触发测试
验证了部署流程与多组织资源锁 runner-wrapper 的适配,在 ubuntu+qemu 环境成功触发资源锁并执行完整测试
由于本地环境限制(缺少物理开发板),将已完成部分交付给柏乔森老师负责真实硬件上的验证
starry-vdso 的完善
- 将 starry-vdso 接入 starryOS 验证时间相关函数已经能够走 vdso 路径 具体验证结果见笔记
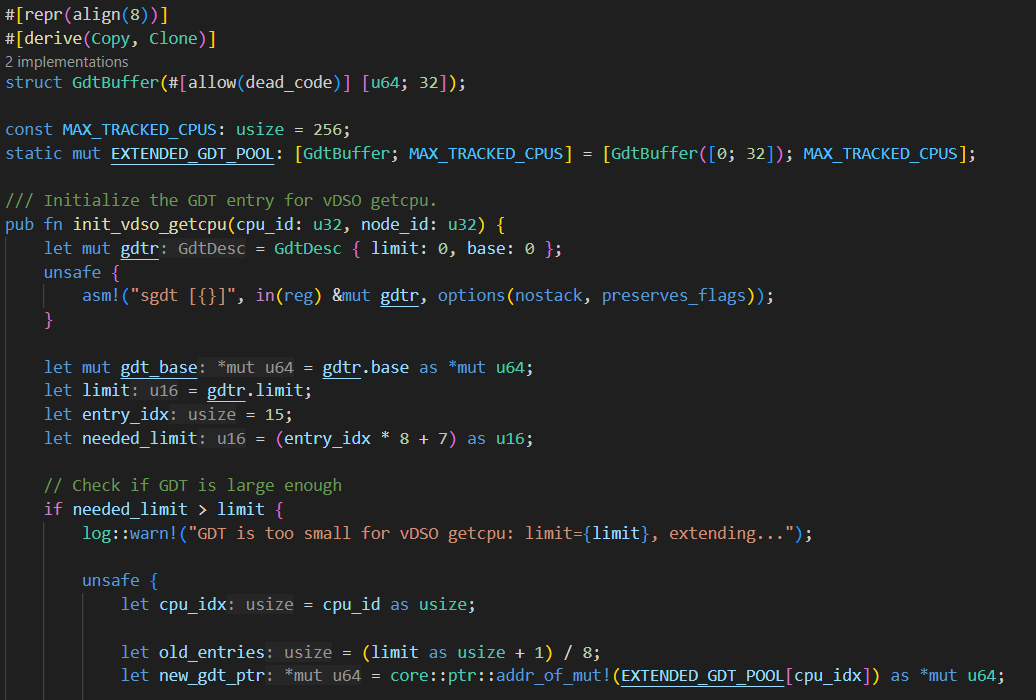
- 修改了 x86 架构 getcpu 的初始化实现 为每个 cpu 分配独立 GDT 空间 解决多核场景下 CPU ID 获取不准确的问题
- 实现了 loongarch64 架构的 vdso_getcpu
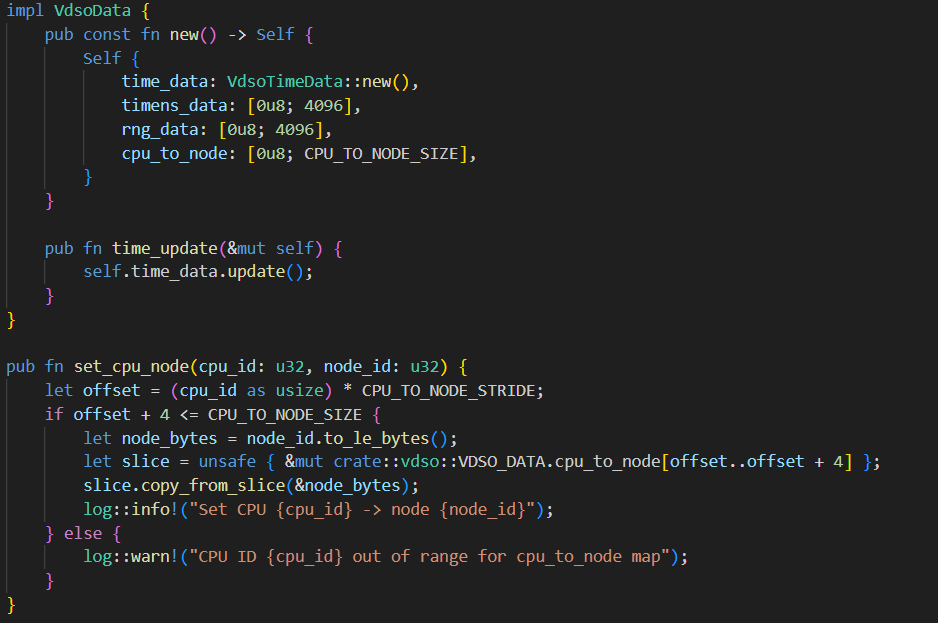
基于自定义 vDSO 接口的 fast path 设计与实现
使用 vdso-helper 编译包含自定义 fast path 的
.so文件,并完成在 StarryOS 中的加载与调用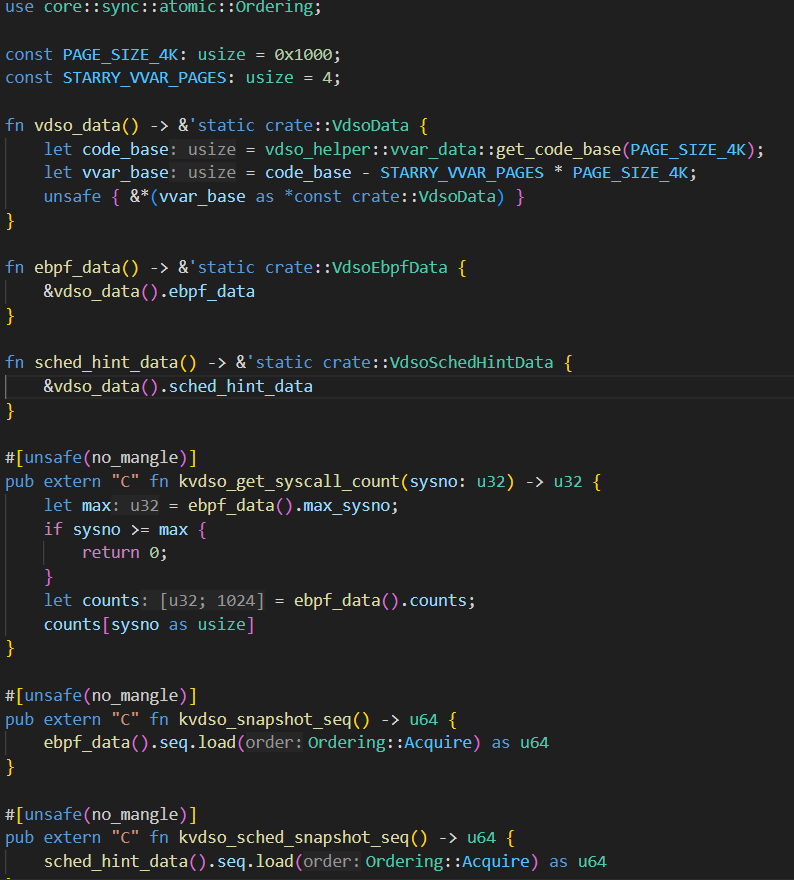
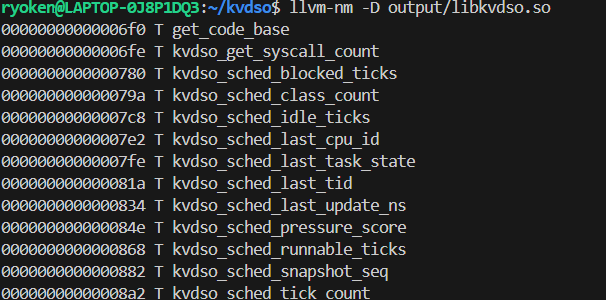
优化 starry-vdso 的 vvar 映射逻辑 使用户态可以正常通过 vdso基地址+偏移量 访问自定义 vdso 接口
在已有可加载模块
modules/kebpf中增加 vdso 数据页的更新逻辑。当 eBPF 程序执行时,将结果从 map 写入 vvar,使用户态可以零系统调用读取结果,显著降低延迟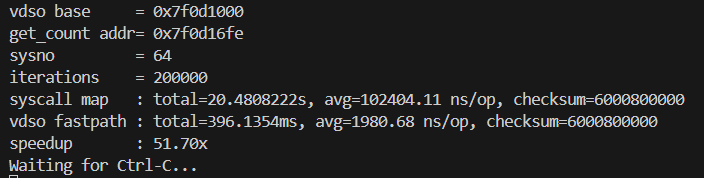
在
api/src/lib.rs处增加 vdso 数据页的更新逻辑,在register_timer_callback时同步更新 vvar 中的任务快照,确保 fast path 始终读取到最新状态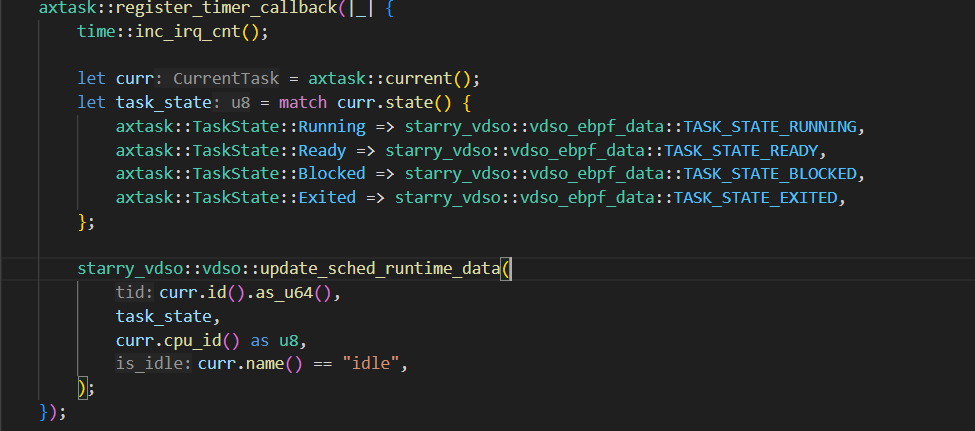
相关链接
项目工程仓库
- starry-vdso https://github.com/HoshimiP/starry-vdso
- StarryOS/tree/vdso_for_ebpf https://github.com/HoshimiP/StarryOS/tree/vdso_for_ebpf
周报和工作总结
参考
- github-runners https://github.com/arceos-hypervisor/github-runners
- 在 x86 物理机验证通过的自动测试文档 https://github.com/arceos-hypervisor/github-runners/blob/x86/docs/PXE%E9%83%A8%E7%BD%B2%E8%AF%B4%E6%98%8E.md
- vdso-helper https://crates.io/crates/vdso_helper
- StarryOS 支持内核可加载模块和 ebpf 的分支 https://github.com/Starry-OS/StarryOS/tree/kmod
Embassy Preempt On VisionFive2 -- Oveln
Embassy Preempt
摘要
Embassy Preempt是一个嵌入式异步实时操作系统调度模块,结合Rust协程机制与传统RTOS的抢占式调度,在内存效率和实时性之间取得平衡。系统支持Rust原生async/await语法定义实时任务,兼容uCOSII API接口,并实现了创新的动态栈空间管理——主动让权时共享栈以节省内存,被抢占时按需分配私有栈保存上下文,在64任务场景下相比固定栈方案节省约53%内存。
项目已适配RISC-V平台,在VisionFive2(JH7110)开发板上实现了完整的AMP方案:S7核心运行Embassy Preempt处理实时任务,U74核心运行StarryOS处理通用计算,通过ov_channel共享内存库实现Notification和RPC双向通信。在无数据缓存的S7核心上,上下文切换性能与U74核心上的RT-Thread相当,核间通信延迟比官方AMP方案低约5~6倍。
系统简介
Embassy Preempt是一个嵌入式异步实时操作系统的调度模块,它通过Rust提供的协程机制,结合embassy的异步执行器的实现方式,并借鉴传统嵌入式实时操作系统uCOSII的任务切换机制,在任务调度时实现了一套创新的内存管理和实时性保证机制。
在传统嵌入式实时操作系统(如uCOSII)中,每个任务都占有一个私有的栈空间,但在实际应用中,大部分任务释放CPU都是由于主动让权,而非被高优先级的任务抢占,这使得栈空间存在一定的浪费。而在embassy中,虽然通过引入Rust的协程机制使得栈空间的利用率得到了极大的提升,但是由于协程之间无法进行抢占,并且没有优先级裁决机制,导致在多任务场景下实时性较差。
Embassy Preempt在这两者之间进行了”折衷”,实现了一个既可以满足实时应用环境下的实时性要求,又可以尽可能缩小内存使用的嵌入式异步实时操作系统调度模块。其核心在于:
- 混合任务调度:支持Rust原生协程作为任务,兼容传统uCOSII API接口
- 动态栈空间管理:主动让权时进行栈复用,被抢占时进行栈分配和现场保存
- 抢占式内核:支持高优先级任务抢占低优先级任务=
2025年11月以来,项目重点进行了RISC-V平台支持的开发,特别是在VisionFive2(JH7110)开发板上实现了完整的AMP方案:S7核心运行Embassy Preempt处理实时任务,U74核心运行StarryOS处理通用计算,两系统间实现了Notification和RPC的双向通信机制。
系统架构
1 | graph LR |
系统特性
支持rust原生协程作为task
Embassy Preempt完全支持Rust原生的async/await语法,开发者可以使用标准的异步函数作为实时任务。这种支持基于Rust的Future trait,通过执行器的poll机制驱动异步任务执行。
核心特性:
- 原生异步语法:直接使用
async fn定义任务,配合.await进行异步等待 - 零成本抽象:协程在编译期转换为状态机,无运行时开销
- 统一的任务模型:异步任务与同步任务在同一调度器中管理
- 优先级支持:协程任务可以设置优先级,参与抢占式调度
任务创建示例:
1 | use embassy_preempt_executor::AsyncOSTaskCreate; |
执行机制:
协程任务的执行通过执行器的poll函数驱动。当协程遇到.await点时,会将控制权交还给调度器,调度器可以选择:
- 继续poll当前协程(如果未完成)
- 切换到其他就绪任务
- 进入低功耗状态(如果无就绪任务)
这种机制使得协程在主动让权时不需要保存完整的栈上下文,因为所有的局部变量都存储在Future的状态机中,而非栈上。
ucosii api兼容
Embassy Preempt提供了与传统uCOSII RTOS兼容的API接口,使得现有的嵌入式代码可以轻松迁移。
主要兼容接口:
- OSTaskCreate/OSTaskCreateExt - 任务创建 (源代码)
- OSTimeDly - 任务延迟 (源代码)
- OSTimeDlyHMSM - 按时分秒延迟
- OSSemCreate/OSSemPend/OSSemPost - 信号量操作 (源代码)
使用示例:
1 | // C风格任务创建 ([源代码](https://github.com/Oveln/embassy_preempt/blob/a708bb1ea723da795e79d672916791790e841dd5/modules/embassy-preempt-executor/src/os_task.rs#L43-L76)) |
统一调度机制:
在系统内部将任意sync函数视作单个Future,使得所有task能被统一调度
动态栈空间使用
Embassy Preempt实现了创新的动态栈空间管理机制,根据任务调度方式智能选择栈分配策略,最大化内存利用率。
内存设计:
- 栈复用:主动让权时共享栈空间,避免内存浪费
- 按需分配:仅在发生抢占时分配私有栈
两种调度模式:
让权模式(主动让权)
- 任务通过
.await主动让出CPU - 所有协程共享同一个程序栈
- 无需保存完整栈上下文(局部变量在Future状态机中)
- 栈空间利用率最高
- 任务通过
抢占模式(被动切换)
- 高优先级任务抢占低优先级任务
- 当前程序栈分配给被抢占任务保存上下文
- 立即分配新栈供系统继续运行
- 恢复执行时可能回收私有栈(如果任务再次让权或完成)
栈分配器实现:
采用固定大小块分配算法 (源代码),支持8种栈大小:
1 | const STACK_SIZES: [usize; 8] = [ |
根据Qemu平台的测试数据(64任务场景):
- 动态栈开销:120KB(峰值时约7个任务同时拥有私有栈)
- uCOSII固定栈:256KB(每任务4KB)
- 内存节省:约53%
这种设计既保持了抢占式RTOS的实时性,又最大程度地降低了内存占用,特别适合资源受限的嵌入式系统。
上下文切换性能
基于QEMU RISC-V平台的精确指令计数测试,Embassy Preempt展现了高效的上下文切换性能。
测试环境:
| 项目 | 参数 |
|---|---|
| 测试平台 | QEMU RISC-V |
| 架构 | RISC-V 64位 |
| 测试方法 | 指令计数 |
| 测试流程 | 从发起上下文切换请求到处理完成 |
| 测试项 | 指令数 | 说明 |
|---|---|---|
| 完整上下文切换 | 378条指令 | 从请求到完成的完整流程 |
在实际平台上运行会因为cache miss等原因大于378时钟周期,具体表现在visionfive2的部分会有比较
Embassy Preempt On VisionFive2
S7核心适配
VisionFive2开发板上的JH7110处理器有5个核心,其中S7核心(hart0)专门运行Embassy Preempt。
S7核心特点:
| 特性 | S7核心 |
|---|---|
| 指令集 | RV64IMAC(整数+乘法+压缩) |
| 浮点 | 无 |
| 原子指令 | 不支持CAS,需要软件模拟 |
| 缓存 | 仅有I cache,无D cache |
| 运行位置 | L2 Cache Lim区域 |
S7核心不支持S态,只能运行在M态,这意味着不需要OpenSBI层,可以直接访问硬件,减少了中断延迟。
L2 Cache Lim配置:
L2 Cache Lim是JH7110中L2 Cache的特殊功能,disabled的cache ways可以直接作为内存寻址,提供确定的访问时间。
配置原理:
- 总共2MB = 16 ways × 128KB
- 复位状态:只有way 0是cache,其他15个ways都是disabled(可作为L2 LIM)
- Enable规则:通过WayEnable寄存器enable ways,从最低编号way开始
- 地址映射:最高编号way映射到最低L2 LIM地址
- 一旦enable就不可disable,除非系统复位
启动流程与SPL自搬运:
初始状态下,这块低内存区域(0x800_0000)被SPL使用。启动流程如下:
- SPL阶段:SPL搬运opensbi、uboot、embassy_preempt到对应内存位置
- U-Boot阶段:需要初始化cache2驱动
为了给Embassy Preempt腾出L2 LIM空间,做了以下修改:
1. SPL自搬运
- 新增
arch/riscv/cpu/spl_relocate.S(适用于多核的自搬运算法) - 将SPL自身从
0x800_0000搬运到0x808_0000 - 修改
u-boot-spl.lds链接脚本 - 这样让出了低内存的512KB空间
2. Cache2驱动修改
- 添加
sifive,max-enabled-ways设备树选项 - 修改
cache-sifive-ccache.c驱动 - 只enable way 0~11作为cache(12个ways,1.5MB)
- 保持way 12~15为disabled状态(4个ways,512KB)
最终内存布局: (源代码 - memory.x)
1 | 0x800_0000 ┌───────────────────────┐ |
Embassy Preempt的代码段通过链接脚本放置在L2 LIM区域(0x800_0000),享受确定的访问延迟,不会有cache miss。
StarryOS兼容
VisionFive2的另外4个U74核心(hart1-4)运行StarryOS操作系统。
U74核心特点:
| 特性 | U74核心 |
|---|---|
| 指令集 | RV64GC(完整指令集) |
| 浮点 | 支持双精度浮点 |
| 原子指令 | 完整支持 |
| 缓存 | 完整L1 + 共享L2 |
U74核心性能比S7核心强,有浮点单元和完整的原子指令,适合运行通用计算任务。
StarryOS基于ArceOS,支持多核SMP模式。hart1-4核心通过OpenSBI启动,然后uboot加载StarryOS内核,走的是标准的RISC-V启动流程,使用SBI接口访问硬件。
这与hart0直接运行Embassy Preempt不同:hart0在M态直接运行,而U74核心在S态运行,保持了与传统RISC-V Linux系统的兼容性。
双系统通信
S7核心的Embassy Preempt与U74核心的StarryOS之间通过ov_channel库实现双向通信。
ov_channel库简介:
ov_channel是一个为该场景特殊设计的双系统共享内存通信库,专门设计用于裸机环境下的高效通信。这个库基于环形缓冲区实现无锁通信。
主要特性:
no_std- 基于环形缓冲区的无锁通信
- 四种消息类型:Notification(通知)、Data(数据)、RPC Request/Response(远程过程调用)
- 每个消息256字节,包含1字节类型标识和255字节负载数据
- 支持类型安全的RPC调用,使用postcard二进制序列化
测试验证:
该库已经在x86和RISC-V 64位平台上进行了充分测试,验证了跨平台兼容性和正确性。
MSIP中断通知机制:
两系统间通过MSIP(Machine Software Interrupt)寄存器实现中断通知:
StarryOS → Embassy Preempt
- StarryOS写入共享内存消息
- 通过OpenSBI扩展SBI接口触发MSIP0中断
- Embassy Preempt的MSI中断处理函数被调用
- 唤醒
wait_for_ipi().await等待的任务 - 处理共享内存中的消息
Embassy Preempt → StarryOS
- Embassy Preempt写入共享内存消息
- 直接写MSIP1寄存器触发hart1的SSI中断
- StarryOS的IPI设备驱动处理中断
- 读取并处理共享内存中的消息
对于StarryOS来说,ov_channal所在的内存区域是一块mmio设备
RPC通信流程:
1 | StarryOS 发起RPC调用: |
实际应用示例:
在embassy_preempt_app_Visionfive2中实现了RPC服务器,支持的方法包括:
HELLO_WORLD: 测试方法ADD: 加法运算
任务可以通过wait_for_ipi().await (源代码) 异步等待来自StarryOS的RPC调用或Notification。
性能比较
与官方在VisionFive2大核心(U74)上移植的RT-Thread AMP方案进行性能对比。
| 对比项 | Embassy Preempt | RT-Thread |
|---|---|---|
| 运行核心 | S7 (hart0) | U74 |
| 指令集 | RV64IMAC | RV64GC |
| 浮点单元 | 无 | 双精度浮点 |
| 数据缓存 | 无 | 完整L1+L2 |
| 上下文切换 (源代码) | 1.25~2.48 μs | 平均1μs,最大2μs |
| 核间通信 | RPC: 3.585~4.669 μs | IPI: ~25μs,最大70μs |
核心优势:
上下文切换:在无数据缓存的S7核心上,实现了与U74核心上RT-Thread相当的调度性能
核间通信:通过软件中断提醒,通过ov_channal的延迟比官方AMP方案的延迟低约5~6倍,主要得益于共享内存通信和协程异步模型
资源利用:动态栈管理机制在64任务场景下相比传统固定栈方案节省约53%内存
相关链接
- 源代码仓库:Oveln/embassy_preempt — 项目主仓库,包含所有模块源码
- 汇报仓库:Oveln/embassy_preempt_on_Visionfive2-2026-04-19 — VisionFive2平台适配的汇报材料
- 开发日志:项目开发过程中的提交记录和设计决策可通过上述仓库的 Git 提交历史查阅
2026开源社区实习总结
AxVisor 中统一 eBPF Tracing 系统的设计与实现
摘要
本文总结了在 AxVisor 中构建统一 eBPF tracing 系统的阶段性工作。系统面向 VMM、Guest Kernel 和 Guest Userspace 三个执行层次,目标是把分散的事件源接入同一条程序装载、命中处理、运行时执行和事件输出链路中。实现过程中,先建立了 tracepoint、runtime、map、helper 和统一事件流等基础设施,再逐步扩展到 hprobe/hretprobe、guest-kprobe/kretprobe 与 guest-uprobe/uretprobe。其中,userspace tracing 重点解决了对象元数据装载、运行期激活、实例管理和生命周期回收等问题。最终形成了一套可以继续扩展、并已具备联调与验收路径的 tracing 基础框架。
实习技术报告:StarryOS 内核模块按需加载与 FUSE 用户态文件系统驱动实现
摘要
StarryOS 作为基于 Rust 的宏内核操作系统,已在前序工作中引入了可加载内核模块(LKM)基础设施,但彼时仅支持显式手动加载。本文在此基础之上,设计并实现了 ondemand-kmod——一个通用的 #![no_std] 按需加载内核模块框架,支持懒加载(lazy loading)与空闲超时自动卸载(idle unloading)。该框架将”何时加载”的策略与”怎么加载”的机制彻底解耦,形成一个可复用的独立库。
随后,该框架深度集成进 StarryOS,先后实现了 procfs 与 FUSE 两个真实模块的按需加载。在 FUSE 方向,本文从零手写了内核侧驱动 Starryfuse,包含基础 FUSE 协议解析、字符设备通信、VFS 桥接与阻塞读/poll 多路复用支持;将其包装为 fuse.ko 可加载模块,并开发了三组用户态测试程序,在 QEMU/RISC-V 环境下验证了从首次 open("/dev/fuse") 触发加载到空闲卸载、内存回收的完整生命周期。
关键词:StarryOS;按需加载内核模块;FUSE;用户态文件系统;Rust;RISC-V
1. 引言
1.1 背景
StarryOS 是一个基于 Rust 的宏内核操作系统,底层依托 ArceOS 的模块化架构。之前有同学为 StarryOS 引入了完整的 LKM 机制:内核能够在运行期动态加载 ELF 格式的 .ko 文件,完成重定位、符号解析并执行模块的 init/exit 函数。
然而,当时的 LKM 仅支持显式手动加载(insmod 语义)。对于 procfs、FUSE 这类并非始终活跃的子系统,如果将其静态编译进内核,会造成启动时内存与体积的浪费;如果完全手动管理,又增加了系统管理员的负担。因此,有必要在 LKM 基础之上构建一套按需加载框架,使内核模块能够在首次被访问时自动装载,在空闲超时时自动卸载并回收资源。
1.2 设计目标
围绕上述背景,本文工作围绕以下核心目标展开:
- 按需加载:当用户态首次访问某功能(如打开
/dev/fuse或/proc/meminfo)且 VFS 返回NotFound时,系统自动加载对应模块并重试。 - 自动卸载:模块在空闲(无引用、无打开文件描述符)超过设定时间后,自动卸载并释放物理内存。
- 策略与机制解耦:将”何时加载”的策略与”怎么加载”的机制分离,形成可复用的独立框架。
- FUSE 完整闭环:实现内核侧 FUSE 驱动,支持标准 Linux FUSE ABI,使用户态守护进程能在 StarryOS 中挂载并操作虚拟文件系统。
1.3 报告结构
本文剩余章节安排如下:第 2 节介绍相关工作与背景;第 3 节阐述 ondemand-kmod 框架与 FUSE 按需加载的系统架构;第 4 节详细描述实现细节;第 5 节介绍测试验证方案与结果;第 6 节总结全文并展望未来工作。
2. 相关工作与背景
2.1 StarryOS 的 LKM 基础设施
前序工作为 StarryOS 引入了完整的 LKM 支持,包含 ELF 解析器、符号重定位器(ksym)以及模块加载器(kmod-loader)。内核能够在运行期读取 .ko 文件,将其映射到独立的虚拟地址空间,解析未定义符号并回填地址,最终调用模块入口函数。这一基础设施为按需加载提供了”怎么加载”的底层能力,但缺乏”何时加载”的自动化策略层。
2.2 已有按需加载实践
AlloyStack:面向Serverless按需加载的库操作系统。该项目作为libos实现了模块按需自动加载,服务于云函数运行。
本项目开发初期,对于StarryOS 的 procfs 文件系统也尝试过”懒挂载”(lazy mount)——在启动时注册挂载点工厂函数,首次访问时才真正挂载文件系统。后期因FUSE测试需要,将procfs重归静态加载。
2.3 StarryOS 面临的独特挑战
与 Linux 相比,StarryOS 的按需加载面临若干独特挑战:
- Rust
#![no_std]环境:无法使用std::sync::Mutex、std::thread等标准库设施,所有并发控制必须基于自旋锁和内核原语。 - 跨模块符号解析:模块与主内核之间的符号绑定通过
KALLSYMS字典完成,需要处理 Rust Nightly 裁剪导致的符号缺失问题。 - RISC-V QEMU 调试环境:物理内存固定,模块加载/卸载的内存行为需要可观测、可量化,以验证按需加载的实际收益。
- VFS 上下文安全:动态加载的文件系统模块不能在中断上下文或持有全局锁时执行可能阻塞的操作。
- 缺乏现有 FUSE 内核态驱动 Rust 实现借鉴:现有 FUSE Rust 实现开源项目仓库均为用户态侧设计,为Linux系统适配。
3. 系统架构与设计
3.1 整体架构
StarryOS 的按需加载系统组成部分:
ondemand-kmod:独立的#![no_std]Rust 库,提供通用的模块生命周期管理。api/src/kmod/ondemand.rs:StarryOS 内核集成层,桥接框架与现有 LKM 基础设施。api/src/kmod/ondemand_builtin.rs: 负责具体模块注册加载卸载触发逻辑。
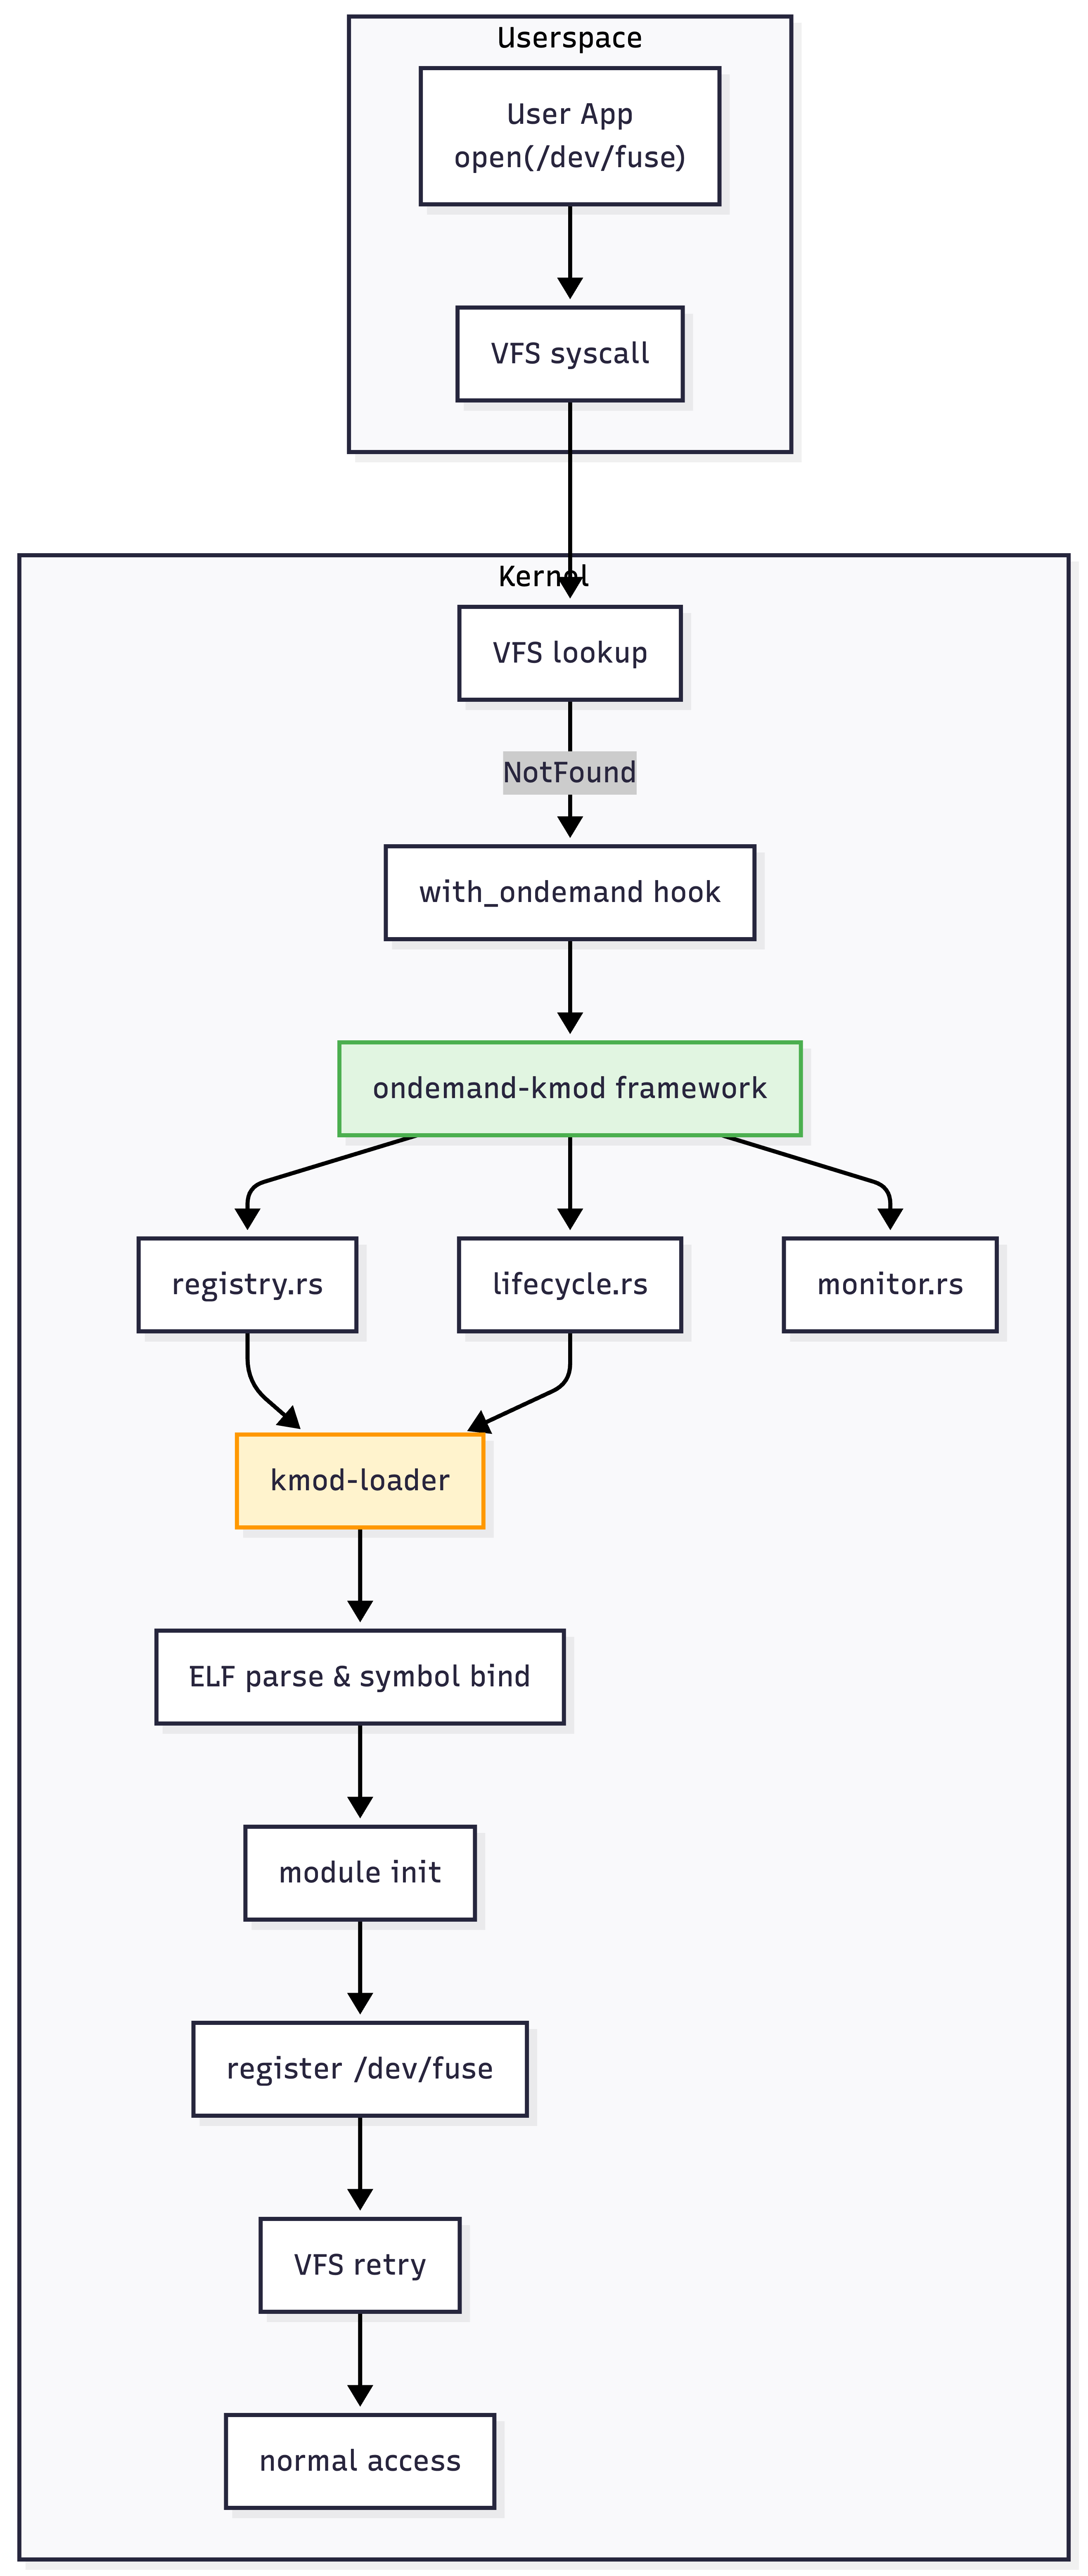
当用户态程序访问某个路径(如 /dev/fuse)时,VFS 层通过 with_ondemand() 钩子捕获 NotFound 错误,触发 ondemand-kmod 加载对应的 .ko 文件;模块初始化完成后,VFS 操作自动重试。空闲时,后台监控任务通过三阶段卸载算法安全回收模块内存。
图 1 展示了按需加载系统的整体架构。图中上侧为用户态进程,下侧为内核态组件。用户态的首次访问沿 VFS 路径向下传播,若目标不存在则进入 with_ondemand 重试路径;框架层的 registry 与 lifecycle 负责状态转换;底层通过 kmod-loader 实际完成 ELF 加载。
如果图片显示失败,图片链接:https://github.com/DINGBROK423/ondemand-kmod/blob/main/doc/report_figures/p1.png
3.2 模块生命周期状态机
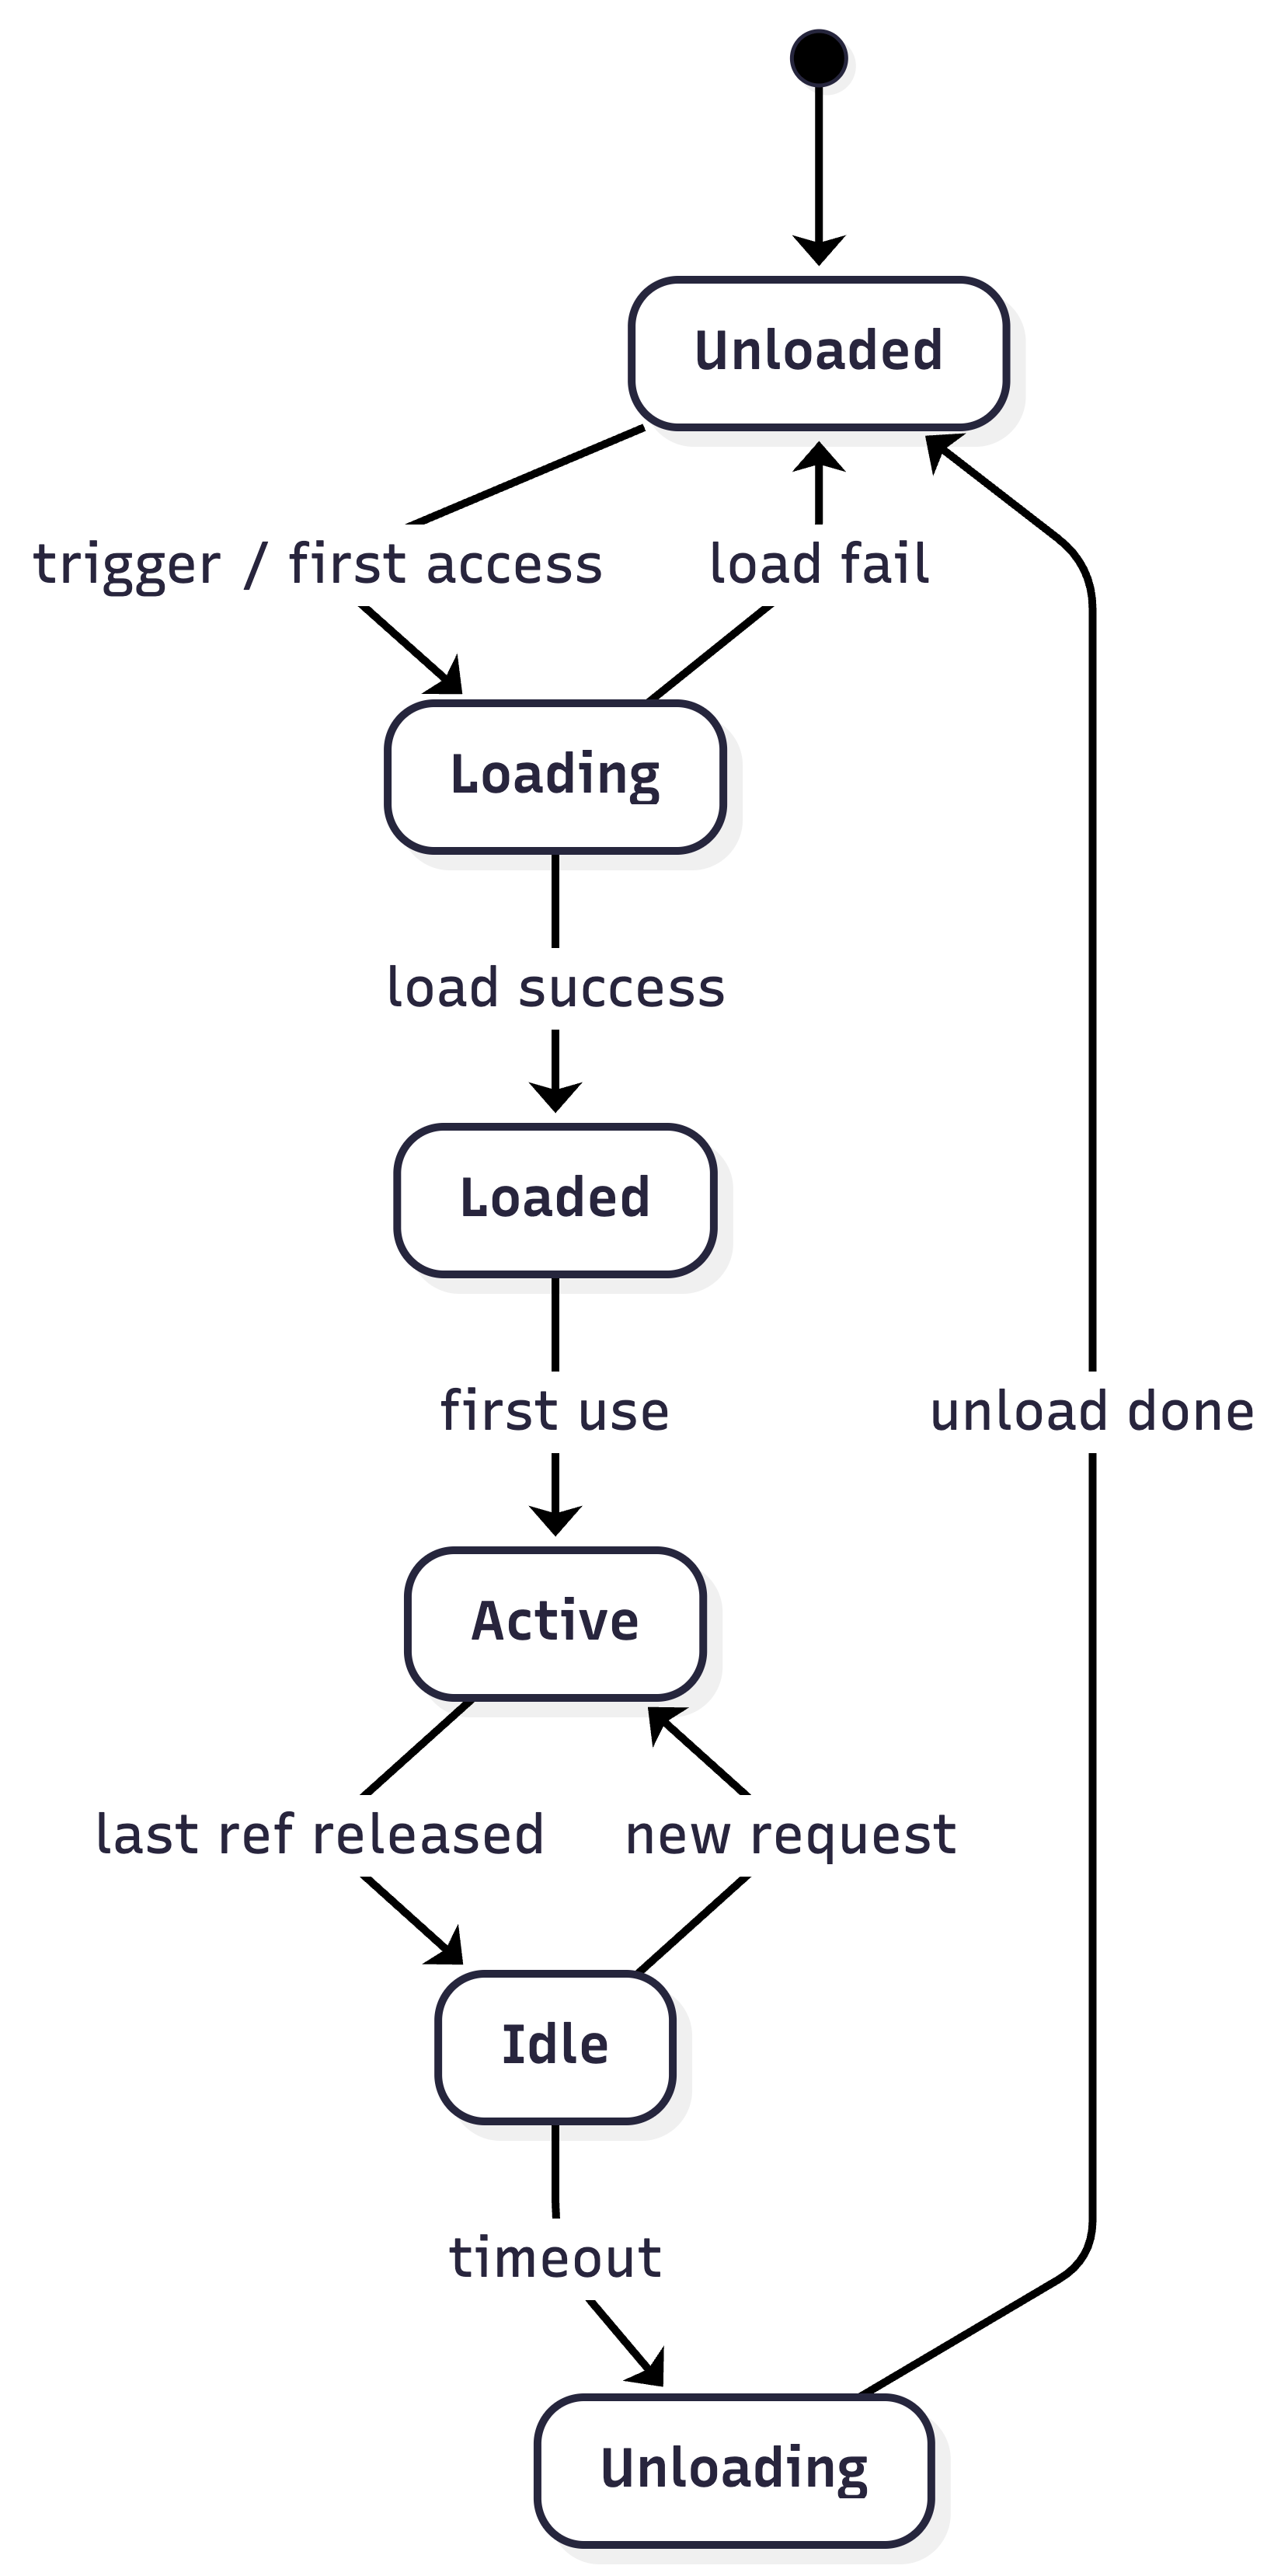
ondemand-kmod 使用六状态有限状态机(FSM)描述模块的生命周期:
Unloaded:初始状态,模块尚未加载。Loading:正在执行 ELF 加载与符号解析。Loaded:模块已成功初始化,可供使用。Active:模块正被使用(存在打开的文件描述符或挂载点引用)。Idle:模块已加载但当前无活跃引用。Unloading:正在执行模块退出函数并回收内存。
状态转换遵循以下规则:
Unloaded --(触发器/首次访问)--> LoadingLoading --(成功)--> Loaded --> ActiveActive --(最后一个引用释放)--> IdleIdle --(超时 / 空闲时间达到阈值)--> UnloadingIdle --(新的访问请求)--> ActiveUnloading --(完成)--> Unloaded
图 2 为六状态生命周期状态机示意图。
如果图片显示失败,图片链接:https://github.com/DINGBROK423/ondemand-kmod/blob/main/doc/report_figures/p2.png
3.3 安全卸载的三阶段算法
自动卸载是按需加载框架中最容易出错的环节,因为模块可能仍被内核数据结构间接引用。ondemand-kmod 采用三阶段卸载算法保证安全:
- 标记阶段(Mark):将模块状态从
Idle迁移到Unloading,禁止新的引用获取。 - 等待阶段(Quiesce):等待所有已存在的引用释放。对于
procfs,这意味着等待所有打开的/proc/xxx文件关闭;对于 FUSE,这意味着等待所有/dev/fuse文件描述符关闭以及 VFS 挂载点解除。 - 回收阶段(Teardown):调用模块的
exit函数,解除符号绑定,释放 ELF 占用的物理页,最终将状态迁移回Unloaded。
3.4 VFS 层触发重试机制
为了避免在每个系统调用路径中手动插入加载逻辑,StarryOS 在 VFS 层引入了一个通用函数 with_ondemand()。当 VFS 操作(如 lookup、open、read)返回 NotFound 时,该函数会:
- 检查失败路径是否匹配某个已注册的按需加载触发器(如
/proc/*对应procfs.ko,/dev/fuse对应fuse.ko)。 - 若匹配,则调用
ondemand-kmod::try_load()尝试加载。 - 加载成功后,自动重试原始的 VFS 操作。
- 若加载失败或重试后仍返回错误,则将错误返回给用户态。
这种设计的关键优势在于:触发逻辑对上层完全透明,无论是用户态程序、libc 还是 Shell,都不需要任何修改。
3.5 Starryfuse 内核驱动架构
Starryfuse 是 StarryOS 中 FUSE 的内核侧实现,被包装为 fuse.ko 可加载模块。其内部采用四层架构:
abi层:FUSE 协议数据结构的 Rust 定义,严格对齐 Linux FUSE ABI(如fuse_in_header、fuse_out_header、fuse_init_in、fuse_init_out)。dev层:字符设备/dev/fuse的实现,负责内核与用户态守护进程之间的字节流传输。包含FuseDev结构体、PollSet多路复用、以及WaitQueue阻塞/唤醒机制。vfs层:VFS 桥接层,将 StarryOS 的axfs_vfs操作(lookup、read、write、readdir等)翻译为 FUSE 请求,通过dev层发送给用户态守护进程,再将其响应翻译回 VFS 语义。lib层:starry_fuser用户态库,封装了与Starryfuse内核驱动的交互细节,使开发者能够像使用libfuse一样编写用户态文件系统。
图 3 展示了 FUSE 按需加载执行的完整时序。
如果图片显示失败,图片链接:https://github.com/DINGBROK423/ondemand-kmod/blob/main/doc/report_figures/p3.png
图 4 展示了 Starryfuse 内核驱动的分层架构。
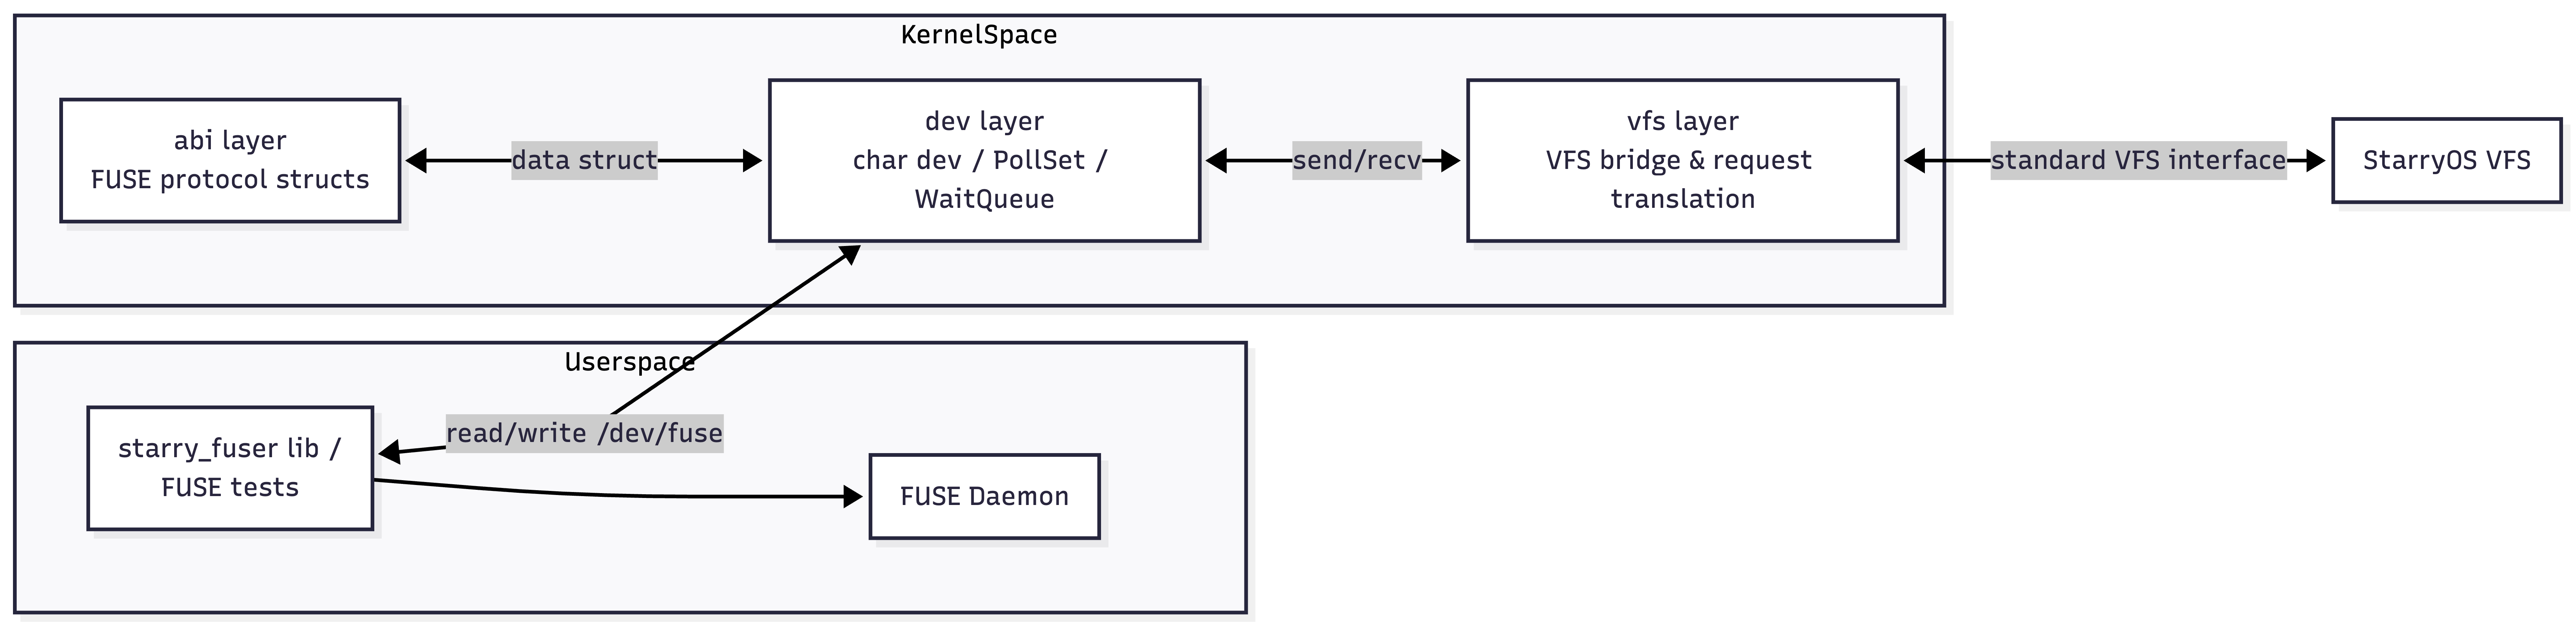
如果图片显示失败,图片链接:https://github.com/DINGBROK423/ondemand-kmod/blob/main/doc/report_figures/p4.png
4. 实现细节
4.1 ondemand-kmod 框架实现
ondemand-kmod 被设计为一个独立的 #![no_std] Rust crate,核心文件包括:
registry.rs:维护一个全局的模块注册表,记录每个模块的名称、触发器(路径前缀或设备号)、.ko文件路径、超时阈值以及当前状态。lifecycle.rs:定义六状态 FSM 的State枚举、ModuleDesc模块描述符、ModuleGuardRAII 引用计数守卫以及ManagedModule运行时 bookkeeping 结构。状态转换的实际逻辑由registry.rs(on_access处理加载触发与状态迁移动作)和monitor.rs(tick中完成Active→Idle迁移及卸载决策)驱动。monitor.rs:实现IdleMonitor::tick()三阶段卸载算法。Phase 1 持锁扫描注册表,将引用计数为零且空闲超时的模块从Idle标记为Unloading;Phase 2 在无锁环境下调用ModuleLoader::unload()执行实际卸载;Phase 3 再次持锁将成功卸载的模块状态回写为Unloaded。该函数由api/src/kmod/ondemand.rs的tick_ondemand()定期调用。
框架通过 ModuleLoader trait 与具体的操作系统解耦,定义了 load()、unload() 等方法。StarryOS 在 api/src/kmod/ondemand.rs 中提供 KmodOnDemandLoader 结构体作为该 trait 的具体实现,其内部调用现有的 kmod-loader 与 axalloc 内存管理接口。
4.2 with_ondemand VFS 集成
with_ondemand 是一个泛型函数,其实现位于 api/src/kmod/ondemand.rs。以 lookup 为例:
1 | with_ondemand(&path, || fs.resolve(&path)) |
函数调用逻辑:
- 首次调用闭包
vfs.lookup(path)。 - 若返回
Err(NotFound),提取路径中的前缀,查询registry是否有匹配。 - 若有匹配,调用
try_load();加载成功后继续下一次循环(重试)。 - 若返回其他错误或连续重试次数超过上限,则直接返回错误。
该函数被包裹在 open、stat、chmod、chown 等关键系统调用路径中,确保几乎所有文件系统操作都能触发按需加载。
4.3 FuseDev 的并发与同步重构
早期的 /dev/fuse 实现使用单线程自旋锁保护整个设备状态,导致当守护进程阻塞在 read 等待请求时,其他线程无法并发写入新请求。为此,本文对 FuseDev 进行了并发重构:
- 引入
PollSet:支持多线程同时poll,read通过WaitQueue串行服务,内核可以在任意线程上向PollSet投递可读/可写事件。 - 引入
WaitQueue:当没有待处理请求时,read调用将当前任务挂起到WaitQueue;当有新的 VFS 请求到达时,由vfs层唤醒等待队列中的任务。 - 锁安全:调用文件系统函数时先短暂拿锁检查请求队列,无数据则立即释放锁,再通过外部 WaitQueue 安全阻塞睡眠,消除”持自旋锁睡眠”导致的死锁风险。
4.4 vfs.rs 的协议桥接
vfs.rs 是 Starryfuse 中最复杂的模块,负责将 StarryOS VFS 的语义映射到 FUSE 协议。
Opcode 映射:vfs.rs 中所有 FUSE 请求的 opcode 均严格对照 Linux 内核头文件定义,确保与用户态守护进程的协议语义一致。例如 FUSE_INIT 使用 opcode 26,与标准 FUSE ABI 对齐。
INIT 协议握手:FuseFs::new() 注册文件系统后,在独立内核线程中异步发起 FUSE_INIT 握手,避免阻塞 sys_mount。构造 FuseInitIn 请求体携带主版本号、次版本号与 max_readahead 等能力字段下发至用户态守护进程,解析返回的 FuseInitOut 完成协议版本确认。
4.5 用户态 starry_fuser 库
对接外部fuse用户侧驱动,处于开发中。
5. 测试与验证
5.1 测试内容
为验证按需加载与 FUSE 功能的正确性,本文设计了三组测试程序:
fuse_test:基础功能测试,验证/dev/fuse的按需加载、FUSE_INIT 握手、简单的lookup/read/readdir以及空闲卸载。fuse_rw_test:读写功能测试,验证write+read闭环、文件截断覆盖、目录创建与遍历。fuse_mem_test:内存与稳定性测试,通过单次加载/卸载 FUSE 模块并读取内核内存快照,观测内存占用是否回归基线,检测是否存在内存泄漏。
5.2 测试环境
- 目标平台:
riscv64gc-unknown-none-elf - 运行环境:QEMU 7.2+
virt机器 - 内核配置:开启
KALLSYMS、LKM、ONDEMAND_KMOD、FUSE - 测试方式:在 QEMU 中运行 StarryOS,启动测试程序,串口输出日志
5.3 测试结果
5.3.1 fuse_test
注:空闲卸载触发时间:5 s
测试日志:
1 | [318.750672 0:11 kmod_loader::loader:354] Module(Some("fuse")) loaded successfully! |
5.3.2 fuse_rw_test
测试日志:
1 | [ 15.872268 0:11 kmod_loader::loader:354] Module(Some("fuse")) loaded successfully! |
5.3.3 fuse_mem_test
测试日志:
1 | [ 8.163909 0:11 kmod_loader::loader:354] Module(Some("fuse")) loaded successfully! |
对日志中的内存数据整理如 表 1 与 表 2 所示。
表 1:内存快照原始数据
| Phase | RustHeap (B) | Δ RustHeap | Pages | Δ Pages |
|---|---|---|---|---|
| Before load | 8,315,080 | — | 4,762 | — |
| After load | 8,862,712 | +547,632 | 4,779 | +17 |
| Before unload | 8,352,536 | +37,456 | 4,788 | +26 |
| After unload | 8,351,108 | +36,028 | 4,771 | −17 |
表 2:内存占用构成分析
| Configuration | Size (KB) | Pages | Contribution |
|---|---|---|---|
| A. Static baseline (fuse.ko + starryfuse resident) | 1,071 | — | baseline |
| ‑ fuse.ko | 416 | — | — |
| ‑ starryfuse libs | 655 | — | — |
| B. On-demand mapped pages (loader vmalloc) | 68 | 17 | actual load |
| D. Runtime overhead (mount/fork/VFS, transient) | 36 | 9 | transient |
| Memory saving vs static baseline | 1,071 | — | resident reduction |
从 表 1 可见,按需加载在 After load 阶段使内核页数增加了 17 页(约 68 KB),这是 kmod-loader 通过 vmalloc 映射 .ko 产生的实际内存开销。经过 FUSE 自测试验、卸载挂载点并等待 7 s 空闲超时后,模块进入 Unloading 状态,KmodMem::drop 逐页释放物理内存,最终 After unload 页数相比 After load 回落 17 页,证明模块占用的 ELF 内存被完全回收。
测试前后页数从 4,762 增至 4,771(+9 页,约 36 KB),这部分增量属于 mount/fork/VFS 等运行时 transient 开销,并非模块泄漏。
表 2 进一步量化了按需加载的收益:若将 fuse.ko(416 KB)与 starryfuse 依赖库(655 KB)静态编译进内核,常驻内存开销约为 1,071 KB;而按需加载模式下,FUSE 模块卸载后常驻 footprint 降至约 0 KB,实际节省内核常驻内存 1,071 KB。
6. 结论与未来工作
6.1 工作总结
本文设计并实现了 ondemand-kmod——一个面向 #![no_std] 环境的通用按需加载内核模块框架,并将其成功集成到 StarryOS 中。在此基础上,本文完成了 procfs 与 FUSE 的按需加载闭环。对于 FUSE,本文从零实现了内核侧驱动 Starryfuse,涵盖协议解析、字符设备通信、VFS 桥接与用户态库,支持了完整的 FUSE 文件系统生命周期。
6.2 未来工作
- 块设备文件系统按需加载:当前框架主要面向用户态文件系统与伪文件系统。未来可将其扩展至
ext4、fat32等块设备文件系统。 - 完善
starry_fuser功能集:补充FUSE_MKNOD、FUSE_IOCTL等高级操作码,提升与现有libfuse的兼容性。 - vDSO 与系统调用优化:探索将部分 FUSE 请求路径通过 vDSO 优化,减少用户态/内核态切换次数。
7.相关链接
自动测试系统 与 EEVDF 调度器实习三个月技术总结
自动测试系统 与 EEVDF 调度器实习三个月技术总结
摘要
本报告汇总实习三个月在测试系统和 EEVDF 调度算法的技术产出。测试工程方面:在 AxVisor 中推进 QEMU CI 稳定性,统一 ArceOS/Linux/NimbOS 环境准备脚本、补充中英文快速上手文档,并以 PTY 驱动 NimbOS 自动化与 fail_regex 等增强失败可观测性;在 github-runners 中基于 flock 建立多组织共享开发板的 per-board 硬件锁,迭代修复取消路径竞态与僵尸锁问题;在 axci 中设计规则驱动、依赖感知的自动测试目标选择,结合 git diff、反向依赖图与可配置规则缩小无关全量测试范围。内核方面:在 StarryOS 分支上实现 EEVDF 调度器(双索引、deadline 抢占、统计与文档/单测/演示脚本闭环),并完成 per-CPU 异构调度与 QEMU 下代表性延时与切换行为验证。
自动测试系统
1. AxVisor QEMU CI 稳定性改进
- 链接:PR #363
- 合并状态:已合并(Merged)
- 贡献规模:26 commits,18 个文件变更,
+678 / -19
背景问题
在 AxVisor 的 QEMU 自动化测试中,存在以下痛点:
- 不同 Guest(ArceOS / Linux / NimbOS)环境准备流程分散,维护成本高;
- NimbOS 场景依赖交互式输入,CI 中容易出现“测试通过但任务失败”的误报;
- 失败信号不够明确,panic 等异常无法被尽早识别。
关键工作
- 统一环境准备入口
- 新增 scripts/setup_qemu.sh,统一支持
arceos/linux/nimbos三类 Guest; - 自动执行镜像下载、配置 patch、rootfs 准备,减少手工步骤和路径错误。
- 补齐文档与上手路径
- 新增中英文 QEMU 快速上手文档:doc/qemu-quickstart.md、doc/qemu-quickstart_cn.md,沉淀从依赖安装到三类 Guest 运行的完整流程;
- 在 README 中增加快速入口:README.md、README_CN.md,降低新成员接入成本。
- 增强 NimbOS 测试可自动化能力
- 新增 scripts/ci_run_qemu_nimbos.py,通过 PTY 方式启动子进程,保障 CI 环境下输入可正确透传;
- 识别 shell 提示后自动触发
usertests,并在命中usertests passed!时返回正确退出码。
- 提升 CI 失败可观测性与可诊断性
- 在 QEMU 配置中补充
fail_regex(如panicked at),尽早暴露 guest panic; - 对 NimbOS 启动依赖(
axvm-bios.bin)进行前置校验,避免隐式失败。
结果与价值
- 测试稳定性:修复了 NimbOS 在 CI 中的交互与退出码问题,显著降低误报失败;
- 工程效率:统一 setup 脚本后,减少重复脚本与人工排障成本;
- 可维护性:流程与文档标准化后,跨场景测试可复用性更高;
- 团队协作:将经验固化为脚本与文档,便于后续同学复用与扩展。
2. 多组织 GitHub Runner 硬件锁机制建设(github-runners)
背景问题
在多组织共享开发板资源时,Runner 缺乏统一锁机制,容易出现并发抢占、取消后资源未释放、锁粒度不一致等问题,导致 CI 任务互相干扰、排队时间增加、故障定位困难。
实现原理(文件锁)
- 方案基于 Linux 文件锁(
flock)实现互斥:将每块开发板抽象为一个 lock file,同一时刻仅允许一个 Runner 持有该文件的独占锁; - 锁粒度为 per-board:同一块板上的任务互斥,不同开发板对应不同锁文件,可被不同 Runner 并行使用;
- 任务启动时先尝试获取独占锁,获取成功后进入执行阶段,失败则等待或退出,避免多任务并发抢占同一硬件;
- 在正常结束、失败或 Cancel 路径统一执行解锁与清理,降低异常中断后残留“僵尸锁”的概率。
关键工作(按迭代演进)
- 为多组织共享硬件引入 runner-wrapper 锁包装能力(实现见 runner-wrapper.sh);
- 将锁能力集成进 runner.sh 工作流,并补齐使用文档,形成可落地的基础方案。
- 标准化锁标识与隔离策略(PR #4)
- 将板子锁 ID 收敛到 per-board 默认策略;
- 将容器命名自动拼入 org/repo 维度,降低跨组织任务冲突概率。
- 加固多组织 Runner 锁机制,修复 cancel 场景下的并行竞态问题;
- 将 cancel watcher 与
docker compose生命周期集成,随 Runner 一起启动/回收,对使用者基本无感; - 支持在 Cancel 路径自动释放开发板锁,减少“僵尸锁”导致的资源阻塞;
- 持续补充文档,降低维护门槛并提升团队可复用性。
结果与价值
- 资源利用率:降低开发板被异常占用的概率,提升共享硬件可用性;
- 流程鲁棒性:在取消、失败等非理想路径下也能保证锁释放;
- 并发安全性:减少跨组织并行任务互相抢占与串扰;
- 可运维性:锁策略、命名规范和文档沉淀后,问题定位更快、迁移成本更低。
3. axci 规则驱动自动目标选择与测试链路重构
- 链接:PR #9
- 当前状态:Open(待合并)
- 变更规模:39 commits,21 个文件变更,
+4071 / -397
背景问题
在 CI 全量测试模式下,存在“变更范围小但测试范围大”的问题,导致执行耗时长、资源利用率偏低;同时,测试脚本长期演进后出现结构耦合,扩展与维护成本上升。
实现原理(依赖感知自动选目标)
- 基于
git diff获取变更文件,并结合cargo metadata将变更路径映射到对应 workspace crate; - 从直接变更 crate 出发,在反向依赖图上做 BFS 扩散,得到受影响 crate 集合(
affected_crates); - 按规则文件(路径规则、crate 规则、全量触发规则)求值得到逻辑目标 key 列表(
targets); - 在 CI detect 阶段按
target_key过滤预置候选矩阵,生成最终并行 job,避免无关目标全量执行。
接入方式(落地步骤)
- 引用方式:在组件仓库 workflow 中显式拉取
arceos-hypervisor/axci(固定分支或 commit),复用其axci-affected与规则处理逻辑; - 在仓库测试入口(如 tests.sh)接入
--auto-target与--base-ref参数,支持按基线分支自动选择目标; - 在 workflow(如
.github/workflows/test.yml)增加 detect 阶段:先计算targets,再按target_key过滤预置矩阵并输出 JSON; - 在执行阶段使用
matrix.include: ${{ fromJson(...) }}并行运行目标任务,skip_all时直接跳过无关 job; - 保留回退路径:
axci-affected不可用时回退到 shell 规则匹配,保证 CI 可用性与渐进迁移。
规则自定义(可配置能力)
- 规则文件默认位于
configs/test-target-rules.json;组件仓库可在.github/axci-test-target-rules.json放置自定义规则,无需改动 axci 主仓代码; - 组件侧规则可按仓库测试拓扑覆盖目标映射(如新增/删除 target key、调整
target_order、补充路径或 crate 触发条件); - 可按目录/文件模式定义
selection_rules,将路径变更映射到测试目标; - 可按 crate 维度定义
crate_rules(含direct_only),区分仅直接变更还是包含依赖扩散影响; - 可通过
run_all_patterns、run_all_crates定义“全量触发条件”,并用non_code规则跳过纯文档类变更; - 通过
target_order统一目标输出顺序,保证选择结果稳定、可预期、便于回归对比。
关键工作
- 合并模块化重构并统一测试入口
- 保持 tests.sh 作为统一入口,兼容已有流程并提升后续可维护性。
- 引入规则驱动自动目标选择
- 在 tests.sh 增加
--auto-target、--base-ref能力; - 新增
configs/test-target-rules.json,将路径匹配与依赖规则配置化; - 优先使用
axci-affected引擎做影响范围分析,失败时回退到 shell 规则匹配,保证可用性。
- 增强 CI 可观测性与稳定性
- 在
test.yml增加test_targets=auto相关输入与detect-targets检测链路; - 输出自动选择决策摘要(selection mode、auto reason、target list)到
GITHUB_STEP_SUMMARY; - 补充 git 网络抗抖动参数、checkout 超时与关键依赖检查,降低网络和环境抖动带来的不确定失败。
- 加固 Starry 测试链路
- 在运行前增加
disk.img检查与软链兜底逻辑,减少镜像路径问题导致的无效失败。
阶段性价值
- 效率收益:为“按影响范围执行测试”打通主链路,预期可显著减少无关测试开销;
- 工程收益:测试能力从脚本硬编码向“规则配置 + 引擎分析”演进;
- 质量收益:自动选择过程具备可解释输出,便于排障与规则迭代;
- 扩展收益:模块化后更便于后续新增 target、suite 与规则。
相关代码(速查)
- 依赖感知引擎:axci-affected/src/engine.rs
- 回退脚本:scripts/affected_crates.sh
- 规则配置:configs/test-target-rules.json
- CI 检测与矩阵编排:.github/workflows/test.yml
- 测试入口与自动目标选择:tests.sh
原理细节与端到端数据流可参考:docs/axci-工作原理.md。
EEVDF
代表性成果:StarryOS 中 EEVDF 调度器实现与验证
- 仓库链接:StarryOS feat/eevdf-scheduler
- 当前状态:功能完成并形成文档、单测与演示脚本闭环
背景问题
在操作系统调度中,需要同时满足两类目标:
- 公平性:不同优先级任务应按权重获得合理 CPU 份额;
- 响应性:交互任务应尽快获得服务,避免高负载下长尾延迟。
传统仅按时间片轮转或仅按 vruntime 最小选择,难以同时兼顾“公平份额”与“截止期驱动响应”。因此在 StarryOS 上实现 EEVDF(Earliest Eligible Virtual Deadline First)调度器,验证其在可解释性、公平性和可观测性上的工程价值。
关键工作
- 完成 per-task EEVDF 核心调度逻辑
- 在
crates/axsched/src/eevdf.rs中实现EevdfScheduler与EevdfEntity; - 任务实体维护
vruntime、deadline、nice、slice等关键元数据; - 采用 Linux 兼容 nice->weight 映射(-20..19)并据此计算 vruntime 增量与 deadline。
- 设计双索引结构,兼顾选择效率与资格判断
ready_queue:按(deadline, id)排序,快速获得最早 deadline 任务;vrt_set:按(vruntime, id)排序,用于vruntime <= V的 eligible 范围查询;id_to_deadline:连接两套索引,保障在慢路径下仍可高效定位候选任务。
- 完成 EEVDF 选取与抢占策略
pick_next_task:优先走快路径(最早 deadline 且 eligible),否则走慢路径筛选 eligible 中 deadline 最小任务;- 当无 eligible 任务时启用 fallback(直接取最早 deadline)保证系统可推进;
task_tick中实现 deadline 驱动抢占:若队首任务 eligible 且 deadline 更早,则触发抢占。
- 完成与运行队列集成及可观测性建设
- 在
crates/axtask/src/run_queue.rs接入 tick 调度与抢占路径; - 增加 EEVDF 统计项(picks、preempt、slice_expired、fallback)及周期日志输出;
- 提供 scripts/demo-eevdf-stats.sh、scripts/bench-regression-eevdf.sh、scripts/parse-eevdf-stats-log.sh,形成“采集-解析-回归”自动化链路。
- 支持多 CPU 指定调度算法(per-CPU 异构调度)
- 设计并实现调度器元数据分离,支持不同 CPU 绑定不同调度算法,避免全局单策略耦合;
- 引入
CPU_SCHED编译期配置,支持按 CPU 维度声明调度策略; - 补充跨调度器迁移路径的设计与验证要点,保证任务迁移过程的状态一致性与可预期行为。
- 与 Linux 现状相比,当前方案仍以编译期静态指定为主:尚未覆盖运行时动态策略切换、成熟的跨 CPU 负载均衡协同以及更完整的调度域/拓扑感知能力。
- 补齐文档与验证闭环
- 输出概念与实现文档:docs/starry-scheduling.md;
- 沉淀测试与演示报告:docs/report/eevdf-unit-tests-summary.md、docs/report/eevdf-nice-demo-summary.md;
- 给出从理论到实测的一体化说明,降低后续同学接手成本。
实验结果
以下 QEMU 延时表与切换间隔估算为代表性一次测量;不同主机负载、SAMPLES/LOAD 与内核版本下数值会变化,结论以「base 与 nice19 的相对关系」及当次 serial.log、结果目录为准。
- 单元测试结果
- 等权重公平性测试:3 个 nice=0 任务长期运行后,CPU 占比误差控制在预期范围内;
- 加权公平性测试:nice -5/0/+5 场景下,CPU 占比与权重比一致性良好;
- 抢占与 deadline 修正测试:覆盖“时间片耗尽”和“提前抢占后剩余时间片重算”路径;
- fallback 场景测试:在强制无 eligible 条件下,兜底逻辑与统计计数行为符合预期。
- QEMU 实测表现
- QEMU 下调度统计与现场压测结果一致:负载窗口内调度行为稳定且可解释,未观察到
fallback退化,可用于后续回归比较与参数调优。
- 现场性能与任务切换延时数据(riscv64-qemu-virt,SMP=1)
前台延时对比(4 个后台
yes压力任务):场景 N p50 p95 p99 max base50 0.630s 0.640s 0.640s 0.850s nice1950 0.040s 0.040s 0.040s 0.040s - 结论:降低后台优先级后,前台命令 tail latency(
p95/p99)约改善16x(0.64s -> 0.04s),最坏时延从0.85s降到0.04s。
- 结论:降低后台优先级后,前台命令 tail latency(
任务切换延时(EEVDF 周期统计日志):
- 观测窗口:
interval_ticks=256,ticks_per_sec=100,单窗口时长2.56s - 负载阶段多窗口
delta[picks]稳定在51左右(停压过渡窗口约45) - 估算平均任务切换间隔:
2560 / 51 ≈ 50.2ms(过渡窗口2560 / 45 ≈ 56.9ms) - 对应切换频率约
19.9Hz(过渡窗口约17.6Hz)
- 观测窗口:
调度行为解释:
slice_expired在负载窗口持续增长,说明切换主要由时间片驱动;preempt_by_deadline有触发但非主导路径;fallback_no_eligible=0,未出现“无 eligible 任务”退化情况。- 小结:在持续负载下,EEVDF 调度表现为稳定的时间片主导切换(约
50ms/次),偶发 deadline 抢占,且无 fallback 退化,行为与设计预期一致。
测量方法(可复现):
- 环境:
riscv64-qemu-virt,release构建,SMP=1,LOG=info,启用eevdf-stats-demo。 - 负载与探针:后台启动
4个yes >/dev/null,前台以ls作为短任务探针,采样次数N=50。 - 前台延时统计:使用
/usr/bin/time -f "%e"记录每次ls的 wall time,按升序计算p50/p95/p99/max。 - 任务切换延时统计:读取
eevdf stats日志中的delta[picks];窗口配置为interval_ticks=256、ticks_per_sec=100(窗口时长2.56s);平均任务切换间隔按2560 / delta_picks (ms)估算,切换频率按其倒数换算为Hz。
- 环境:
结果与价值
- 算法落地:将 EEVDF 从概念层落到可运行、可测试、可观测的内核实现;
- 工程可维护性:双索引 + 统计设计使问题定位路径清晰,便于持续迭代;
- 测试体系收益:建立了单测、演示、回归脚本三层验证,减少调度改动引入回归风险;
- 团队协作收益:文档化沉淀完整,便于新成员快速理解调度设计与验证方法。
相关代码(速查)
- EEVDF 核心实现:crates/axsched/src/eevdf.rs
- 调度器抽象与 per-CPU 支持:crates/axsched/src/per_cpu.rs
- 运行队列与调度接入:crates/axtask/src/run_queue.rs
- 多 CPU 策略注入:axruntime-patched/build.rs、axruntime-patched/src/lib.rs
- 编译期配置触发:kernel/build.rs
- 观测与回归脚本:scripts/demo-eevdf-stats.sh、scripts/bench-regression-eevdf.sh、scripts/parse-eevdf-stats-log.sh
经验复盘
- 调度算法实现不仅是“选下一个任务”,更关键是数据结构设计与状态一致性维护;
- 可观测性应与算法实现同步建设,否则难以在真实负载下解释行为差异;
- 对“无 eligible”这类边界路径提前设计 fallback 与测试,能显著降低线上不确定性;
- 通过“文档 + 脚本 + 单测”三位一体沉淀,能让调度改动从个人经验升级为团队资产。
附录:关键复现命令
1 | # 0) 串口落盘(host,在 StarryOS 仓库根目录;目录需事先存在) |
说明:上文「实验结果」中的延时表与切换间隔估算来自代表性一次测量,不同 QEMU/主机负载下数值会波动;报告引用时建议以当次 serial.log、/tmp/bench-results 输出及解析脚本结果为准。
相关链接
本节汇总与本报告对应的实习过程记录仓库、主要上游/个人源码仓库,以及周报、月报与部署类文档入口,便于对照 PR 与日常开发轨迹。
实习日志与过程文档(本仓库)
- 仓库根与索引:os-internship-log(开源社区实习日志;
README.md中含文档索引、周报与月报列表) - 按周记录:
logs/week1.md…logs/week12.md(路径相对仓库根,例如 logs/) - 月报与技术报告:
技术报告2月.md、技术报告3月-贾一飞.md;部署与实施说明见自动测试系统部署文档.md、多组织共享测试环境实施文档.md
源代码仓库(报告涉及的主要工程)
| 工程 | 说明 |
|---|---|
| arceos-hypervisor/axvisor | AxVisor QEMU CI 稳定性改进 |
| arceos-hypervisor/github-runners | 多组织共享 Runner 与开发板锁 |
| arceos-hypervisor/axci | 组件 CI 与测试编排,自动目标选择相 |
| yoinspiration/StarryOS | EEVDF 调度器实现与验证脚本所在个人分支 |
2026春夏开源操作系统训练营总结-杨学聪
现在是我第5次参加操作系统训练营了。我第一次接触Rust和参加操作系统训练营是2024年初。经过漫长时间的学习和消化,我意识到了自己接受新事物的速度还是比较慢的。在学习的旅途中,我遇到了很多志同道合之人——有些人擅长理论推导,有些人喜欢折腾底层汇编,还有些人总能在我卡住的时候扔来一个关键链接。这种氛围让我觉得,慢一点也没关系,只要还在往前走。
以下是我参加训练营的经历、感悟和收获。
Rust and Programming Language
在此之前,除了汇编语言,我只用过C系列的编程语言(C, C++ 和 C#)编写项目和代码。按照原理来说,很多编程语言都可以实现操作系统,至少只要实现了LLVM的前端,就能得到对应的后端二进制代码。但是近年来,使用Rust进行操作系统和嵌入式开发变成了新的趋势。
最初,我无法想象“内存安全性”会是怎样的情况。毕竟C++的智能指针已经宣称解决了大部分问题,可实际项目里引用计数循环、悬垂指针照样防不胜防。但接触了Rust之后,我发现Rust不仅仅是一种简单的语言。Rust在编译时就能检查代码,考虑到多线程的使用、内存泄漏以及整体的优化等问题。它不是在运行时给你抛出一个段错误,而是在你保存文件的那一刻就告诉你:“这里有问题,而且我连怎么改都建议好了。”这种安全感,让人安心。在语法上,Rust的一些设计和Scala、C#非常相像,比如模式匹配、闭包的写法,还有那种“表达式无处不在”的风格,一开始不太习惯,但写了几周之后回头看C++的?:三目运算符,总觉得少了点灵活。
第一点、Rust的标准库非常好。与标准C/C++库相比,Rust的标准库应用更加简洁,对字符串的支持非常省心。C等传统语言对Unicode编码的支持并不友好,也缺少统一的标准,而Rust则很好地解决了这个问题。我印象很深的一次经历:在做训练营的某个文件系统实验时,需要解析一个包含中文路径的用户输入。用C写的话,我得纠结是UTF-8还是GBK,还得手动处理字节长度;而在Rust里,std::path::Path和String直接就把这些事情理得清清楚楚。这种“不用自己造轮子,而且轮子还是圆的”的体验,大大降低了编写操作系统外围工具的心智负担。
第二点、Rust在类型上有创新。例如切片和引用,切片不仅包含起始地址,还有数据长度,这让Rust函数在很多时候可以简化传参,例如,其他语言传递基址还需要包含一个尺寸量,像memset、memcpy这类函数,但是包含数据长度可以少传一个参数,直接当成“Array”使用。这样做有一个特点(不能说是缺点),就是Rust的字符串与C互操作时需要在末尾添加NULL终止符,否则无法正确解析ASCIZ字符串。我在写内核的串口驱动时,就经常需要做这种转换——Rust的&str传到C的printf风格函数之前,得手动as_ptr()再加个\0,稍微有点啰嗦,但习惯了也就变成了肌肉记忆。默认,Rust变量和引用都是不可变的,这让我在写代码时更加注重变量的可写性。对于很大部分人而言,写代码的时候很少注意变量的可写性,导致以后想给一个接口的参数换为const的时候需要付出很多的修改。采用不可变性这一特性促使我在编写代码时声明更多的变量,从而使代码更具可读性。以前写C++的时候,我习惯把一个变量反复重用——一个int i既能当循环下标,又能存中间结果,最后还得存个标志位。现在回过头看,那简直就是“变量的一生被反复蹂躏”。Rust逼着我给每个新状态起一个新名字,代码反而变得像流水账一样清晰。
第三点、unsafe关键字。与C#一样,Rust也有一个“unsafe”关键字,用于标记那些无法由编译器保证安全性的代码。这使我们能够插入特殊代码,解决可能存在的执行问题。在做操作系统训练营的过程中,我发现unsafe其实是一个很好的设计——它把“危险的角落”用高亮笔圈了出来。比如直接操作页表、读写外设寄存器、或者调用一段手写的汇编启动代码,这些必须放进unsafe块里。我在写内核的内存分配器时,整个模块只有三处unsafe:一处是操作裸指针,一处是调用内联汇编刷TLB,还有一处是绕过借用检查器来初始化静态变量。剩下的几百行代码都享受着编译器的保护。相比C++,Rust的unsafe就像是给你一张地图,上面标注了“此处有地雷”,你只要小心这几块区域,其他地方的草可以放心踩。
第四点、Rust 有一种非常独特的所有权系统。与 C 系列语言有所不同。所有权系统能帮助我们避免内存泄漏或多重引用的问题。在其他语言中,我们可能会忘记考虑变量使用的相关机制。在内核的编写中,野指针是非常致命的存在。在长期的C++开发中,我已经屡次领教过野指针带来的问题,往往是忘记使用 memset 或者没有使用构造函数导致的问题。
第五点、Rust 有着非常独特的trait。这种特性可以使代码更加灵活且可复用。我对这个特性的第一感觉是没有C++的虚表和继承的功能更方便。但是Rust提供的 impl 机制可以比较自由地增加方法,并且可以指定方法在哪个特性中实现。比C#中的partial 机制还要更美妙一些。受到Rust的影响,我在写C++代码时也用trait来命名一些公共接口。
第六点、使用panic和Result处理异常。在C++的世界里,异常处理一直是个让人又爱又恨的话题,这个机制需要专门的开关支持,在内核编程基本没人用。noexcept又不够精细,导致你永远不知道一个函数到底会冒出什么幺蛾子。我见过不少C++项目,最后干脆禁用异常(-fno-exceptions),所有函数返回错误码,然后调用方用一堆if去判断。Rust的做法让我眼前一亮:它把“可能出错的操作”分成了两类。一类是“NMI型问题”,用panic!;另一类是“小问题,调用方可以处理”,用Result<T, E>。
Architecture
我尝试在 x86, RISCV, ARM 架构上实现裸机程序。
- x86 算是现代计算机架构的鼻祖,也是目前使用最为广泛的架构。从我们身边的台式机、笔记本,到数据中心的服务器,x86 几乎无处不在。它的历史包袱很重,从16位的8086一路延伸到64位的x86_64,里面塞满了各种兼容模式、分段机制、中断描述符表的复杂规则。这是我从小接触的架构。
- RISCV 是一种开源的指令集架构,目前很多开源项目都在使用RISCV架构。
- ARM 是一种商业的指令集架构,在嵌入式单片机、移动设备手机平板等电子设备上使用广泛。
我发现了RISCV有以下优势:
第一、RISCV 是一种开源的指令集架构,注定了生产使用的成本更低。x86和ARM的授权费用高,而且还有各种专利壁垒。这种低成本不仅仅体现在钱上,更体现在试错成本上。我们可以在模拟器里随便改指令集,完全不用考虑商业兼容性。这对于我们这些写操作系统的人来说,意味着底层的行为是完全透明、可预期的。
第二、RISC-V的32位与64位指令集架构高度相似。这一点,x86与ARM均未实现。RISC-V的32位(RV32)与64位(RV64)在分页机制上仅存在细微差异,而ARM的不同运行模式(如32位与64位)之间的分页技术则差异显著。x86的32位与64位架构在分段模型、寻址方式及指令使用等方面均表现出较大差异,导致跨位宽兼容的实现复杂度显著上升。这种相似性不仅体现在分页技术上,还贯穿于异常处理、控制状态寄存器(CSR)布局以及原子操作指令中。对于操作系统开发者而言,这意味着同一套内核代码可以通过条件编译(如根据 __riscv_xlen 宏)平滑地适配两种位宽,无需重写核心的页表遍历、上下文切换或系统调用入口逻辑。反观x86-64,其兼容32位模式时需要启用兼容子模式(compatibility mode),并且段寄存器、门描述符格式以及中断栈帧布局均与纯64位模式存在结构性差异,这迫使许多操作系统(如Linux)在x86上维护两套独立的低级入口代码。RISC-V通过设计上的统一性,显著降低了多平台内核的维护成本。
第三、RISCV的M态陷入默认是关闭分页的。这一点设计真的很好,可以直接使用恒等映射,这样在内核态和用户态切换时,不需要做任何的映射操作,直接使用恒等映射即可。而x86和ARM则需要在用户态和内核态切换时想办法转到内核页面。但是,RISCV的S态陷入默认是开启分页的。M态关闭分页的特性使得最低特权级的固件(如引导加载程序或安全监视器)能够完全绕过虚拟地址转换,直接以物理地址访问内存。这一设计简化了启动阶段的早期初始化流程:在设置页表之前,M态代码即可完成内存检测、设备树解析或安全服务调用,无需预先建立任何地址映射。x86架构则缺乏类似的干净抽象——即使是在系统管理模式(SMM)下,处理器仍然处于实模式或保护模式的分页语境中,开发者必须小心处理段基址与分页的相互作用,稍有不慎便会引发三重故障。与之相对,RISC-V的S态默认开启分页则是为了保障常规操作系统的运行效率:内核与用户进程共享统一的虚拟地址空间,通过页表隔离权限。但这一设计也带来了额外的约束——在S态下直接访问未映射的物理地址需要临时切换页表或使用恒等映射区域,否则会触发页错误。
Experience and Another Design
今年的训练营,给我的最大挑战的是ArceOS环境的配置。我试过调整Toolchain的版本,也试过修改单个依赖的版本,都失败了。最终,我决定采用最新的工具版本,针对其中的一些版本适配问题,我会将一些依赖的内容固定到仓库中。
与之前几期相比,Rustlings 后又增加一个阶段。主要涉及了多线程下的Rust应用,功能很实用。rCore 的前几个章节有略微的改动。
print_with_color作业:
一开始要实现一个彩色打印功能,与rCore一开始实现的一样。原理都是 Linux 上面的终端支持。我实现的是绿色的,用这个颜色的原因是其他例程pass时也是用绿色输出的。
这个终端颜色的原理也让我将其用作其他程序的Logging输出。
sys_mmap作业:
这个作业让我对内存管理有了更深的理解。将文件内容映射为内存页,这个设计很好。让我掌握到了匿名映射,按需分配等概念,以后可以自己从头实现试一试。
support_hashmap, ramfs_rename作业:
要注意到修改Cargo.toml文件里依赖和版本
我使用 C++ 设计中另一个类组件化的微内核(mecocoa)。设计思路和经历如下
IO系统
IO 系统是我最早着手实现的部分之一,也是经历重构次数最多的模块。最初只是想做一个能显示字符的文本控制台,后来逐步加入了图形界面、TTY 虚拟终端、键盘鼠标输入以及窗口管理。
系统支持多个虚拟终端(VTTY),每个终端拥有自己的输入输出队列。当一个进程调用 INNC 等待键盘输入时,它的 PID 会被加入等待序列。主循环 serv_cons_loop 会轮询所有阻塞进程对应的 TTY 输入队列,一旦有字符到达就唤醒该进程并发送消息。这个设计简单直观,但轮询效率不高,而且没有优先级区分。
键盘中断服务程序将扫描码转换成 keyboard_event_t 结构,然后调用 hand_kboard 放入当前焦点 TTY 的输入队列。鼠标消息同样经过 hand_mouse 处理。这种消息化设计使得输入源与消费端解耦,后续若要支持触摸屏或远程输入,只需增加对应的消息产生者即可。
当前的消息轮询模型效率低下,未来要解决这些问题。
图形处理
图形处理模块是 IO 系统的上层延伸,负责鼠标光标绘制、窗口图层管理、基本绘图原语以及双缓冲刷新。其设计围绕图层管理器与底层图形输出接口展开,实现了从像素绘制到窗口交互的初步功能。针对不同显存布局,实现了两种主要的图形输出类,分别处理 ARGB 与 ABGR 两种字节序。基本绘图接口(画点、画矩形、批量画点)直接操作显存地址,通过帧缓冲基址加坐标偏移计算目标位置。对于 24bpp RGB 格式也有实现。矩形绘制中尝试了批量写入优化,例如在地址对齐时使用 32 位宽赋值代替逐字节写入。
图形子系统的图层管理。 LayerManager 管理多个 SheetTrait 对象,每个窗口或控件都是一个图层。我实现了双缓冲(enable_2buffer),通过后缓冲 sheet_buffer 减少显存直接操作带来的撕裂和闪烁。光标 Cursor 作为独立图层,可以响应鼠标移动事件并更新位置。此外还实现了简单的 Form 和控件(Label、TextBox),虽然功能简陋,但至少证明了窗口模型的可行性。双缓冲开启后,所有绘图操作先写入后缓冲(系统内存中的颜色数组),定期刷新函数检查“是否需要刷新”标志和“脏矩形”区域,将受影响的矩形区域通过真实的图形输出接口复制到显存。刷新频率由系统时钟控制。脏矩形坐标在刷新前会进行裁剪,防止越界。
图形服务函数运行在单独的任务中,从图形消息队列中取出消息,目前只处理鼠标消息并调用上述鼠标处理函数。这种设计将图形输入与主控制台服务解耦。
目前的局限性有:
- 光标形状是固定尺寸的字符数组,无法动态加载不同光标样式(如箭头、手型)。
- 每次鼠标移动或点击都遍历所有图层进行坐标命中测试,图层数量增加时开销线性增长。
- 层管理器的事件回调仅实现了鼠标拖拽窗口(检测到左键按下时设置移动标志),但未处理窗口释放、边界限制、与其他控件的交互(如按钮点击)
任务管理与调度系统
调度系统是内核的核心组件之一,负责管理进程与线程的生命周期、优先级调度、同步与通信。经过多次重构,当前版本实现了一个 O(1) 优先级的混合调度器,据说是Linux 2.x用的是这个方案,区分实时任务与分时任务,并支持多核基础架构(多核部分尚未启用)。优势是基于位图的快速队列选择: 每个优先级对应一个就绪队列(双向链表)。调度器维护一个 32 位位图,每一位表示对应优先级队列是否非空。选择下一个任务时,通过 __builtin_ctz(数尾零指令)直接找到最高优先级的非空队列,然后取出队首线程。
系统区分 ProcessBlock(进程)与 ThreadBlock(线程)。每个进程至少拥有一个主线程,可额外创建更多线程。进程拥有独立的页表、文件描述符表、堆区边界、TTY 焦点及图形窗口引用;线程则持有运行上下文、栈空间、优先级、时间片及阻塞原因。这种分离使得资源管理更加清晰,也为未来引入多线程应用打下了基础。
系统提供了基于消息的进程间通信原语(msg_send / msg_recv),支持阻塞发送与接收。每个线程可记录等待的发送目标或接收来源,并挂起直到消息到达。
关于M态会不会发生抢占,这个与架构有关。x86是可以的,但是 riscv 的 ecall 好像会自动关闭中断,对此我决定手动打开中断。所以M态是会发生抢占的。
内存管理
内存管理模块承担了物理页分配、内核堆管理、页表映射及分段机制初始化等职责。该模块需要适配多种引导环境(BIOS、GRUB、UEFI)和不同架构(x86 32位、x86_64、RISC‑V),是系统底层的基础设施之一。
系统预留一个覆盖 0 至 4G 物理地址空间的位图.位图结构支持标记页的占用与释放、查询连续空闲页以及设置可用范围。然后实现了一个简单内存池,内核启动后从物理页分配器获取一块连续内存(如 16KB),将其加入内存池作为初始堆空间。后续的 new/malloc 调用均通过默认分配器转发至该内存池。这种设计将内核自身的动态内存需求与物理页管理解耦。
尽管当前内存管理模块尚不完善,它已经成功支持了内核启动、多进程创建、图形缓冲区分配等基本功能。能够正确解析 GRUB 的内存映射并分配出可用的页帧。
用户堆功能当前尚未实现。
消息机制
消息机制是进程间通信与硬件事件通知的核心基础设施。该模块分为两个层次:一是全局系统消息队列,用于处理来自中断的异步事件(键盘、鼠标、定时器、xHCI、帧缓冲刷新);二是基于线程阻塞的同步进程间通信(IPC),支持任意进程间的消息发送与接收,并能够将硬件中断转化为特定线程的消息。
系统维护一个全局的环形队列,专门存放由中断处理程序产生的硬件事件(如鼠标、键盘、定时器、xHCI、刷新)。独立的任务不断从此队列中取出消息并分发给对应的驱动或图形子系统。进程间的普通 IPC 则通过发送与接收系统调用实现,使用另一套基于线程控制块的阻塞队列机制。这种分离保证了硬件事件不会被进程间通信阻塞,降低了中断响应延迟。
同步 IPC 基于线程阻塞与唤醒。 发送线程调用发送接口时,若接收线程当前正阻塞在接收接口上且匹配发送者或允许任意来源,则立即复制消息数据并唤醒接收线程;否则发送线程自身被阻塞,挂入接收线程的发送等待队列,同时标记阻塞原因为“等待发送”,并记录目标线程。接收线程调用接收接口时,若其发送队列非空且与指定的发送者匹配,则取出队首消息,复制数据后唤醒发送线程;否则接收线程阻塞,标记“等待接收”,记录期望的发送者。这种设计实现了内核中的同步消息传递,无需额外的共享内存。由于发送方和接收方可能位于不同的进程(拥有不同的页表),消息数据不能直接用指针访问。模块提供了跨页表复制函数,根据两个进程的页表将源虚拟地址转换为物理地址(或直接映射地址),再复制到目标虚拟地址。该函数在 RISC-V 与 x86 上分别适配了分页机制,并支持降级到内核页表。
发送接口在阻塞前会检测发送等待链中是否存在循环等待(例如 A 等待 B,B 等待 C,C 等待 A)。若检测到潜在死锁,函数返回错误而不阻塞,避免了系统挂死。虽然检测算法简单(仅遍历单链),但对于单核场景下有限的通信深度已足够。
文件管理与虚拟文件系统
文件管理模块构建了一个虚拟文件系统(VFS)层,用于统一管理不同底层文件系统,并为进程提供标准的文件操作接口(打开、读写、关闭、删除等)。
系统维护一个全局根目录项,所有文件和子目录均以双向链表形式组织在父目录项之下。路径解析时通过线性查找子目录项,命中则直接返回,未命中时触发底层文件系统的搜索回调,并在返回后动态创建新的目录项和索引节点加入缓存。这种“按需建立”的缓存策略减少了内存占用。
系统实现了一个特殊的设备文件系统,并默认挂载在 /dev 目录下。该文件系统在初始化时自动创建 /dev/tty0 至 /dev/tty3 四个设备节点,其内部处理字段存储 TTY 索引号。读写操作通过 IPC 消息转发给对应的 TTY 服务进程,将文件接口转换为进程间通信。
目前只适配了 FAT12/16/32 几种文件系统。
系统调用与处理程序
采用了一种通用简单的设计方案,限制是每个系统调用的参数数量不能大于3.
支持 INT/GATE/SYSCALL/ECALL 指令导致的系统调用。
End
我的操作系统开发之旅才刚刚开始,未来还有很长的路要走。从最初对Rust内存安全性的懵懂,到如今能在三种架构间对比分页与陷入行为,这五次训练营的经历让我逐渐摸到了系统编程的门槛。然而,每一次深入都揭示出更多未知的领域——异步运行时在内核中的整合、多核间的缓存一致性协议、实时调度算法的确定性验证,这些课题仍在远方等待。RISC-V的开源特性降低了实验门槛,但生态的成熟度尚需时日;x86的庞大兼容层虽令人敬畏,却也暴露出历史设计的沉重代价。前方的道路并非坦途,但正因如此,每一次编译通过、每一个页表正确遍历、每一次异常被精准捕获,都成为继续前行的理由。或许,操作系统的魅力就在于它永远无法被彻底“完成”。
Dosconio,
21, April 2026.