0%

操作系统设计与实现中常用的 Rust 特性

oscamp 第一阶段的 rustlings 总结, 但因为去年写过一次 rustlings 了, 题目比较基础(除了最后的算法和数据结构实现有点麻烦)之前也接触过不少 Rust, 所以这次是总结一下二三阶段中特别需要的 Rust 特性

结构体和枚举

注意元组结构体

1
2
3
4
5
struct TupleStruct(u32, u32, u32);
let tuple_obj = TupleStruct {0, 255, 0};
assert!(tuple_obj.0, 0);

struct UnitStruct;

单元结构体主要是在不关心其关联的数据, 而只需要实现其关联函数或方法时存在
其实还比较常用的, 例如对某学基本数据类型的特化, 比如 rustlings 后面的 MinHeap, 三阶段中也有这样的情况

枚举这里需要比较熟悉 match 等模式匹配的手段:

1
2
3
4
5
6
7
match message {
Message::Move(p) => self.move_position(p),
Message::Echo(s) => self.echo(s),
Message::ChangeColor(x, y, z) => self.change_color((x, y, z)),
Message::Quit => self.quit(),
_ => ()
};

本实验中大量使用枚举来表示一些错误情况(这也是 Rust 和一些程序设计语言的常见处理方式)

二三阶段处理 Trap 时的 Trap::Exception(...) Trap::Interrupt 也都是枚举, 通过 match 模式匹配

模块

模块这里 rustlings 的考察比较基础, 这里补充一些 Cargo 管理工程的机制

  • module 用于代码结构分层, 控制作用域和可见性等

    Rustlings 只介绍了内联模块 即

    1
    2
    3
    4
    5
    mod delicious_snacks {
    pub use self::fruits::PEAR as fruit;
    pub use self::veggies::CUCUMBER as veggie;
    ...
    }

    但实际工程中还有很多创建模块的方法, 例如:

    • 拆分到一个文件中, 然后用 mod name; 声明告诉编译器这里有个模块. 声明后才会进入模块树.

    • 复杂模块应拆分到一个目录中, 并在这个目录下 mod.rs 中暴露接口和声明子模块, 这个目录下的其他文件就是这个目录的子模块, 例如 foo/mod.rs 中写下 pub mod bar;, foo/bar.rs 就成为了 foo::bar 子模块

    • mod foo; 会查找 foo/mod.rs 或 foo.rs

      例如三阶段 ArceOS 实验二, 需要在 axstd 下面创建 collections 子模块(创建collections/mod.rs), 然后再创建 collections::hash_map 子子模块(?)(创建 hash_map.rs 并在 collections/mod.rs 声明pub mod hash_map, pub use hash_map::HashMap)

  • crate 是可被编译的最小单位, 分为 bin 或 lib 两种, 前者可被编译为可执行程序, 后者可被编译为.rlib, 只能提供一些接口(没有 main 函数)

    三阶段需要对 crate 有一定的理解, 因为 ArceOS 的组件化是相当依赖于 Rust 的 crate 的.

  • package 是提供一系列功能的 crates 的集合, 可包含多个 bin crate 和最多一个 lib crate.

  • workspace 管理多个 packages 的编译环境工具链等的目录结构. 一般比较大型的项目会分为多个 packages 开发, 共享同一个 target/目录

    以 ArceOS 下的 Cargo.toml 为例:

    1
    2
    3
    4
    5
    6
    7
    8
    9
    10
    11
    12
    13
    [workspace]
    resolver = "2"
    members = [
    "modules/axalloc",
    ...
    ]
    [workspace.package]
    ...

    [workspace.dependencies]
    axstd = { path = "ulib/axstd" }
    axlibc = { path = "ulib/axlibc" }
    ...

Option<T> 与 Result<T, E>

在我们本次操作系统的实验中会大量使用(其实 Rust 工程都会大量使用)

ArceOS 会封装为 AxResult 等

泛型与 Trait

泛型作为一种静态分发生成代码的方式, 本次实验中没有太需要这一块, 有多态基本都是在 dyn Trait 用 trait 对象动态分发

trait 在本次实验中就非常重要了, 组合形式的代码复用比继承灵活了不少, 例如:

  • rCore 中的”文件” File trait, 通过 write read 抽象地描述了一个”文件”应该具备的行为
  • ArceOS 中的 VfsOps 和 VfsNodeOps, 描述了文件系统应该提供的功能和一个文件节点应该提供的功能, 并且通过 Arc<dyn VfsOps> 实现对不同文件系统和不同文件节点的支持
  • 动态内存分配的接口 unsafe trait GlobalAlloc (这个其实是标准库的, 但是我们自己实现的内存分配器需要 impl GlobalAlloc for OurAllocator)

生命周期

想要对 lifetime 的理解炉火纯青是比较困难的, 幸运的是本次实验你只需要懂得一些基本的生命周期概念, 然后学习智能指针就行了(), 代码中大量使用 Arc<T> RefCell<T> 等.

但还要记住一句话: 任何时候保证引用有效(对这句话的理解应该还有一层: 任何引用本身存在的生命周期必须小于等于其引用内容的生命周期, 不然其内容死了之后这个引用就没有任何意义而且变得危险了)

迭代器

使用 obj.iter() 或 obj.into_iter()/obj.iter_mut() 后可以链式地进行一些操作:

  • 迭代适配器: map filter for_each, 接收一个捕获迭代器元素的闭包, 执行某些操作, 但不会消耗迭代器返回值, 而是继续返回迭代器
  • 消费适配器: .collect() .sum(), 消费其中的迭代器并返回具体类型, 注意你可能需要显示标注我们需要 collect 成什么类型

智能指针

  • Box<T> 拥有其内部数据的所有权, 数据在堆上, 常用于解决递归类型无法计算大小的问题 (Box 本身是 Sized 的)

  • Rc<T>/Arc<T>: 多个智能指针共享同一个数据的所有权

    • let origin = Arc::new(data) 创建一个智能指针
    • let others = Arc::clone(&origin) 共享 origin 智能指针中的数据 data
    • Arc:strong_count(&original) 有多少指针在共享这一数据, 引用计数为 0 是释放数据空间
  • Weak<T>: 弱引用, 用于解决引用循环. 例如对于操作系统中父进程有一个 children: Vec<Arc<TaskControlBlock>>, 而子进程还需要得知自己父进程 parent: Arc<TaskControlBlock>, 这样就会导致引用计数始终不为 0, 最后数据无法被释放造成泄露, 所以需要 parent: Weak<TaskControlBlock>. Weak<T> 不需要引用计数为 0 就可以被清理, 其特性是:

    • 任何涉及弱引用的循环会在其相关的值的强引用计数为 0 时被打断
    • Rc<T> 维护一个 weak_count, 每次Rc::downgrade 创建 Weak 指针时增加弱引用计数
    • weak_count 无需计数为 0 就能使 Rc<T> 实例被清理, 因此使用 Weak 的数据时其数据是可能被清理掉的, 我们需要Weak:upgrade, 返回 Option<Rc<T>.
  • RefCell: 内部可变性设计模式

    我们可以在 RefCell<T> 本身不被绑定为可变时修改其内部的值, 在运行时进行借用检查.

    RefCell 提供的内部可变性在二阶段 rCore 的一些控制信息结构体中常用, 例如 TCB 将不可变数据作为直接的结构体成员, 可变数据放在 inner 里 (这里 UPSafeCell 就是基于 RefCell 封装的).

    我们显然不希望 process, kstack 这样逻辑上应为 immutable 的数据被改变, 所以整个 TCB 结构体应该被绑定在不可变变量上, 但是这样就导致 inner 也是不可变的了, 我们无法修改 inner 中的 trap_cx 上下文等, 所以我们需要依赖 RefCell 的运行时借用检查能力, 允许修改 inner 中的值

    根据 RefCell 的特性

    1
    2
    3
    4
    5
    6
    7
    8
    9
    10
    11
    12
    13
    14
    15
    16
    17
    18
    19
    20
    21
    22
    /// Task control block structure
    pub struct TaskControlBlock {
    /// immutable
    pub process: Weak<ProcessControlBlock>,
    /// Kernel stack corresponding to PID
    pub kstack: KernelStack,
    /// mutable
    inner: UPSafeCell<TaskControlBlockInner>,
    }

    pub struct TaskControlBlockInner {
    pub res: Option<TaskUserRes>,
    /// The physical page number of the frame where the trap context is placed
    pub trap_cx_ppn: PhysPageNum,
    /// Save task context
    pub task_cx: TaskContext,

    /// Maintain the execution status of the current process
    pub task_status: TaskStatus,
    /// It is set when active exit or execution error occurs
    pub exit_code: Option<i32>,
    }

    这个 UPSafeCell 的 exclusive_access 方法不能嵌套调用, 会导致 BorrowMutError.

线程

这个实验不需要掌握太多 Rust 线程的使用方法, 因为我们需要自己实现线程机制

但是要对线程模型和同步互斥有一定的认识, 会在 rCore Tutorial Book 的 ch8 中学习到

宏

在 ArceOS 中用得非常神仙, 尤其是对过程宏的运用:

  • 借助 linke_me 利用过程宏 #[register_trap_handler(SYSCALL)] 等注册异常处理函数
  • 由于 axhal 和 axlog 存在的循环依赖关系, axlog 必须以 extern ABI 而不是[dependencies] 的形式依赖 axhal. 但是这个不通过 Rust 编译器的检查, 所以用过程宏封装成 trait 的形式, 减少出错概率
  • 用宏对某些特定对象生成 trait 的默认行为这些相比以上用法已经算是比较一般的了

过程宏是基于 AST 进行代码生成的, 所以灵活度非常高, 这里也不需要掌握太深入, 但是至少要能读懂过程宏, 这样在三阶段中才不会太盲人摸象

类型转换

主要在地址空间的支持中需要对 PA VA PPN VPN 进行转换等涉及到 From Into 之类的 trait

剩下的时候都在能.into()就.into()不能的话就强行as

↑: 这是不负责任的喵

最后十道题

  • 链表

    • 活用 loop+match+ 模式匹配 能写得比 for 循环迭代更清晰
    • 裸指针解引用需要 unsafe 套一下, unsafe 最好在表达式层次
  • 排序: 比较简单, 和其他语言基本没什么差别. 可以用 array.swap(idx1, idx2) 代替 std::mem:swap 交换元素

  • 二叉搜索树: 主要是 Option<Box<TreeNode<T>>> 套着比较烦, 但其实都是必要的: Option 用来时刻提醒你防止 NULL 的情况, Box 用于解决树形结构的递归类型

  • 图的存储, BFS 和 BFS: vec![vec![];n] 创建一个 Vec<Vec<T>> 用来存边

    • VecQueue 作为 Rust 中的双端队列
    • while let Some(cur) = q.pop_front() {} 相比 while(!q.empty()) { auto cur = q.front(); q.pop(); } 高下立判了()
  • 利用栈进行括号匹配: 优雅, 太优雅了

    1
    2
    3
    4
    5
    6
    7
    8
    9
    10
    11
    12
    13
    14
    15
    16
    17
    fn bracket_match(bracket: &str) -> bool {
    let mut s = Stack::new();
    for c in bracket.chars() {
    match c {
    '(' | '[' | '{' => s.push(c),
    ')' | ']' | '}' => {
    if matches!(s.peek(), Some(&res) if res == map_bracket(c)) {
    s.pop();
    } else {
    return false;
    }
    }
    _ => continue,
    }
    }
    s.is_empty()
    }

    这里 Some(&res) if res == ... 是 matches! 宏提供的守卫, 宏很神奇吧

  • 用两个队列模拟栈: 每次插入时向 q2 插入元素, 然后把 q1 元素全部出队再入 q2 队, 最后交换 q1 q2, 这样 q1 的出队顺序就始终保证是原始数据应当符合的出栈顺序, 用的时候直接弹就行.

  • 二叉堆, 应该是最麻烦的一个, 需要注意有一个 items: vec![T::default()], 这个默认的 0 号节点用于占位, 这样我们就能从 1 开始构建根节点, 因此左子树是 $2 \times i$, 右子树是 $2 \times i + 1$

    • 还是利用 loop while 寻找需要的节点并反复执行操作(如弹出时交换被弹出节点与根节点后执行的下沉操作需要找的对应位置节点)
  • 邻接表存图: 注意数据类型是 HashMap<String, Vec<(String, i32)>>

以上数据结构几乎都不需要在本次实验中手动实现, 但是三阶段你要手写一个 HashMap

Rust 学习笔记

目录

  1. 基础语法
  2. 所有权系统
  3. 结构体与枚举
  4. 错误处理
  5. 并发编程
  6. 高级特性
  7. 实用工具

基础语法

变量与可变性

1
2
3
let x = 5;          // 不可变绑定
let mut y = 10; // 可变绑定
const PI: f64 = 3.14; // 常量

数据类型

  • ‌标量类型‌:

    • 整数: i32, u64
    • 浮点: f64
    • 布尔: bool
    • 字符: char (4字节Unicode)
  • ‌复合类型‌:

    1
    2
    3
    4
    5
    // 元组
    let tup: (i32, f64, char) = (500, 6.4, 'A');

    // 数组
    let arr: [i32; 3] = [1, 2, 3];

控制流

1
2
3
4
5
6
7
8
9
10
11
12
13
// if表达式
let number = if condition { 5 } else { 6 };

// 循环
for i in 1..=5 {
println!("{}", i);
}

// 模式匹配
match value {
1 => println!("one"),
_ => println!("other"),
}

所有权系统

三大规则

  1. 每个值有且只有一个所有者
  2. 值在作用域结束时自动释放
  3. 所有权可通过移动(move)转移

示例

1
2
3
let s1 = String::from("hello");
let s2 = s1; // s1的所有权转移到s2
// println!("{}", s1); // 错误!s1已失效

借用规则

  • 同一时间,要么:
    • 只能有一个可变引用(&mut T)
    • 或多个不可变引用(&T)
  • 引用必须总是有效的
1
2
3
fn calculate_length(s: &String) -> usize {
s.len()
}

结构体与枚举

结构体

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
struct User {
username: String,
email: String,
sign_in_count: u64,
}

impl User {
// 关联函数
fn new(name: String, email: String) -> Self {
User {
username: name,
email,
sign_in_count: 1,
}
}

// 方法
fn greet(&self) {
println!("Hello, {}!", self.username);
}
}

枚举与模式匹配

1
2
3
4
5
6
7
8
9
10
11
enum IpAddr {
V4(u8, u8, u8, u8),
V6(String),
}

let home = IpAddr::V4(127, 0, 0, 1);

match home {
IpAddr::V4(a, b, c, d) => println!("IPv4: {}.{}.{}.{}", a, b, c, d),
IpAddr::V6(s) => println!("IPv6: {}", s),
}

错误处理

Result类型

1
2
3
4
5
6
7
8
use std::fs::File;

let f = File::open("hello.txt");

let f = match f {
Ok(file) => file,
Err(error) => panic!("打开文件失败: {:?}", error),
};

?运算符

1
2
3
4
5
6
7
8
use std::io;
use std::io::Read;

fn read_username_from_file() -> Result<String, io::Error> {
let mut s = String::new();
File::open("hello.txt")?.read_to_string(&mut s)?;
Ok(s)
}

并发编程

线程

1
2
3
4
5
6
7
use std::thread;

let handle = thread::spawn(|| {
println!("来自线程的消息");
});

handle.join().unwrap();

通道

1
2
3
4
5
6
7
8
9
10
use std::sync::mpsc;

let (tx, rx) = mpsc::channel();

thread::spawn(move || {
tx.send(42).unwrap();
});

let received = rx.recv().unwrap();
println!("收到: {}", received);

高级特性

生命周期

1
2
3
fn longest<'a>(x: &'a str, y: &'a str) -> &'a str {
if x.len() > y.len() { x } else { y }
}

Trait

1
2
3
4
5
6
7
8
9
trait Greet {
fn greet(&self);
}

impl Greet for String {
fn greet(&self) {
println!("Hello, {}!", self);
}
}

实用工具

常用Cargo命令

1
2
3
4
5
cargo new project_name  # 创建新项目
cargo build # 编译项目
cargo run # 编译并运行
cargo test # 运行测试
cargo doc --open # 生成文档并打开

推荐工具链

  • rustup: Rust版本管理工具
  • rust-analyzer: IDE插件
  • clippy: 代码检查工具

学习资源

rcore 学习笔记

目录

  1. 批处理系统
  2. 多道程序与分时多任务
  3. 地址空间
  4. 进程与进程管理
  5. 文件系统与I/O重定向
  6. 进程间通信
  7. 并发

批处理系统

一、批处理系统概述

批处理系统(Batch System)是一种用于管理无需或仅需少量用户交互即可运行程序的操作系统模型‌。它能够自动安排程序的执行顺序,在资源允许的情况下高效运行多个程序‌。批处理系统的主要特点包括:

  • 自动调度多个作业顺序执行
  • 提高CPU和I/O设备利用率
  • 减少人工干预
  • 适用于计算密集型任务‌

二、RISC-V特权级架构

批处理系统实现的基础是RISC-V的特权级机制‌:

  1. ‌用户模式(U-mode)‌:应用程序运行的特权级
  2. ‌监督者模式(S-mode)‌:操作系统内核运行的特权级
  3. ‌机器模式(M-mode)‌:最底层硬件操作特权级

特权级机制的根本原因是确保操作系统的安全性,限制应用程序的两种行为:

  • 不能访问任意的地址空间
  • 不能执行某些可能危害系统的指令‌

三、批处理系统实现要点

3.1 应用程序设计
  1. ‌内存布局‌:通过链接脚本调整应用程序的内存布局‌
  2. ‌系统调用‌:应用程序通过ecall指令请求操作系统服务‌
  3. ‌二进制转换‌:将应用程序从ELF格式转化为binary格式‌
3.2 系统实现流程
  1. ‌初始化Trap机制‌:
    • 设置stvec寄存器指向trap处理入口(__alltraps)‌
    • 定义TrapContext结构保存寄存器状态‌
  2. ‌任务调度‌:
    • 依次加载并执行内存中的多个程序‌
    • 通过ecall指令实现特权级切换‌
  3. ‌上下文保存与恢复‌:
    • 保存用户程序寄存器状态到TrapContext
    • 处理完成后恢复上下文继续执行‌

四、关键代码分析

4.1 Trap初始化代码
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
// os/src/main.rs
#[no_mangle]
pub fn rust_main() -> ! {
clear_bss();
println!("[kernel] Hello, world!");
trap::init();
...
}

// os/trap/mod.rs
global_asm!(include_str!("trap.S"));

/// initialize CSR `stvec` as the entry of `__alltraps`
pub fn init() {
extern "C" { fn __alltraps(); }
unsafe {
stvec::write(__alltraps as usize, TrapMode::Direct);
}
}
4.2 Trap上下文结构
1
2
3
4
5
6
7
8
9
// os/trap/context.rs
pub struct TrapContext {
/// general regs[0..31]
pub x: [usize; 32],
/// CSR sstatus
pub sstatus: Sstatus,
/// CSR sepc
pub sepc: usize,
}

五、批处理系统工作流程

  1. 系统启动时初始化Trap机制‌
  2. 加载多个应用程序到内存‌
  3. 依次执行每个应用程序:
    • 应用程序通过ecall触发系统调用‌
    • CPU切换到S模式,跳转到__alltraps‌
    • 保存应用程序上下文到TrapContext‌
    • 执行系统调用处理程序
    • 恢复上下文,返回用户程序继续执行‌
  4. 当前程序执行完成后,加载并执行下一个程序‌

六、与后续章节的关联

批处理系统是多道程序与分时多任务系统的基础‌。后续章节将在批处理系统基础上实现:

  • 提前加载应用程序到内存减少切换开销‌
  • 协作机制支持程序主动放弃处理器‌
  • 抢占机制支持程序被动放弃处理器‌

多道程序与分时多任务

一、基本概念与设计目标

多道程序设计是指允许多个程序同时进入计算机主存储器并启动计算的方法‌。分时系统是多道程序设计的延伸,通过高频率的任务切换实现用户与系统的交互‌。rCore实现这两种机制的核心目标是:

  • 提高系统性能和效率
  • 减少应用程序切换开销
  • 通过协作机制支持程序主动放弃处理器
  • 通过抢占机制保证处理器资源使用的公平性‌

二、多道程序的放置与加载

2.1 内存布局设计

在rCore中,每个应用程序需要按照编号被分别放置到内存中不同位置,这与第二章将所有程序复制到同一内存区域不同‌。实现方法包括:

  • 通过链接脚本指定每个应用程序的起始地址
  • 内核运行时正确获取地址并将应用代码放置到指定位置‌
2.2 地址空间问题

每个应用程序需要知道自己运行时在内存中的位置,这给编写带来麻烦。操作系统也需要知道每个程序的位置,不能任意移动应用程序所在的内存空间‌。这种限制导致:

  • 无法在运行时根据内存空闲情况动态调整程序位置
  • 可能影响后续对内存碎片空间的利用‌

三、任务切换机制

3.1 基本概念
  • ‌任务‌:应用程序的一个计算阶段的执行过程‌
  • ‌任务切换‌:从一个程序的任务切换到另一个程序的任务‌
  • ‌任务上下文‌:任务切换和恢复时相关的寄存器集合‌
3.2 切换流程

任务切换通过内核栈上的task_context压入和弹出实现‌,具体分为五个阶段:

  1. Trap执行流A调用__switch前,A内核栈只有Trap上下文和调用栈信息
  2. A在内核栈分配任务上下文空间保存寄存器快照,更新task_cx_ptr
  3. 读取B的task_cx_ptr获取B内核栈栈顶位置,切换sp寄存器实现执行流切换
  4. CPU从B内核栈取出任务上下文恢复寄存器状态
  5. B从调用__switch位置继续执行‌

四、关键数据结构与实现

4.1 TrapContext结构
1
2
3
4
5
6
#[repr(C)]
pub struct TrapContext {
pub x: [usize; 32], // 通用寄存器
pub sstatus: Sstatus, // 状态寄存器
pub sepc: usize, // 异常程序计数器
}

该结构用于保存和恢复任务状态,在os/src/trap/context.rs中定义‌。

4.2 系统调用处理

在trap_handler中对用户态环境调用(Exception::UserEnvCall)的处理:

1
2
3
4
Trap::Exception(Exception::UserEnvCall) => {
cx.sepc += 4;
cx.x = syscall(cx.x[...]);
}

通过修改sepc和x寄存器实现系统调用返回‌。

五、分时多任务实现机制

5.1 协作式调度
  • 程序通过主动调用yield系统调用放弃CPU
  • 提高系统执行效率但依赖程序配合‌
5.2 抢占式调度
  • 通过时钟中断强制任务切换
  • 保证不同程序对处理器资源的公平使用
  • 提高对I/O事件的响应效率‌

地址空间

一、地址空间基本概念

1.1 虚拟地址与物理地址
  • ‌虚拟地址‌:应用程序使用的逻辑地址,由操作系统和硬件共同维护的抽象层‌
  • ‌物理地址‌:实际内存硬件使用的地址,由CPU地址线直接访问‌
  • ‌转换机制‌:通过MMU(Memory Management Unit)硬件单元实现虚拟地址到物理地址的转换‌
1.2 地址空间定义

地址空间是指程序在运行时用于访问内存的逻辑地址集合,包含:

  • 用户地址空间:每个应用程序独占的虚拟地址范围‌
  • 内核地址空间:操作系统内核使用的虚拟地址范围‌

二、地址空间实现原理

2.1 SV39分页机制

RISC-V采用SV39分页方案,主要特点包括:

  • 39位虚拟地址空间,支持512GB寻址‌
  • 三级页表结构(页全局目录、页中间目录、页表)‌
  • 页大小为4KB,作为基本映射单位‌
2.2 页表管理
  • ‌satp寄存器:控制分页模式,存储根页表物理地址‌
    • MODE字段:设置为8表示启用SV39分页‌
    • PPN字段:存储一级页表物理页号‌
  • ‌页表项结构‌:包含物理页号、访问权限等控制位‌

三、地址空间隔离与保护

3.1 隔离机制
  • ‌应用间隔离‌:每个应用有独立的页表,V标记位控制有效访问范围‌
  • ‌内核保护‌:页表项U位控制用户态访问权限‌
  • ‌空分复用‌:不同应用可使用相同虚拟地址映射到不同物理页‌
3.2 内存安全

通过地址空间机制实现:

  • 防止应用随意访问其他应用或内核数据‌
  • 避免物理内存布局冲突,简化应用开发‌
  • 增强系统整体安全性和稳定性‌

四、关键数据结构与实现

4.1 页表相关结构
1
2
3
4
5
6
7
8
9
10
// 页表项定义
struct PageTableEntry {
bits: usize, // 存储物理页号和标志位
}

impl PageTableEntry {
fn ppn(&self) -> PhysPageNum { /*...*/ }
fn flags(&self) -> PTEFlags { /*...*/ }
fn is_valid(&self) -> bool { /*...*/ }
}
4.2 地址空间管理
  • ‌MemorySet结构:管理应用的地址空间‌
    • 包含页表、内存区域映射等信息
    • 实现地址映射的建立与销毁

五、地址空间工作流程

  1. ‌初始化阶段‌:
    • 创建内核地址空间‌
    • 设置satp寄存器启用分页‌
  2. ‌应用加载‌:
    • 为应用创建独立地址空间‌
    • 建立代码段、数据段等内存映射‌
  3. ‌运行时‌:
    • MMU自动完成地址转换‌
    • 页错误异常处理‌

进程与进程管理

一、进程基本概念

1.1 进程定义

进程是正在运行并使用计算机资源的程序,是操作系统资源分配的基本单位‌。在rCore中,进程由以下部分组成:

  • 程序代码和数据段
  • 虚拟内存空间
  • 进程控制块(PCB)‌
1.2 进程与程序区别
  • ‌程序‌:静态的可执行文件
  • ‌进程‌:动态的执行实体,具有生命周期‌
1.3 进程控制块(PCB)

PCB是进程存在的唯一标志,包含:

  • 进程标识符(PID)
  • 处理机状态(寄存器值等)
  • 进程调度信息
  • 进程控制信息‌

二、rCore进程管理实现

2.1 进程相关系统调用

rCore实现了以下关键进程管理系统调用:

  • fork():创建与当前进程相同的子进程‌
  • wait_pid():父进程等待子进程结束‌
  • exec():用新程序替换当前进程‌
2.2 进程创建流程
  1. 系统启动时加载初始进程(initproc)‌
  2. initproc通过fork创建shell进程‌
  3. shell根据用户输入创建其他进程‌
2.3 进程调度

rCore采用以下调度策略:

  • 协作式调度:进程主动放弃CPU
  • 抢占式调度:通过时钟中断强制切换‌

三、关键数据结构

3.1 进程控制块实现
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
// 进程状态定义
pub enum TaskStatus {
Ready,
Running,
Blocked,
}

// 进程控制块结构
pub struct TaskControlBlock {
pub pid: usize, // 进程ID
pub status: TaskStatus, // 进程状态
pub context: TaskContext,// 进程上下文
pub memory_set: MemorySet, // 地址空间
// 其他字段...
}
3.2 进程上下文
1
2
3
4
5
6
#[repr(C)]
pub struct TaskContext {
pub ra: usize, // 返回地址
pub sp: usize, // 栈指针
pub s: [usize; 12], // 保存的寄存器
}

四、进程生命周期管理

4.1 进程创建
  • 分配新的PID
  • 创建地址空间
  • 初始化进程上下文‌
4.2 进程切换
  1. 保存当前进程上下文
  2. 选择下一个要运行的进程
  3. 恢复新进程上下文‌
4.3 进程终止
  • 释放占用的资源
  • 通知父进程
  • 从进程表中移除‌

五、进程间通信

5.1 共享内存

通过地址空间机制实现进程间数据共享‌

5.2 信号量

提供同步原语,协调进程执行顺序‌

文件系统与I/O重定向

一、文件系统基础概念

1.1 文件系统作用

文件系统是操作系统用于持久存储数据的关键组件,主要解决内存易失性与外存持久性之间的矛盾‌。rCore文件系统实现了:

  • 数据持久化存储
  • 文件命名与组织
  • 访问控制与权限管理‌
1.2 存储设备分类

UNIX系统将I/O设备分为三类:

  1. ‌块设备‌:如磁盘,以固定大小块(512B-32KB)为单位传输‌
  2. ‌字符设备‌:如键盘/串口,以字符流为单位传输‌
  3. ‌网络设备‌:面向报文传输,BSD引入socket接口处理‌

二、文件系统核心结构

2.1 磁盘布局

rCore文件系统采用类UNIX布局:

  • ‌超级块‌:记录文件系统元信息
  • ‌inode区‌:文件索引节点存储
  • ‌数据块区‌:实际文件内容存储‌
2.2 关键数据结构
1
2
3
4
5
6
7
8
9
// 文件系统超级块
struct SuperBlock {
magic: u32, // 文件系统魔数
blocks: u32, // 总块数
inode_bitmap: u32, // inode位图起始块
data_bitmap: u32, // 数据块位图起始块
inode_area: u32, // inode区域起始块
data_area: u32, // 数据区域起始块
}

三、文件操作接口

3.1 系统调用接口

rCore实现以下核心文件操作:

  • open():打开/创建文件‌
  • read()/write():文件读写‌
  • lseek():调整文件指针位置‌
  • close():关闭文件描述符‌
3.2 文件描述符

每个进程维护文件描述符表:

  • 0:标准输入(stdin)
  • 1:标准输出(stdout)
  • 2:标准错误(stderr)
  • ≥3:用户打开的文件‌

四、I/O重定向机制

4.1 重定向类型
  • ‌输入重定向‌:< 将文件内容作为程序输入‌
  • ‌输出重定向‌:> 覆盖写入文件,>> 追加写入‌
  • ‌错误重定向‌:2> 重定向stderr‌
4.2 实现原理

通过修改进程文件描述符表实现:

  1. 打开目标文件获取新fd
  2. 关闭原标准流fd(0/1/2)
  3. 复制新fd到标准流位置‌

五、管道通信机制

5.1 管道特点
  • 半双工通信,包含读端和写端‌
  • 基于队列的有限缓冲区‌
  • 读空/写满时阻塞等待‌
5.2 使用示例
1
2
3
4
5
6
7
8
9
// 创建管道
let mut pipe_fd = [0usize; 2];
pipe(&mut pipe_fd);

// 子进程读管道
if fork() == 0 {
close(pipe_fd); // 关闭写端
read(pipe_fd, &mut buffer);
}

六、设备驱动实现

6.1 virtio驱动

rCore通过virtio协议访问块设备:

  • 设备树信息由OpenSBI提供‌
  • 使用DMA提高传输效率‌
  • 实现磁盘块缓存优化性能‌
6.2 三种I/O方式
  1. ‌PIO‌:CPU直接控制I/O‌
  2. ‌中断驱动‌:设备就绪后通知CPU‌
  3. ‌DMA‌:设备直接访问内存‌

并发

一、并发基础概念

1.1 并发与并行区别
  • ‌并发‌:多个任务交替执行,宏观上”同时”运行‌
  • ‌并行‌:多个任务真正同时执行,需要多核硬件支持‌
1.2 并发实现方式

rCore主要采用以下并发模型:

  • 多道程序:通过任务切换实现并发‌
  • 分时多任务:基于时间片轮转调度‌
  • 多线程:轻量级执行单元共享地址空间‌

二、任务调度机制

2.1 任务控制块(TCB)
1
2
3
4
5
struct TaskControlBlock {
task_cx: TaskContext, // 任务上下文
task_status: TaskStatus, // 任务状态
// 其他调度相关信息...
}
2.2 调度策略

rCore实现了两种基本调度方式:

  1. ‌协作式调度‌:任务主动yield让出CPU‌
  2. ‌抢占式调度‌:通过时钟中断强制任务切换‌

三、同步原语实现

3.1 自旋锁
1
2
3
4
pub struct SpinLock<T> {
locked: AtomicBool,
data: UnsafeCell<T>,
}
  • 基于原子操作实现‌
  • 获取锁时忙等待‌
3.2 信号量
1
2
3
4
pub struct Semaphore {
count: isize,
wait_queue: VecDeque<TaskControlBlock>,
}
  • 维护计数器+等待队列‌
  • 提供P/V操作接口‌

四、中断与异常处理

4.1 中断处理流程
  1. 保存当前任务上下文‌
  2. 执行中断服务例程(ISR)‌
  3. 恢复或切换任务上下文‌
4.2 特权级切换
  • 用户态(U-Mode)通过ecall进入内核态(S-Mode)‌
  • 内核通过sret返回用户态‌

五、并发编程实践

5.1 线程创建
1
2
3
4
5
fn thread_create(entry: fn()) -> Tid {
// 分配线程栈
// 初始化线程上下文
// 加入调度队列
}
5.2 互斥访问示例
1
2
3
4
5
let lock = SpinLock::new(shared_data);
{
let mut guard = lock.lock();
*guard += 1; // 临界区操作
} // 自动释放锁

六、性能优化技术

6.1 无锁数据结构
  • 基于原子操作实现‌
  • 适用于高并发场景‌
6.2 读写锁
1
2
3
4
pub struct RwLock<T> {
state: AtomicIsize,
data: UnsafeCell<T>,
}
  • 区分读写访问‌
  • 提高读多写少场景性能‌

总结

  • Rust:主要通过训练营的课程以及Rust by Example系列进行学习。有一些编程基础,相对较容易通过。
  • RISC-V基础:主要通过B站视频进行学习, 了解了一些基本的概念。

二阶段 rCore 实验总结 - 折鸦

实验环境配置

用 Rust 开发操作系统内核源代码, 通过 rustc 交叉编译到 riscv64gc-unknown-none-elf (一般情况下是 x86_64-unknown-linux-gnu), 通过 rust-objcopy 提取出 bin, 然后放到 qemu-system-riscv64 模拟器进行模拟, 大概是这么个工具链.

QEMU 最好装 7.0.0 版本的, 从源码编译安装的话需要注意一下依赖, 部分发行版的依赖可以在 Running 64- and 32-bit RISC-V Linux on QEMU — RISC-V - Getting Started Guide 找到

Arch Linux 仓库里是 QEMU 9, 需要修改一下 RustSBI 的版本. 注意如果你想直接 downgrade 到 7.0.0 的话可能会需要连带降级一些非常核心的软件包, 非常不建议尝试. 有需要也可以自行寻找依赖包然后从源代码编译, 但是有一些接口变动可能会导致编译失败, 所以最佳方案还是替换 RustSBI 版本, 这里不再赘述.

构建一个能跑但仅仅能跑的操作系统

根据 OSTEP 的说法, 操作系统的主要三个任务部分在于: 虚拟化, 并发, 可持久化

  • 虚拟化主要表现在:
    • 对内存的抽象: 每个进程有自己的虚拟地址空间, 造成每个进程独占一个主存的假象(学过 CSAPP 可以回忆一下第九章, 博客还在补)
    • 对 CPU 的虚拟化: 主要表现在操作系统内核对各个任务的调度, 使得每个任务产生独占 CPU 的假象(这就是一种并发)
    • 对外设设备的虚拟化等等
  • 并发主要表现在:
    • 进程概念的抽象和实现, 进程间通信
    • 多线程的实现
  • 可持久化主要涉及文件系统

而形式上, 操作系统是一个二进制文件或二进制文件镜像, 被 bootloader 加载进内存的特定位置, 驻留在内存中的特定代码, 这些代码负责一些加载应用程序(简单来说就是把可执行文件加载到内存), 管理资源(设备/文件)并提供访问的任务, 这些任务以系统调用(syscall)的形式暴露给应用程序, 只是系统调用函数比较敏感特殊, 下面会仔细介绍.

那么我们的任务就比较明确了:

  • 先设计一个基本的能把应用程序加载到内存的功能 (当然因为现在内核没有任何调度能力也没有让应用程序启动其他应用程序的必要(这依赖进程的实现), 所以我们暂时不需要设计 execve 系统调用)
  • 实现标准输出能力 (实际上标准输出就是调用系统调用 write, 目标为 1 (标准输入))
  • 实现退出程序的能力 (exit 系统调用)
Read more »

Rust速查表:Rust Language Cheat Sheet

Rust是什么

  • Rust可看作一个在语法层面(编译时)具有严格检查和限制的C语言上位。

  • 扩展了面向对象的便捷方法绑定。

  • 编译和运行方式类似于C/C++,可以rustc xxx.rs编译,./xxx运行。

  • 有约定的项目目录格式,可使用Cargo配置toml进行包管理、编译、运行、测试等等。

  • 包资源网站为CratesIO,见src↑。

  • 不支持运算符重载,支持多态。其中语句为:表达式+;,语句的值是()。

    运算符重载是指为自定义的类或结构体重新定义或赋予运算符(如+、-、*、/等)新的功能。它允许程序员对已有运算符赋予多重含义,使同一运算符作用于不同类型的数据时执行不同的操作。

    特点:

    1. 扩展运算符功能:让运算符不仅能作用于基本数据类型,也能作用于自定义类型
    2. 语法简洁:使自定义类型的操作像基本类型一样自然
    3. 保持直观性:重载后的运算符功能应与原意相符,避免滥用

Rust安装

可使用编译器:VSCode + rust-analyzer,VIM,RustRover

image-20250403110554181

1
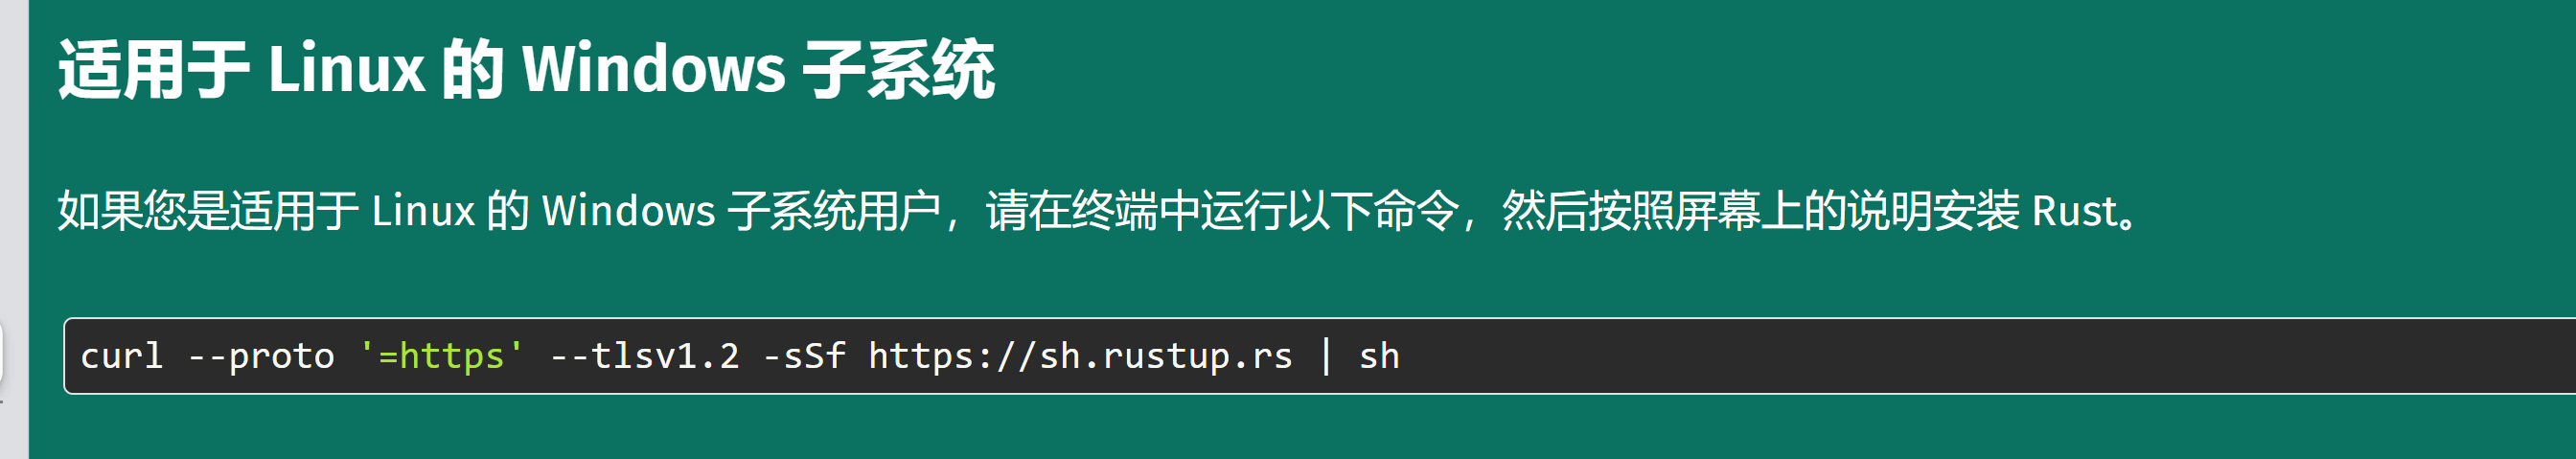
curl --proto '=https' --tlsv1.2 -sSf https://sh.rustup.rs | sh

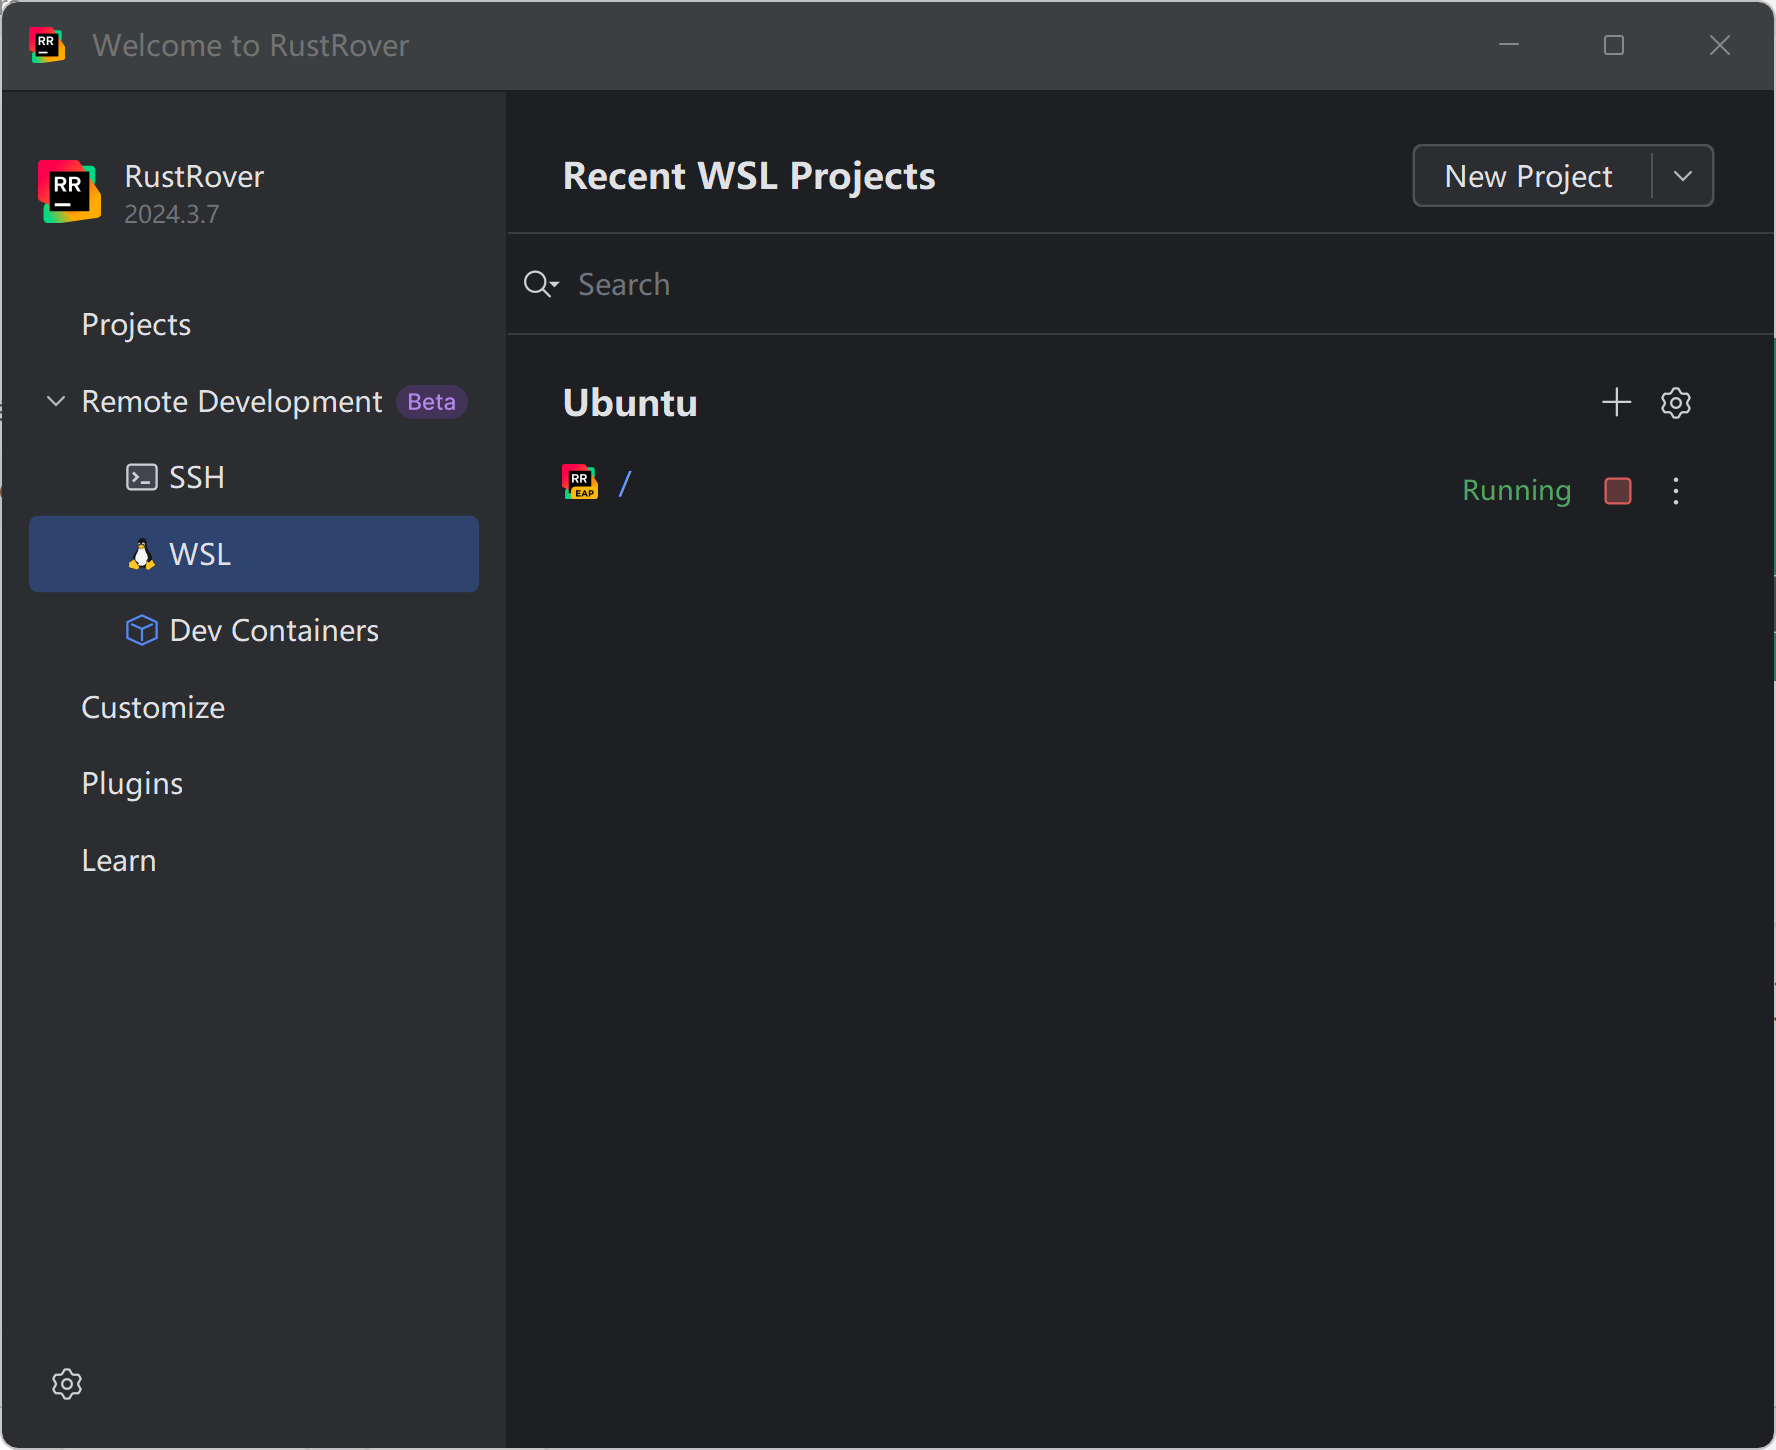
我最终选择使用rustRover来编译——jetBrain全家桶之一,与Pycham同源使用会比较顺手,且可以直接连接WSL:

image-20250403110943092

Rust基础

rust的编译与运行是分开的,是一种预编译静态类型语言。rust的源文件为xx.rs,最基础的编译为使用rustc xx.rs对代码进行编译。

基础语法

Cargo

Cargo是Rust的构建系统和包管理器:

  • 构建代码
  • 下载依赖库(代码所需的库叫做依赖)

1.使用Cargo构建项目

1
2
$ cargo new the_project
$ cd the_project

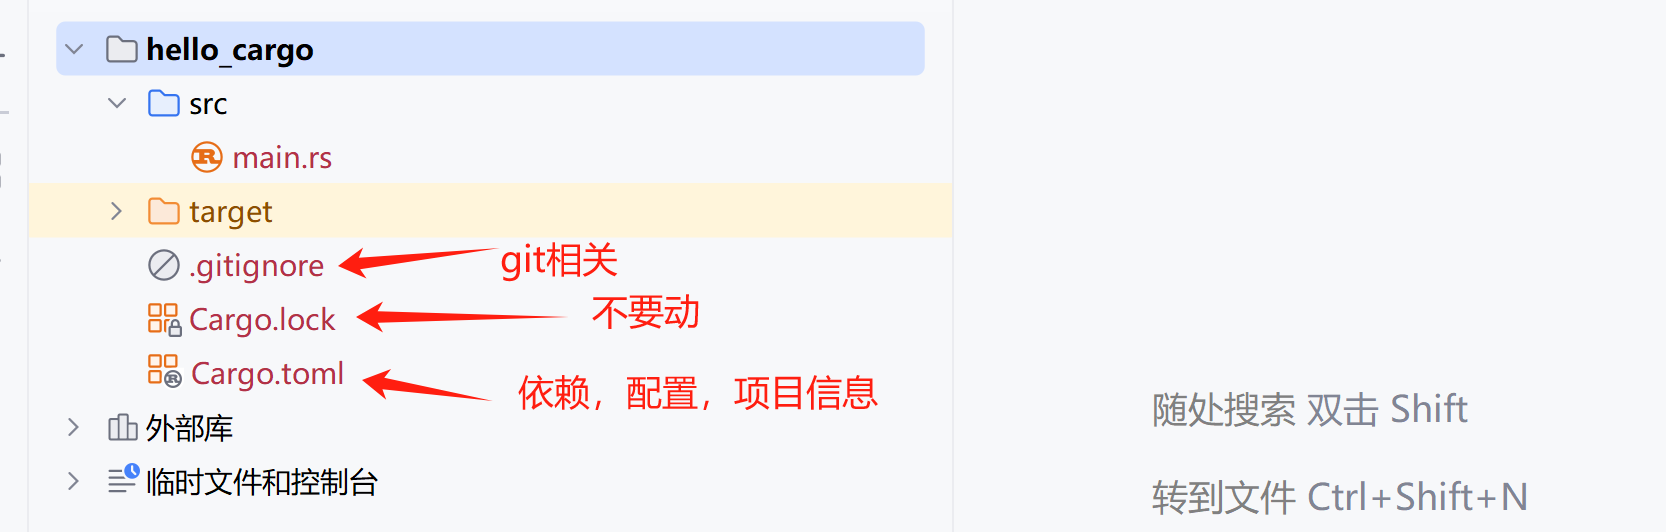
在Linux终端输入上面的代码创建rust项目后,会生成如下的文件与目录:

image-20250410180737109

变量

首先必须说明,Rust 是强类型语言,但具有自动判断变量类型的能力。这很容易让人与弱类型语言产生混淆。

默认情况下,Rust 中的变量是不可变的,除非使用 mut 关键字声明为可变变量。

1
2
let a = 123;       // 不可变变量
let mut b = 10; // 可变变量

如果要声明变量,需要使用 let 关键字。例如:

1
let a = 123;

变量和常量还是有区别的。在 Rust 中,以下程序是合法的:

1
2
let a = 123;   // 可以编译,但可能有警告,因为该变量没有被使用
let a = 456;

但是如果 a 是常量就不合法:

1
2
const a: i32 = 123;
let a = 456;

控制流

if 表达式

实例:

1
2
3
4
5
6
let number = 7;
if number < 5 {
println!("小于 5");
} else {
println!("大于等于 5");
}

loop 循环: loop 是 Rust 中的无限循环,可以使用 break 退出循环。

实例

1
2
3
4
5
6
7
let mut counter = 0;
loop {
counter += 1;
if counter == 10 {
break;
}
}

while 循环

1
2
3
4
5
let mut number = 3;
while number != 0 {
println!("{}!", number);
number -= 1;
}

for 循环

1
2
3
for number in 1..4 {
println!("{}!", number);
}

结构体 (Structs)

结构体用于创建自定义类型,字段可以包含多种数据类型。

实例

1
2
3
4
5
6
7
8
9
10
11
12
13
struct User {
username: String,
email: String,
sign_in_count: u64,
active: bool,
}

let user1 = User {
username: String::from("someusername"),
email: String::from("someone@example.com"),
sign_in_count: 1,
active: true,
};

枚举 (Enums)

枚举允许定义可能的几种数据类型中的一种。

1
2
3
4
5
6
7
enum IpAddrKind {
V4,
V6,
}

let four = IpAddrKind::V4;
let six = IpAddrKind::V6;

模式匹配 (match)

match 是 Rust 中强大的控制流工具,类似于 switch 语句。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
enum Coin {
Penny,
Nickel,
Dime,
Quarter,
}

fn value_in_cents(coin: Coin) -> u8 {
match coin {
Coin::Penny => 1,
Coin::Nickel => 5,
Coin::Dime => 10,
Coin::Quarter => 25,
}
}

错误处理

Rust 有两种主要的错误处理方式:Result<T, E> 和 Option。

Result:

1
2
3
4
5
6
7
8
9
10
11
12
enum Result<T, E> {
Ok(T),
Err(E),
}

fn divide(a: i32, b: i32) -> Result<i32, String> {
if b == 0 {
Err(String::from("Division by zero"))
} else {
Ok(a / b)
}
}

Option:

1
2
3
4
5
6
7
fn get_element(index: usize, vec: &Vec<i32>) -> Option<i32> {
if index < vec.len() {
Some(vec[index])
} else {
None
}
}

所有权与借用的生命周期

Rust 使用生命周期来确保引用的有效性。生命周期标注用 ‘a 等来表示,但常见的情况下,编译器会自动推导。

1
2
3
4
5
6
7
fn longest<'a>(x: &'a str, y: &'a str) -> &'a str {
if x.len() > y.len() {
x
} else {
y
}
}

重影(Shadowing)

重影的概念与其他面向对象语言里的”重写”(Override)或”重载”(Overload)是不一样的。重影就是刚才讲述的所谓”重新绑定”,之所以加引号就是为了在没有介绍这个概念的时候代替一下概念。

重影就是指变量的名称可以被重新使用的机制:

1
2
3
4
5
6
fn main() {
let x = 5;
let x = x + 1;
let x = x * 2;
println!("The value of x is: {}", x);
}

数据类型

整数型(Integer)

整数型简称整型,按照比特位长度和有无符号分为以下种类:

位长度 有符号 无符号
8-bit i8 u8
16-bit i16 u16
32-bit i32 u32
64-bit i64 u64
128-bit i128 u128
arch isize usize

isize 和 usize 两种整数类型是用来衡量数据大小的,它们的位长度取决于所运行的目标平台,如果是 32 位架构的处理器将使用 32 位位长度整型。

浮点数型(Floating-Point)

Rust 与其它语言一样支持 32 位浮点数(f32)和 64 位浮点数(f64)。默认情况下,64.0 将表示 64 位浮点数,因为现代计算机处理器对两种浮点数计算的速度几乎相同,但 64 位浮点数精度更高。

1
2
3
4
fn main() {
let x = 2.0; *// f64*
let y: f32 = 3.0; *// f32*
}

布尔型

布尔型用 bool 表示,值只能为 true 或 false。

字符型

字符型用 char 表示。

Rust的 char 类型大小为 4 个字节,代表 Unicode标量值,这意味着它可以支持中文,日文和韩文字符等非英文字符甚至表情符号和零宽度空格在 Rust 中都是有效的 char 值。

注释

1
2
3
4
5
6
7
8
9
// 这是第一种注释方式

/* 这是第二种注释方式 */

/*
* 多行注释
* 多行注释
* 多行注释
*/

函数

1
fn <函数名> ( <参数> ) <函数体>

函数参数

Rust 中定义函数如果需要具备参数必须声明参数名称和类型:

1
2
3
4
5
6
7
8
fn main() {
another_function(5, 6);
}

fn another_function(x: i32, y: i32) {
println!("x 的值为 : {}", x);
println!("y 的值为 : {}", y);
}

函数返回值

在函数体中,随时都可以以 return 关键字结束函数运行并返回一个类型合适的值。这也是最接近大多数开发者经验的做法:

1
2
3
fn add(a: i32, b: i32) -> i32 {
return a + b;
}

但是 Rust 不支持自动返回值类型判断!如果没有明确声明函数返回值的类型,函数将被认为是”纯过程”,不允许产生返回值,return 后面不能有返回值表达式。这样做的目的是为了让公开的函数能够形成可见的公报。

Rust特色

所有权

Rust 中的所有权是独特的内存管理机制,核心概念包括所有权 (ownership)、借用 (borrowing) 和引用 (reference)。

所有权规则:

  • Rust 中的每个值都有一个所有者。
  • 每个值在任意时刻只能有一个所有者。
  • 当所有者超出作用域时,值会被删除。
1
2
3
let s1 = String::from("hello");
let s2 = s1; // s1 的所有权被转移给了 s2
// println!("{}", s1); // 此处编译会报错,因为 s1 已不再拥有该值

借用和引用: 借用允许引用数据而不获取所有权,通过 & 符号实现。

1
2
3
4
5
6
7
8
9
fn main() {
let s = String::from("hello");
let len = calculate_length(&s); // 借用
println!("The length of '{}' is {}.", s, len);
}

fn calculate_length(s: &String) -> usize {
s.len()
}

组织管理

Rust 中有三个重要的组织概念:箱、包、模块。

箱(Crate)

“箱”是二进制程序文件或者库文件,存在于”包”中。

“箱”是树状结构的,它的树根是编译器开始运行时编译的源文件所编译的程序。

注意:”二进制程序文件”不一定是”二进制可执行文件”,只能确定是是包含目标机器语言的文件,文件格式随编译环境的不同而不同。

包(Package)

当我们使用 Cargo 执行 new 命令创建 Rust 工程时,工程目录下会建立一个 Cargo.toml 文件。工程的实质就是一个包,包必须由一个 Cargo.toml 文件来管理,该文件描述了包的基本信息以及依赖项。

一个包最多包含一个库”箱”,可以包含任意数量的二进制”箱”,但是至少包含一个”箱”(不管是库还是二进制”箱”)。

当使用 cargo new 命令创建完包之后,src 目录下会生成一个 main.rs 源文件,Cargo 默认这个文件为二进制箱的根,编译之后的二进制箱将与包名相同。

模块(Module)

对于一个软件工程来说,我们往往按照所使用的编程语言的组织规范来进行组织,组织模块的主要结构往往是树。Java 组织功能模块的主要单位是类,而 JavaScript 组织模块的主要方式是 function。

这些先进的语言的组织单位可以层层包含,就像文件系统的目录结构一样。Rust 中的组织单位是模块(Module)。

宏

Rust 宏(Macros)是一种在编译时生成代码的强大工具,它允许你在编写代码时创建自定义语法扩展。

宏(Macro)是一种在代码中进行元编程(Metaprogramming)的技术,它允许在编译时生成代码,宏可以帮助简化代码,提高代码的可读性和可维护性,同时允许开发者在编译时执行一些代码生成的操作。

宏在 Rust 中有两种类型:声明式宏(Declarative Macros)和过程宏(Procedural Macros)。

本文主要介绍声明式宏。

宏的定义

在 Rust 中,使用 macro_rules! 关键字来定义声明式宏。

1
2
3
4
5
6
7
macro_rules! my_macro {
// 模式匹配和展开
($arg:expr) => {
// 生成的代码
// 使用 $arg 来代替匹配到的表达式
};
}

声明式宏使用 macro_rules! 关键字进行定义,它们被称为 “macro_rules” 宏。这种宏的定义是基于模式匹配的,可以匹配代码的结构并根据匹配的模式生成相应的代码。这样的宏在不引入新的语法结构的情况下,可以用来简化一些通用的代码模式。

注意:

  • 模式匹配:宏通过模式匹配来匹配传递给宏的代码片段,模式是宏规则的左侧部分,用于捕获不同的代码结构。
  • 规则:宏规则是一组由 $ 引导的模式和相应的展开代码,规则由分号分隔。
  • 宏的展开:当宏被调用时,匹配的模式将被替换为相应的展开代码,展开代码是宏规则的右侧部分。
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
*// 宏的定义*
macro_rules! vec {
*// 基本情况,空的情况*
() => {
Vec::new()
};

*// 递归情况,带有元素的情况*
($($element:expr),+ $(,)?) => {
{
let mut temp_vec = Vec::new();
$(
temp_vec.push($element);
)+
temp_vec
}
};
}

fn main() {
*// 调用宏*
let my_vec = vec![1, 2, 3];
println!("{:?}", my_vec); *// 输出: [1, 2, 3]*

let empty_vec = vec![];
println!("{:?}", empty_vec); *// 输出: []*
}

在这个例子中,vec! 宏使用了模式匹配,以及 $($element:expr),+ $(,)?) 这样的语法来捕获传递给宏的元素,并用它们创建一个 Vec。

注意,$(,)?) 用于处理末尾的逗号,使得在不同的使用情境下都能正常工作。

过程宏(Procedural Macros)

过程宏是一种更为灵活和强大的宏,允许在编译时通过自定义代码生成过程来操作抽象语法树(AST)。过程宏在功能上更接近于函数,但是它们在编写和使用上更加复杂。

过程宏的类型:

  • 派生宏(Derive Macros):用于自动实现trait(比如Copy、Debug)的宏。
  • 属性宏(Attribute Macros):用于在声明上附加额外的元数据,如#[derive(Debug)]。

过程宏的实现通常需要使用 proc_macro 库提供的功能,例如 TokenStream 和 TokenTree,以便更直接地操纵源代码。

智能指针

智能指针(Smart pointers)是一种在 Rust 中常见的数据结构,它们提供了额外的功能和安全性保证,以帮助管理内存和数据。

在 Rust 中,智能指针是一种封装了对动态分配内存的所有权和生命周期管理的数据类型。

智能指针通常封装了一个原始指针,并提供了一些额外的功能,比如引用计数、所有权转移、生命周期管理等。

在 Rust 中,标准库提供了几种常见的智能指针类型,例如 Box、Rc、Arc 和 RefCell。

智能指针的使用场景:

  • 当需要在堆上分配内存时,使用 Box<T>。
  • 当需要多处共享所有权时,使用 Rc<T> 或 Arc<T>。
  • 当需要内部可变性时,使用 RefCell<T>。
  • 当需要线程安全的共享所有权时,使用 Arc<T>。
  • 当需要互斥访问数据时,使用 Mutex<T>。
  • 当需要读取-写入访问数据时,使用 RwLock<T>。
  • 当需要解决循环引用问题时,使用 Weak<T>。

错误处理

Rust 有一套独特的处理异常情况的机制,它并不像其它语言中的 try 机制那样简单。

首先,程序中一般会出现两种错误:可恢复错误和不可恢复错误。

可恢复错误的典型案例是文件访问错误,如果访问一个文件失败,有可能是因为它正在被占用,是正常的,我们可以通过等待来解决。

但还有一种错误是由编程中无法解决的逻辑错误导致的,例如访问数组末尾以外的位置。

大多数编程语言不区分这两种错误,并用 Exception (异常)类来表示错误。在 Rust 中没有 Exception。

对于可恢复错误用 Result<T, E> 类来处理,对于不可恢复错误使用 panic! 宏来处理。

Read more »

一、前言

通过阅读实验指导书,我跟着操作系统的发展历程,学习了批处理系统、多道程序与分时多任务、虚拟地址空间、进程管理、文件系统、进程通信和并发等核心概念,并对rCore的实现有了更深入的认识。以下是我对这两周学习过程的总结。

二、学习内容

  1. 搭建执行环境:

    学习了平台与目标三元组,理解了应用程序执行环境。

  2. 批处理系统:

    学习了批处理系统的基本原理,包括作业调度、作业执行过程。

  3. 多道程序与分时多任务:

    掌握了多道程序设计的基本概念,以及如何实现分时多任务调度。

  4. 虚拟地址空间:

    理解了虚拟内存的概念,包括页表、地址映射。

  5. 进程管理:

    学习了进程的管理、调度,更加深入的理解了fork+exec。

  6. 文件系统:

    掌握了文件系统的基本结构,包括目录、文件。

  7. 进程通信:

    学习了父子进程之间的通信机制——管道。

  8. 并发:

    学习了线程管理机制的设计与实现,理解了同步互斥的实现,包括锁、信号量、条件变量。

三、学习心得

第二次学习rCore,加之前段时间学习xv6的经历,对rCore有了更深入的认识,包括trap的过程、地址空间的切换等,和群里同学的讨论也加深了我对代码的理解。

通过学习rCore,我对操作系统的原理有了更深入的理解,虽然考研的时候较为系统的学习了操作系统的知识,但是基本上还是停留在理论知识方面。这次rCore学习之旅,我获取PCB对进程进行操作、实现课本上学习过的系统调用、深入汇编代码理解什么是 ‘陷入’ ,让我对操作系统的设计理念、计算机的体系结构有了具象化的认识。

在学习过程中,我也遇到了许多挑战,解决了旧问题又出现了新问题,对操作系统有了更深入的认识反而产生了更多的问题,但是我相信计算机没有魔法,多查资料多看源码一定能把疑惑解开。

两周的rCore学习之旅让我受益匪浅。通过学习rCore,我对操作系统的设计和实现有了更深刻的认识,同时也提升了我的编程技能。我相信,这些知识和经验将对我未来的学习和职业发展产生积极影响。

今天重写了一遍rustlings,虽然在其他训练营已经写过了,但是这次依然有收获。比如我了解到了
match时的ref有什么作用,以及他和&的区别

一、前言

通读了一遍《Rust程序设计语言》书籍并完成了训练营的Rustlings练习。经过两周的学习,我对Rust有了初步的认识和掌握。以下是我对这两周学习过程的总结。

二、学习内容

  1. Rust基础知识
  • Rust编程语言的基本语法,包括变量、数据类型、运算符、控制流等。
  • Rust的所有权系统,包括所有权、借用、生命周期等概念。
  1. Rustlings练习
  • 通过完成一系列练习,巩固对Rust基础知识的理解和应用。
  • 练习涵盖了Rust的所有权、借用、生命周期、错误处理、宏、模式匹配等方面的内容。

三、学习心得

这一阶段印象最深的还是最后的算法部份,尤其是前两道关于链表的题目,其实之前一直是使用c++做算法题,对链表也较为熟悉了,但是由于对rust的特性不熟悉以及对链表没有深刻理解,让我有一种有力使不出的感觉,后面通过阅读题目的框架,以及对书本知识的巩固,终于是对rust中的链表有了初步的认识,写完链表的题目后,后续的题目也很快完成了。rust语言的特性让我对编程和计算机有了更深的理解,尽管现在还是写得磕磕绊绊,但是相信通过不断学习和时间,将来我也能够编写出优秀的rust代码。

第一阶段实验总结

在本次实验中,我深入探讨了Rust编程语言中的多个高级概念,并通过实际操作加深了对这些特性的理解。实验的重点涉及了Rust的内存管理、类型系统、并发编程等方面,帮助我更好地掌握了Rust的独特设计思想。

首先,我学习了Option类型,通过实践我了解了如何使用Some和None来表示可能不存在的值。这个特性不仅帮助我更好地处理空值,还为后续的错误处理打下了基础。接下来,我研究了Rust中的结构体和枚举,这两者是Rust数据建模的核心工具。通过定义常规结构体、元组结构体和单元结构体,我体会到了Rust在数据表示上的灵活性。尤其是在枚举的使用中,我学会了如何通过模式匹配来处理不同类型的值,这让代码更加简洁且易于维护。

在处理字符串时,我深入了解了Rust中String与str类型的差异,以及它们在内存管理中的不同表现。我通过字符串切片、拼接等操作,进一步掌握了Rust如何高效地处理内存。对于Rust的模块系统,我学习了如何通过pub关键字控制模块的可见性,并使用use语句引入外部模块,逐步掌握了Rust的模块化管理和命名空间管理技巧。

通过操作HashMap,我加深了对哈希表这种数据结构的理解。尤其是在函数间传递哈希表时,我学习了如何处理生命周期问题,确保数据在访问时的安全性。在错误处理方面,我通过Option和Result类型的应用,掌握了Rust中优雅的错误处理机制,学习了如何通过模式匹配有效地捕捉和处理错误。

在学习泛型和性状时,我认识到泛型使得Rust的代码更加灵活和可复用,而性状则赋予了类型更多的行为定义能力。通过实现和使用性状,我体会到了Rust的面向对象编程思想与函数式编程思想的结合。生命周期的学习使我更清晰地理解了Rust的内存管理机制,特别是在避免悬空引用和内存泄漏方面,通过生命周期注解,我能够精确控制数据的有效期,确保内存的安全使用。

通过对迭代器和智能指针(如Rc、Arc、Box)的学习,我掌握了Rust如何高效地处理集合数据和内存管理,尤其是智能指针帮助我理解了如何管理共享内存和避免内存泄漏的问题。最后,宏的学习让我认识到宏在Rust中的重要性,它不仅简化了代码,还提高了代码的复用性和灵活性。多线程编程部分则让我进一步理解了Rust的线程模型,学会了如何在保证数据安全的前提下,进行并发操作。

总结来说,通过本次实验,我不仅强化了对Rust基础概念的理解,还深入学习了Rust在内存管理、类型系统以及并发编程方面的独特设计。通过实验中的实际操作,我能够更熟练地使用Rust编写健壮、高效的代码,进一步提升了我的编程能力。

第二阶段实验总结

引言

在操作系统的开发过程中,系统调用是操作系统与用户程序之间的接口,负责提供底层的服务与功能。在本次操作系统实验中,我们实现了几个核心系统调用,包括任务信息查询、内存映射、进程创建等功能。通过实现这些系统调用,我们可以深入理解操作系统的基本原理,如进程管理、内存管理和调度机制。此外,我们还探讨了如何利用不同的调度算法优化任务调度,尤其是通过实现 Stride 调度算法来确保系统中各个进程能够公平地获得 CPU 时间。本文将详细介绍这些系统调用的设计与实现思路。

任务信息查询:sys_task_info

sys_task_info 系统调用的主要目的是提供关于当前正在运行的任务的详细信息。每当操作系统需要调试或监控任务时,可以通过调用这个系统调用来获取相关的任务状态、系统调用次数和任务运行时间等信息。操作系统维护每个进程的相关数据,包括进程的状态、系统调用的计数和执行时间等,而这些信息对于开发人员调试系统、分析性能至关重要。

为了实现 sys_task_info,我们首先需要获取当前进程的相关信息。这通常通过存储在进程控制块(PCB)中的数据实现,PCB 记录了每个进程的状态、CPU 寄存器的值、已执行时间以及系统调用计数等信息。当用户或系统调用 sys_task_info 时,操作系统会返回当前任务的这些信息,包括任务的运行状态(如就绪、运行、等待等),系统调用的数量,以及进程自启动以来已经占用的 CPU 时间。通过这些信息,开发人员可以判断进程的执行状态,分析是否存在性能瓶颈或资源争用等问题。

内存映射与取消映射:sys_mmap 和 sys_munmap

在现代操作系统中,虚拟内存是每个进程独立的内存空间,而物理内存则是实际存在的硬件资源。为了有效地利用物理内存,操作系统采用虚拟内存与物理内存之间的映射机制。sys_mmap 系统调用的功能是将虚拟地址空间映射到物理内存上。通过 mmap,操作系统可以将某个文件的内容映射到进程的虚拟内存中,从而让程序可以像访问内存一样直接访问文件数据,而不需要每次都通过传统的 I/O 操作。

在实现 sys_mmap 时,操作系统首先检查请求的虚拟地址是否有效,并验证内存区域是否已经被映射。如果没有冲突,操作系统将通过页表将虚拟地址映射到物理地址。这需要操作系统处理页表的更新,并确保映射区域的权限设置正确。例如,映射的内存区域可能是可读、可写或可执行,操作系统需要为每个映射区域设置合适的访问权限,以避免非法访问或数据损坏。

与 sys_mmap 相对的 sys_munmap 系统调用则负责取消已经映射的虚拟内存区域。当进程不再需要某段内存时,可以调用 munmap 来解除映射。操作系统需要确保取消映射时,虚拟地址没有其他进程在使用,同时也需要回收该内存区域所占用的物理资源。为了实现这一点,操作系统会更新页表,释放相关的物理内存,并将其标记为可重用。通过这种方式,操作系统能够有效管理内存资源,避免内存泄漏和浪费。

进程创建:sys_spawn

进程创建是操作系统中非常重要的一部分功能。通过 sys_spawn 系统调用,操作系统可以根据用户给定的程序路径创建一个新的进程,并将该进程添加到调度队列中。进程创建的过程涉及多个步骤,包括路径验证、程序加载、内存分配和任务调度等。

在实现 sys_spawn 时,操作系统首先需要验证用户提供的程序路径是否有效。这意味着操作系统必须能够访问到指定的文件,并确认该文件是一个有效的可执行文件。接着,操作系统会为新进程分配一个进程控制块(PCB),用于保存该进程的状态、寄存器信息、内存映射、文件描述符等关键数据。然后,操作系统将程序的内容加载到新进程的虚拟内存中,并为其分配栈、堆等内存区域。

一旦新进程的资源分配完成,操作系统会将其添加到调度队列中,等待 CPU 的调度。此时,进程已经具备了执行的基本条件,可以在操作系统的控制下执行。在实际的操作系统中,进程的创建还会涉及到权限管理、父子进程关系的维护以及资源继承等问题,这些都是确保系统稳定和安全运行的关键部分。

Stride 调度算法

进程调度是操作系统中的一个核心任务,关系到系统性能和资源利用率。Stride 调度算法是一种基于权重的调度策略,旨在通过分配不同的权重来实现不同进程之间的公平调度。在 Stride 调度中,每个进程被分配一个 stride 值,该值与进程的优先级相关,优先级较高的进程将获得较小的 stride 值,而优先级较低的进程将获得较大的 stride 值。每个进程在执行时消耗一定的 stride,当它的 stride 值达到一定阈值时,该进程就会被调度执行。

Stride 调度算法的优点在于,它能够在多任务环境下有效地保证进程之间的公平性。每个进程的调度机会与其 stride 值成反比,这意味着优先级较高的任务会被调度得更频繁,而优先级较低的任务则会较少获得 CPU 时间。每当一个进程被调度执行后,操作系统会更新该进程的 stride 值,使得其调度机会逐渐减少,从而避免了高优先级进程过度占用 CPU 资源的问题。

通过实现 Stride 调度算法,操作系统能够根据每个进程的优先级动态地调整其调度频率。高优先级的任务能够更快速地完成,而低优先级的任务则能够平衡获得一定的执行时间,避免了优先级反转和过度竞争 CPU 的情况。这种方法提高了系统资源的使用效率,同时也保持了调度的公平性。

结语

本次操作系统实验通过实现多个核心功能,深入探讨了系统调用的原理与实现方法。通过任务信息查询、内存映射与取消映射、进程创建等功能的实现,我们不仅加深了对操作系统基本原理的理解,也锻炼了我们如何设计和实现高效的内核功能。同时,Stride 调度算法的实现则帮助我们理解了操作系统如何管理进程的调度和资源分配,以保证公平性和系统性能。

这些操作系统的核心机制为我们未来开发更复杂、更高效的操作系统打下了坚实的基础。在实际的操作系统开发过程中,继续优化调度算法、内存管理、进程调度等底层功能,是提高操作系统性能、稳定性和可扩展性的关键。通过这次实验,我们不仅掌握了这些技术的实现方法,还为我们在更大规模的操作系统设计中奠定了理论基础。


2024 秋冬季开源操作系统训练营第三阶段总结 - 卓堂越

通过第三阶段的学习,我深入理解了组件化操作系统内核的设计理念。这种思想强调以模块化方式构建内核,能够根据实际需求增量式地扩展功能,从而在不同场景下灵活构建各种模式的内核。具体而言,这种方法能够带来以下显著优势:

  1. 提高开发效率:模块化设计减少了重复工作,使开发者可以快速实现复杂功能。
  2. 降低维护难度:各模块间解耦降低了修改与调试的成本。
  3. 促进功能复用与协作:组件化方法支持功能模块的复用与团队协作开发。

学习成果回顾

第一周
学习了 Unikernel 的增量开发方法。从一个简单的内核开始,逐步扩展了文件系统等模块。同时,完成了基础设施建设,包括实现 HashMap 和简单的内存分配算法,并掌握了终端控制的技巧。

第二周
通过组件化设计,将 Unikernel 扩展为 Monolithic Kernel。深入学习了 RISC-V 架构,以及 Arceos 中的线程控制设计。除此之外,我还完成了缺页异常处理,并实现了基本的 Unix 工具功能。

第三周
了解了虚拟化的基本原理,并基于模块化方法为 Arceos 添加了虚拟化支持。具体包括虚拟设备接口和多虚拟机支持,同时优化了系统性能与架构设计。

收获与展望

本阶段的学习让我切身感受到组件化设计在操作系统开发中的强大优势。通过将复杂问题拆解为模块,开发变得更加高效,系统也更易于维护。未来,我希望能将这一思想应用于更多实际项目中,持续提升内核开发能力,打造高效且可靠的系统。


从小白到操作系统开发者:我的训练营历程与成长

参加训练营已经快一年了,回顾这段时间的学习与实践,感觉收获满满,成长也非常明显。虽然过程中经历了不少挑战,但我从中学到了很多,也更加明白了自己未来的目标和方向。

从初识RTOS和操作系统

在训练营的第一阶段,我还是一个对RTOS(实时操作系统)了解甚少的“小白”。当时,我的理解仅限于知道 FreeRTOS 是什么,而对于操作系统的具体结构和工作原理几乎没有任何概念。然而,通过这段时间的学习,我开始接触并逐步理解操作系统的基本组成部分,像是内核、调度、进程管理等。这个阶段的学习让我明白了操作系统不仅仅是运行应用程序的基础,更是硬件和软件之间的重要桥梁。

网络问题与任务挑战

不过,学习的过程并不是一帆风顺的。由于网络不稳定,很多简单的任务总是上传不了,这让我有时感到非常沮丧。更有一次,我因为任务时间限制和一些技术难题,没能在结课期间按时完成所有的任务。这些问题让我认识到,技术的实现不仅仅依赖于个人的能力,还需要更好的时间管理和稳定的技术环境支持。

深入探索异步编程与Python适配

进入训练营的第二阶段后,任务的难度逐步增加。我选择了一个相对较简单的方向,与其他小伙伴们一起研究 异步编程。虽然这与我之前的经验较为接近,但在实际实现过程中,我还是遇到了不少挑战,尤其是在理解异步编程模型时。

然而,通过逐步的实现,我不仅加深了对异步编程的理解,还接触了Python适配的相关知识。实际上,这个阶段让我学到了很多之前没有涉及的技术,这些新知识极大地丰富了我的技术栈,也让我对未来的技术方向更加清晰。

Python与OpenCV的结合

尽管我没有完全按预期完成所有任务,但这个阶段让我深入思考了自己的学习方法。我曾经盲目追求高难度的任务,而忽略了任务的实际意义和自己的能力匹配。因此,在这个阶段,我主动选择了一个相对简单的任务——OpenCV 的相关实践。尽管我最终未能在 Starry 上完成OpenCV的测例,但这个过程让我更加明白了如何进行项目规划和任务分配。

在这阶段,我还负责了Python与OpenCV的结合,进行了一些与图像处理相关的实验和项目。通过这些实践,我深入了解了Python的图像处理能力,尤其是OpenCV库在计算机视觉中的应用。例如,如何使用OpenCV进行图像读取、处理和展示,这些操作帮助我了解了计算机如何通过视觉来感知和分析信息。

实现Python3.11的syscall系统调用

作为实习任务的一部分,我参与了分析和实现支持 Python3.11 程序的 syscall 系统调用,尤其是在 ArceOS/Starry 系统中,逐步完善Python程序所依赖的系统调用。具体来说,这个过程涉及了用户态程序的交叉编译、依赖库的交叉编译、以及系统模拟器 Qemu 中的实验。

  1. 交叉编译Python程序:首先,我需要交叉编译 Python3.11,以支持 aarch64 架构。这包括了编译所需的依赖库(如 libffi、zlib、libuuid 和 xz 等),并且每个依赖库都必须交叉编译,以保证在目标架构上能够正常运行。

  2. Qemu模拟环境:为了测试在交叉编译后的Python程序,我在 Qemu 模拟环境中运行了一个 aarch64 架构的 Alpine Linux,并在其中加载了交叉编译生成的Python库。通过这种方式,我能够测试并调试系统调用,确保它们能够在模拟器中正常执行。

  3. 系统调用分析:我使用 strace 工具来统计Python程序所使用的所有系统调用,并分析它们在不同架构下的表现。通过这个过程,我深入了解了 syscall 的工作机制,并能够在实际操作系统中正确实现这些调用。

通过这个任务,我不仅加深了对操作系统内核和系统调用机制的理解,还在实践中学会了如何处理复杂的交叉编译任务。

未来的目标–操作系统与编译器

回顾这一年的学习,我不仅了解了操作系统的基本原理,还在逐步实现的过程中积累了不少经验。尤其是从一个仅仅知道FreeRTOS的小白,到如今能够理解操作系统结构的程度,我感到自己有了明显的进步。

最令我兴奋的是,未来我希望能够在自己写的操作系统上运行自己开发的编译器。这是我一直以来的梦想,虽然这需要我不断努力和学习,但我相信,通过这段时间的积累,我已经打下了坚实的基础。

总结

参加训练营的这一年里,我收获了很多,不仅有热心的助教和同学的帮助,还有机会接触到多种新技术和工具。虽然遇到了一些困难,但这些都成为了我成长的动力。我相信,未来我会继续沿着这个方向前行,实现自己在操作系统和编译器领域的梦想。


2024 秋冬季开源操作系统训练营

导学阶段

这个阶段主要是介绍 linux 和 github的基本操作。

基础阶段-Rust 编程

在这个阶段,学员将深入学习 Rust 编程语言的基础知识和高级特性。主要内容包括 Rust 的语法结构、内存管理机制、并发编程和错误处理等。

笔记:

Rust编程 基础知识

梳理后

变量与可变性:

使用 let 声明变量

let x = 5;

默认不可变(一旦赋值,不可修改)

意义:防止意外的数据修改和并发问题

如何可变?使用 mut 关键字

let mut x = 5;

常量声明

使用 const 而不是 let

声明值只能为 常量表达式

(即,不可以是只能在程序运行时才能计算出的值)

const THREE_HOURS_IN_SECONDS: u32 = 60 * 60 * 3;

基本数据类型-原生类型(primitives)

标量类型

有符号整数 (signed integers) : i8, i16, i32, i64, i128 和 isize (指针宽度)

无符号整数 (unsigned integers) : u8

浮点数 (floating point): f32, f64

char (字符) : 单个 Unicode 字符,如 ‘a’

bool (布尔型) : 只能是 true 或 false

单元类型 (unit type) : ()。

复合类型

数组 (array) : 如 [1, 2, 3]

元组 (tuple) : 如 (1, true)

元组 (tuple)

把一个或多个其他类型的值组合进一个复合类型

长度固定(声明后长度不变)

let tup: (i32, f64, u8) = (500, 6.4, 1);

如何获取单个值?

  1. 使用点号 (.) 加值的索引

  2. 使用模式匹配 (pattern matching) 来解构 (destruction) 元组值

    1
    2
    3
    let tup = (500, 6.4, 1);
    let (x, y, z) = tup;
    println!("The value of y is: {y}");

数组 (array)

在栈上分配,单个内存块

声明

  1. 直接声明

    1
    let a = [1, 2, 3, 4, 5];
  2. 指定元素类型和元素数量

    1
    let a: [i32; 5] = [1, 2, 3, 4, 5];
  3. 指定初始值和元素个数

    1
    let a = [3; 5];

使用

使用索引来访问

函数

声明

使用 fn 关键字来声明

1
2
3
4
5
6
7
fn main() {
println!("Hello, world!");
another_function();
}
fn another_function() {
println!("Another function.");
}

if 表达式

loop 循环

循环标签

改变 break 或 continue 的作用对象

while 循环

for 循环

所有权概念

变量作用域与变量隐藏

函数参数的所有权

函数返回值

引用与借用

可变引用

String

String slice

结构体

元组结构体

Vector

定义

可变长数组,只能存储相同类型的值

使用

Vec::new() 可以新建空 vector

1
2
let v: Vec<i32> = Vec::new();
//这个 Vec<i32> 可以不加

vec! 宏,会根据我们提供的值来创建一个新的 vector

1
let v = vec![1, 2, 3];

使用 push 可以向 vector 中增加元素

hashmap

定义

HashMap<K, V> 类型储存了一个键类型为 K 对应一个值类型为 V 的映射

其通过一个 哈希函数(hashing function)来实现映射,决定如何将键和值放入内存中

使用

可以使用 new 来创建

使用 insert 增加元素

使用 get 方法来从 hashmap 中获取值

1
2
3
4
use std::collections::HashMap;
let mut scores = HashMap::new();
scores.insert(String::from("Blue"), 10);
scores.insert(String::from("Yellow"), 50)

第二节

枚举 enum

枚举 Option

定义

1
2
3
4
enum Option<T>{
None,
Some(T),
}

使用

用 unwrap() 获取内部值

作用域 scope

就是作用范围吧

同一个作用域不能有两个相同名称的项 → C++ 中的变量名冲突

(可以使用一下工具来解决名称冲突???)

模块系统 the module system

模块系统可以将 crate 中的代码分组和封装,提高可读性和重用性

包 Packages

Cargo 的一个功能,允许构建、测试和分享 crate

包是提供一系列功能的一个或者多个 crate , 包含一个 Cargo.toml 文件

Crates

一个模块的树形结构,它形成了库或二进制项目

crate 是 Rust 在编译时最小的代码单位,有两种形式:二进制项和库

crate root 是一个源文件,是 crate 的根模块

crate 的约定

src/main.rs 是一个与包同名的二进制 crate 的 crate 根

src/lib.rs 是一个与包同名的库 crate 的 crate 根

src/bin 目录下的每个文件都会被编译成一个独立的二进制 crate

模块 Modules 和 use

允许你控制作用域和路径的私有性

use 关键字

可以在一个作用域内创建一个项的快捷方式,减少长路径的重复

类似于 Java 的导包?

as 关键字

配合 use 使用,就是给快捷方式重命名

一些调用项的方式

1
2
3
4
5
6
//例如 xxx 模块的 yyy 子模块下定义了一个 zzz
crate::xxx::yyy::zzz;

use crate::xxx::yyy::zzz;//之后就可以直接使用 zzz 了

use crate::xxx::yyy::zzz as z;

私有和公有

默认所有内容私有

pub 关键字

可以将模块或模块内的项标记为公开的

模块树

crate 根文件 (src/lib.rs 或 src/main.rs) 是 crate 模块结构的根,也是名为 crate 的隐式模块的根

在 crate 根文件中,可以声明新的模块

使用 mod 关键字和花括号或分号

1
2
3
mod a_module {
//something...
}

如何寻找

内联(以大括号结尾时)

在文件 src/xxx.rs

在文件 src/xxx/mod.rs

在其它文件中,可以定义子模块

使用 mod 关键字和花括号或分号,并在以父模块命名的目录中寻找子模块代码

模块树可以用来展示 crate 中的模块层次结构,以及模块之间的父子和兄弟关系

路径 path

一个命名项(结构体、函数或模块等)的方式

绝对路径 absolute path

以 crate 根 (root) 开头的全路径

对于外部 crate 的代码,是以 crate 名开头的绝对路径

对于当前 crate 的代码,则以字面值 crate 开头

相对路径 relative path

从当前模块开始,以 self, super 或当前模块的标识符开头

绝对路径和相对路径都后跟一个或多个由双冒号分割的标识符

专业阶段- OS设计实现

第三章:多道程序与分时多任务系统

ch3 要求我们完成的任务具体要求如下:

  • 实现系统调用 sys_task_info,系统调用号为 410
  • 该系统调用需要返回当前任务的以下信息:
    • 任务状态(必定为 Running)
    • 任务使用的系统调用及其调用次数
    • 系统调用时刻距离任务第一次被调度时刻的时长(单位ms)
  • 使用 TaskInfo 结构体来存储这些信息
  • 系统调用成功时返回 0,失败时返回 -1
  • 注意:调用 sys_task_info 本身也会被计入系统调用次数

思路:

sys_task_info 需要三个信息,我们一个一个来,

任务状态:第一个是任务状态,这个实现起来比较简单,甚至因为在这个系统里,查询的是当前任务的状态,因此 TaskStatus 一定是 Running。

系统调用时刻距离任务第一次被调度时刻的时长:我们需要的这个时长等于 当前时刻减去第一次被调度的时刻,当前时刻很好获取,利用get_time_ms()函数就可以直接获取,而另外一个 则需要为任务控制块添加新的字段 ,用于记录第一次被调度的时长,这样我们就可以通过任务管理器直接地获取某任务初次调用时刻了。

任务使用的系统调用及其调用次数:我的方法和提示里给出地方法相同 因为系统调用号一定小于 500,所以直接使用一个长为 MAX_SYSCALL_NUM=500 的数组做桶计数。同样也直接在 任务控制块中添加 数组,实现把各个任务的系统调用次数数组与该任务绑定。在此之后,我们直接到系统调用前syscall/mod.rs:syscall 增加相应任务的相应系统调用类型的调用次数即可。

最后我们直接创建一个TaskInfo类型保存如上三种数据,并利用sys_task_info中的*mut类型参数,把Taskinfo的内容传回用户态即可完成该功能。

总的来说作为第一个任务,用来熟悉内核编程,还算比较简单。

问答题-lab1

第四章:地址空间

ch4要求我们完成的具体内容如下:

重写 sys_get_time 和 sys_task_info
引入虚存机制后,原来内核的 sys_get_time 和 sys_task_info 函数实现就无效了。请你重写这个函数,恢复其正常功能。
mmap 和 munmap 匿名映射 mmap 在 Linux 中主要用于在内存中映射文件, 本次实验简化它的功能,仅用于申请内存。
请实现 mmap 和 munmap 系统调用,mmap 定义如下: fn** sys_mmap(start: usize, len: usize, port: usize) -> isize - syscall ID:222 - 申请长度为 len 字节的物理内存(不要求实际物理内存位置,可以随便找一块),将其映射到 start 开始的虚存,内存页属性为 port
参数:
start 需要映射的虚存起始地址,要求按页对齐
len 映射字节长度,可以为 0
port:第 0 位表示是否可读,第 1 位表示是否可写,第 2 位表示是否可执行。其他位无效且必须为 0
返回值:执行成功则返回 0,错误返回 1
说明: 为了简单,目标虚存区间要求按页对齐,len 可直接按页向上取整,不考虑分配失败时的页回收。
可能的错误: start 没有按页大小对齐 - port & !0x7 != 0 (port 其余位必须为0) - port & 0x7 = 0 (这样的内存无意义) - [start, start + len) 中存在已经被映射的页 - 物理内存不足

思路:

我们先说sys_get_time和sys task_info 这两个函数的重写:

首先我们来说说为什么这两个函数会失效,在ch3中我们的系统调用 利用*mut类型指针来将数据直接地写入用户态中的地址,但是在ch4中,我们将用户态和内核态都分别做了不同的地址映射,这导致我们没办法像ch3那样直接利用_ts来写入数据,因为ch4中传入的是用户态中的虚拟地址,必须借助页表机制,将虚拟地址转换为物理地址,来修改。获取 time 和 TaskInfo的步骤和之前ch3中提到的方式类似。

需要注意的是,我们写入的数据结构可能存在如下所示的跨页的问题,

/// YOUR JOB: get time with second and microsecond /// HINT: You might reimplement it with virtual memory management. /// HINT: What if [TimeVal] is splitted by two pages ?

所以我们不能把数据一次性全部写入,这里我选择的办法是将数据转换为字节数组 并依次写入。

mmap和unmmap:

首先来说mmap:

mmap需要实现的是将一段虚拟地址进行页面映射,想要实现这个功能,我们需要在进程的地址空间中加入添加新的页面映射,而该系统正好提供了为地址空间提供了insert_framed_area方法,用于插入新的逻辑段,这样的话情况就会变得很简单。

首先我们根据可能的错误对函数给出的参数进行对应的判断,并且通过port得到MapPermission。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
if _start % PAGE_SIZE != 0 || _port & !0x7 != 0 || _port & 0x7 == 0 {
return -1;

}
let portpomis = Portpomiss::from_bits_truncate(_port as u8);
let mut flag:MapPermission=MapPermission::empty();
flag|=MapPermission::U;
if portpomis.contains(Portpomiss::R){
flag|=MapPermission::R;
}
if portpomis.contains(Portpomiss::W){
flag|=MapPermission::W;
}
if portpomis.contains(Portpomiss::X){
flag|=MapPermission::X;
}

之后我们检查虚拟页面是否已经被映射过

1
2
3
4
5
6
7
for vpn in vpn_range {
if let Some(pte) = inner.tasks[cur].memory_set.translate(vpn) {
if pte.is_valid() {
return -1;
}
}
}

最后我们直接添加页面映射

inner.tasks[id].memory_set.insert_framed_area(_start, _end, port);

问答题-lab2

第五章:进程及进程管理

ch5要求我们具体完成的内容如下:

spawn 系统调用定义( 标准spawn看这里 ):

`fn sys_spawn(path: *const u8) -> isize`

  • syscall ID: 400
  • 功能:新建子进程,使其执行目标程序。
  • 说明:成功返回子进程id,否则返回 -1。
  • 可能的错误:
    • 无效的文件名。
    • 进程池满/内存不足等资源错误。

TIPS:虽然测例很简单,但提醒读者 spawn 不必 像 fork 一样复制父进程的地址空间。

stride 调度算法

算法描述如下:

(1) 为每个进程设置一个当前 stride,表示该进程当前已经运行的“长度”。另外设置其对应的 pass 值(只与进程的优先权有关系),表示对应进程在调度后,stride 需要进行的累加值。

  1. 每次需要调度时,从当前 runnable 态的进程中选择 stride 最小的进程调度。对于获得调度的进程 P,将对应的 stride 加上其对应的步长 pass。
  2. 一个时间片后,回到上一步骤,重新调度当前 stride 最小的进程。

可以证明,如果令 P.pass = BigStride / P.priority 其中 P.priority 表示进程的优先权(大于 1),而 BigStride 表示一个预先定义的大常数,则该调度方案为每个进程分配的时间将与其优先级成正比。证明过程我们在这里略去,有兴趣的同学可以在网上查找相关资料。

其他实验细节:

  • stride 调度要求进程优先级 ≥2,所以设定进程优先级 ≤1 会导致错误。
  • 进程初始 stride 设置为 0 即可。
  • 进程初始优先级设置为 16。

为了实现该调度算法,内核还要增加 set_prio 系统调用

思路:

我们先说spawn系统调用:

就如同TIPS一样,我们不需要复制父进程的地址空间,

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
pub fn sys_spawn(_path: *const u8) -> isize {
trace!(
"kernel:pid[{}] sys_spawn NOT IMPLEMENTED",
current_task().unwrap().pid.0
);
let current_task = current_task().unwrap();
let token =current_user_token();
let path = translated_str(token, _path);
let tcb=Arc::new(TaskControlBlock::new(get_app_data_by_name(path.as_str()).unwrap()));
let mut inner=tcb.inner_exclusive_access();
let mut pin=current_task.inner_exclusive_access();
inner.parent=Some(Arc::downgrade(&current_task));
pin.children.push(tcb.clone());
drop(inner);
let pid = tcb.pid.0 as isize;
add_task(tcb);
pid
}

我们直接用 app_data来创建TaskControlBlock而跳过了复制父进程的地址空间,并将他连接到父进程的子进程上,这样才能在sys_waitpid中被遍历到。然后把他加入任务管理器。就可以通过测试。

stride 调度算法:

时间原因暂未实现..

问答题-lab3

第六章:文件系统与I/O重定向

ch6要求我们具体完成的内容如下:

硬链接

硬链接要求两个不同的目录项指向同一个文件,在我们的文件系统中也就是两个不同名称目录项指向同一个磁盘块。

本节要求实现三个系统调用 sys_linkat、sys_unlinkat、sys_stat 。

linkat:

syscall ID: 37功能:创建一个文件的一个硬链接, linkat标准接口 。C接口: int linkat(int olddirfd, char* oldpath, int newdirfd, char* newpath, unsigned int flags)Rust 接口: fn linkat(olddirfd: i32, oldpath: *const u8, newdirfd: i32, newpath: *const u8, flags: u32) -> i32参数:olddirfd,newdirfd: 仅为了兼容性考虑,本次实验中始终为 AT_FDCWD (-100),可以忽略。flags: 仅为了兼容性考虑,本次实验中始终为 0,可以忽略。oldpath:原有文件路径newpath: 新的链接文件路径。说明:为了方便,不考虑新文件路径已经存在的情况(属于未定义行为),除非链接同名文件。返回值:如果出现了错误则返回 -1,否则返回 0。可能的错误链接同名文件。

unlinkat:

syscall ID: 35功能:取消一个文件路径到文件的链接, unlinkat标准接口 。C接口: int unlinkat(int dirfd, char* path, unsigned int flags)Rust 接口: fn unlinkat(dirfd: i32, path: *const u8, flags: u32) -> i32参数:dirfd: 仅为了兼容性考虑,本次实验中始终为 AT_FDCWD (-100),可以忽略。flags: 仅为了兼容性考虑,本次实验中始终为 0,可以忽略。path:文件路径。说明:注意考虑使用 unlink 彻底删除文件的情况,此时需要回收inode以及它对应的数据块。返回值:如果出现了错误则返回 -1,否则返回 0。可能的错误文件不存在。

fstat:

syscall ID: 80功能:获取文件状态。C接口: int fstat(int fd, struct Stat* st)Rust 接口: fn fstat(fd: i32, st: *mut Stat) -> i32参数:fd: 文件描述符st: 文件状态结构体#[repr(C)]
#[derive(Debug)]
pub struct Stat {
/// 文件所在磁盘驱动器号,该实验中写死为 0 即可 pub dev: u64,
/// inode 文件所在 inode 编号 pub ino: u64,
/// 文件类型 pub mode: StatMode,
/// 硬链接数量,初始为1 pub nlink: u32,
/// 无需考虑,为了兼容性设计 pad: [u64; 7],
}

/// StatMode 定义:bitflags! {
pub struct StatMode: u32 {
const NULL = 0;
/// directory const DIR = 0o040000;
/// ordinary regular file const FILE = 0o100000;
}
}

我们先来实现fstat:

fstat需要我们先得到三个位置信息分别是

/// inode 文件所在 inode 编号 pub ino: u64,
/// 文件类型 pub mode: StatMode,
/// 硬链接数量,初始为1 pub nlink: u32,

inode 文件所在 inode 编号:

在rcore系统的内核中,似乎没有提供能直接从OSinode得到inode id的接口,所以有两种办法,一种是去修改Easy-fs,另有一种方法是在OSinode被创建的时候给他们分配id。在这里我使用的是后者。

在OSinode结构体中添加如下结构体

pub struct Ino{ link:u32, ino:u64, }

然后再每次打开文件之后对OSinode 使用一个bitmap来分配 id,在文件关闭时用bitmap来回收id;

bitmap在 easyfs中的bitmap.rs有相应实现。我们只需要利用bitmap的alloc和dealloc来实现id的分配和回收。

其中文件类型,可以通过使用 read_disk_inode 获取 inode 对应的 DiskInode 的只读引用,并从中读取相关信息即可。

最后是硬链接数量,该信息显然需要结合link 与 unlink来维护,我们在link时通过刚刚所分配的id,来进行映射即可

ITOS.get_mut(&op).unwrap().link+=1;

ps:ITOS是一个BTreeMap 可以通过文件名来获取或者修改对应的 Ino结构体。

我们再来实现link与unlink:

首先我们刚刚已经为文件进行了id的分配,我们继续利用先前所分配的id,进行管理。

首先我储存了新的名字和磁盘块原名之间的映射,在文件open与close前,将输入的名字(如果已经被映射)替换为原名来实现两个不同名称目录项指向同一个磁盘块。

如下:

1
2
3
4
5
6
7
8
9
10
11
if unsafe {
UMAP2.contains_key(&path1)
}{
{
path = unsafe { UMAP2 [&path1].clone()};

}
}
else {
path =path1;
}

unlink的逻辑也与link类似,通过用BTreeMap的remove方法将映射删除。
但是要特别注意的是,当link为0时,我们需要回收inode id

1
2
3
4
5
6
7
8
9
10
11
let  c= unsafe { ITOS .get_mut(&name).unwrap()};
if c.link>0{
c.link-=1;
}
else{
let fd=unsafe { UMAP1.get(&name).unwrap() };
let bind=current_task().unwrap();
let inner=bind.inner_exclusive_access().fd_table[*fd].clone().unwrap();
inner.clear();

}

向前兼容:

唯一要注意的点就是在spawn 中,我们需要用ch6新建立的文件系统来获取应用数据,而不是像ch4一样用translated_str方法直接获取应用数据。

let Some(app_inode) = open_file(path.as_str(), OpenFlags::RDONLY)

向前兼容的其他方面都与先前类似。

问答题-lab4

第八章:并发

ch8要求我们具体完成的内容如下:

死锁检测

目前的 mutex 和 semaphore 相关的系统调用不会分析资源的依赖情况,用户程序可能出现死锁。 我们希望在系统中加入死锁检测机制,当发现可能发生死锁时拒绝对应的资源获取请求。 一种检测死锁的算法如下:

定义如下三个数据结构:

  • 可利用资源向量 Available :含有 m 个元素的一维数组,每个元素代表可利用的某一类资源的数目, 其初值是该类资源的全部可用数目,其值随该类资源的分配和回收而动态地改变。 Available[j] = k,表示第 j 类资源的可用数量为 k。
  • 分配矩阵 Allocation:n * m 矩阵,表示每类资源已分配给每个线程的资源数。 Allocation[i,j] = g,则表示线程 i 当前己分得第 j 类资源的数量为 g。
  • 需求矩阵 Need:n * m 的矩阵,表示每个线程还需要的各类资源数量。 Need[i,j] = d,则表示线程 i 还需要第 j 类资源的数量为 d 。

算法运行过程如下:

  1. 设置两个向量: 工作向量 Work,表示操作系统可提供给线程继续运行所需的各类资源数目,它含有 m 个元素。初始时,Work = Available ;结束向量 Finish,表示系统是否有足够的资源分配给线程, 使之运行完成。初始时 Finish[0..n-1] = false,表示所有线程都没结束;当有足够资源分配给线程时, 设置 Finish[i] = true。
  2. 从线程集合中找到一个能满足下述条件的线程

1Finish[i] == false; 2Need[i,j] ≤ Work[j];

若找到,执行步骤 3,否则执行步骤 4。

  1. 当线程 thr[i] 获得资源后,可顺利执行,直至完成,并释放出分配给它的资源,故应执行:

1Work[j] = Work[j] + Allocation[i, j]; 2Finish[i] = **true**;

跳转回步骤2

  1. 如果 Finish[0..n-1] 都为 true,则表示系统处于安全状态;否则表示系统处于不安全状态,即出现死锁。

出于兼容性和灵活性考虑,我们允许进程按需开启或关闭死锁检测功能。为此我们将实现一个新的系统调用: sys_enable_deadlock_detect 。

enable_deadlock_detect:

  • syscall ID: 469
  • 功能:为当前进程启用或禁用死锁检测功能。
  • C 接口: int enable_deadlock_detect(int is_enable)
  • Rust 接口: fn enable_deadlock_detect(is_enable: i32) -> i32
  • 参数:
    • is_enable: 为 1 表示启用死锁检测, 0 表示禁用死锁检测。
  • 说明:
    • 开启死锁检测功能后, mutex_lock 和 semaphore_down 如果检测到死锁, 应拒绝相应操作并返回 -0xDEAD (十六进制值)。
    • 简便起见可对 mutex 和 semaphore 分别进行检测,无需考虑二者 (以及 waittid 等) 混合使用导致的死锁。
  • 返回值:如果出现了错误则返回 -1,否则返回 0。
  • 可能的错误
    • 参数不合法
    • 死锁检测开启失败

思路:

要为锁机制实现死锁检测,关键在于如何维护相关状态,并在检测前构造出合适的资源分配结构。我们可以从mutex开始:每个线程最多只需要一把锁,因为线程只有在获取所需的锁资源后才能继续执行,若没有锁资源可用,线程将会被阻塞。因此,为每个线程分配一个 mutex_need 变量,用来记录当前线程所需的锁的 id。

除此之外,我们还需要维护一个 mutex_allocation 向量,记录线程当前已获得但未释放的锁资源的 id。当线程调用 sys_mutex_lock(mutex_id) 请求锁时,在实际获取锁前,我们将当前线程的 mutex_need 设置为 mutex_id。当线程成功获得锁时,将 mutex_id 加入 mutex_allocation 向量,并将 mutex_need 置为空。这里可以使用 usize::MAX 来表示空值,也可以使用 Option 类型,后者更为优雅。

当线程调用 sys_mutex_unlock(mutex_id) 释放锁时,在实际释放锁前,首先查找并移除 mutex_allocation 向量中对应的 mutex_id 元素。

通过这种方式,我们能够在死锁检测之前,根据维护的信息构建出 Available、Allocation 和 Need 数据结构,进而使用银行家算法判断当前系统是否处于不安全状态。信号量的实现方式大致相同,但由于信号量的数量不再是二值的,因此线程的资源分配向量需要记录每个信号量的数量。我们可以用 <sem_id, cnt> 这样的二元组来表示,或者也可以使用 cnt 个 sem_id 元素。在这里,我采用前者。

此外,信号量还可以为负数,负值的绝对值表示资源的提前“透支”数量。在银行家算法中,Available[i][j] 不应为负值,若出现负数,应视为 0 处理。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
fn deadlock_check(available: Vec<usize>, allocation: Vec<Vec<usize>>, need: Vec<Vec<usize>>) -> bool {
// n: thread count m: resources count
let (n, m) = (allocation.len(), allocation[0].len());
let mut work = available;
let mut finish = vec![false; n];
loop {
let mut idx = usize::MAX;
for i in 0..n {
let mut flag = true;
if finish[i] {
continue;
}
for j in 0..m {
if need[i][j] > work[j] {
flag = false;
break;
}
}
if flag {
idx = i;
break;
}
}
// has found a thread meet the requirement
if idx != usize::MAX {
for j in 0..m {
work[j] += allocation[idx][j];
}
finish[idx] = true;
} else {
break;
}
}
finish.iter().all(|&x| x)
}

问答题-lab5